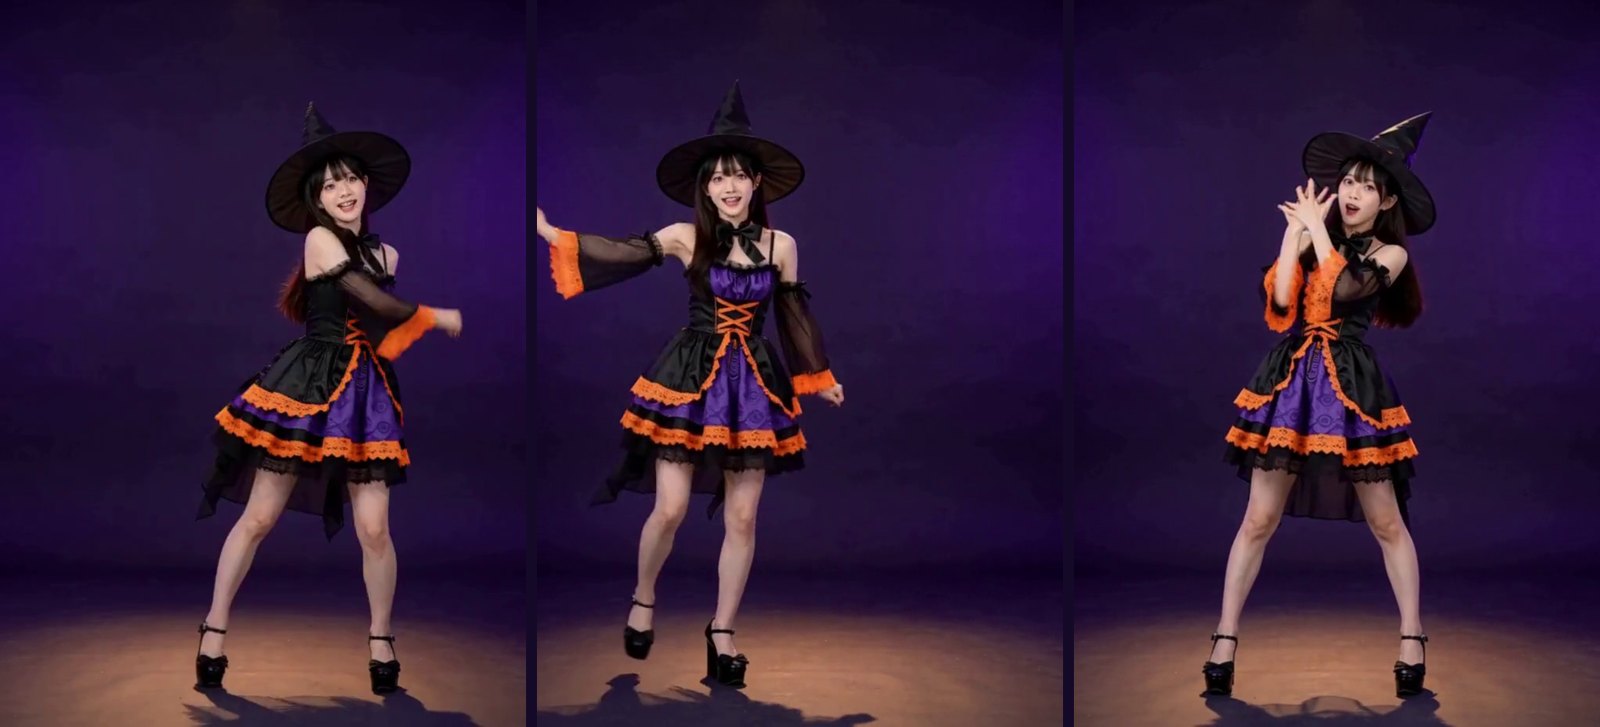
前編は、キャラシートと参照動画まで出来て、参照を読ませた直後にM5 Macが止まったところで終わった。後編は、参照動画を白黒の深度動画に作り替え、デスクトップ(RTX 5060 Ti 16GB×2)で3本焼いた記録。結論から言うと魔女は踊った。ただし1本目は、終盤に魔女が消えて参照の深度画像そのものに戻っていった。
振付: まなこ(本人公開の振付動画を参照にした)
参照動画を白黒の深度動画にした
前編で読ませた参照はカラーの縦動画(540×720)だった。Macが止まった後、負荷を下げる目的で、ChatGPTに相対深度の白黒動画(360×480・24fps・15秒・音声つき)へ変換してもらった。明るいところが手前、暗いところが奥、背景は真っ黒のマスク。
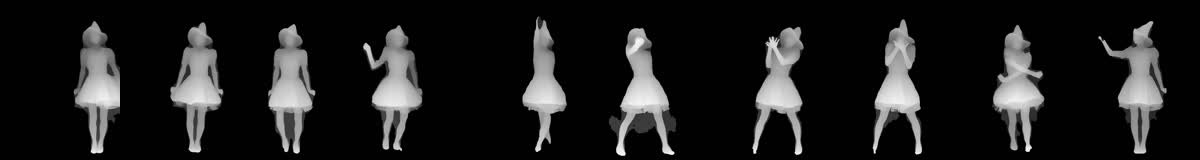
軽くなった理由は色数ではない。H3は参照動画を読むと、白黒でもカラーでもRGB 3チャンネル・float32に展開するので、効くのは画素数×コマ数だ。540×720は約38.9万画素、360×480は約17.3万画素で、これは今までMacで通っていたBlender参照(512×288・約14.7万画素)と同じ級になる。
ところがこの深度動画には、後で分かる副作用があった。
1本目(12ステップ): 10.5秒から魔女が消えていく
プロンプトは、ChatGPTが深度動画用に書き直したもの。<Picture 1>=キャラシートは fully_preserved(そのまま保持)、<Subject 2>=振付は attribute_transfer(動きだけ移す)、<Audio 1>は fully_copy(そのまま複写)。ここまでは前編と同じ考え方で、違いは<Video 1>(深度動画)を「動きと奥行きの手本」と説明しつつ、retention_analysis では fully_preserved にしていたこと。
0.6MP縦(672×928)・15秒・24fps・Turbo LoRA・12ステップ。2枚挿しのH3VMは「双卡后台/100%」。33分08秒で完了した。

9.5秒まではカラーの魔女が踊っている。約10.5秒から人物が半透明になり、約12.25秒から深度参照のような白い人物と黒い背景が優勢になり、13.25秒で衣装の色がほぼ消えた。真っ白な空フレームではなく、参照動画の「見た目」が出力に漏れてきた形だ。
同時に、この本では1枚目のGPUでメモリ確保の失敗警告が1,448行出ていた(処理は続いて完了している)。VRAMの採取最大はGPU0 15.93GiB・GPU1 14.76GiB。
2本目(20ステップ): 4つ同時に変えた
原因はプロンプトの fully_preserved が「深度映像の見た目まで保て」と読まれたことが疑わしいが、メモリ警告も同時に出ていたので、ここで原因を1つに決めるのはやめた。代わりに4つを同時に変えて1本焼いた。
- プロンプト: <Video 1>を weak_reference に変更。「灰色は奥行きの意味で、肌色や透明度ではない」「10〜15秒も冒頭と同じ肌色・衣装・紫の背景を保つ」を明記。
- ステップ: 12→20。
- H3VMの設定: 「双卡扩容/低25%」(容量優先)。2枚目のGPUを計算より容量に使う配分で、MLPの分担は68/32固定、予約は8.28/8.76GiB。
- ComfyUIを再起動してから1本だけ投入。
51分00秒で完了。メモリ確保の失敗警告は0。VRAMの採取最大はGPU0 13.74GiB・GPU1 6.01GiB。そして最後まで肌色・衣装・紫の背景が残った。
4つ同時に変えたので、「20ステップにすれば直る」とも「プロンプトだけが原因だった」とも書けない。1項目ずつ戻す切り分けは、今夜は焼く時間がなかったのでやっていない。
3本目(25ステップ): 同条件でステップだけ上げた
2本目の直後に、同じプロンプト・同じseed・同じH3VM設定のまま、ステップだけ25に上げて焼いた。実行グラフの差分はステップ数の1か所だけ。63分09秒で完了、警告0、VRAM採取最大はGPU0 13.78GiB・GPU1 5.91GiB。
20と25の違いは小さい。指の分離や手が重なる場面の輪郭は一部で読みやすくなった(9.0秒・9.5秒)が、10.875秒の速い動きは両方ともぼける。終盤の色は両方とも保たれていて、25で新たに直ったものはない。それでも見た目の仕上がりは25の方がよかったので、冒頭の動画はこの本にした。
| 1本目 | 2本目 | 3本目 | |
|---|---|---|---|
| ステップ | 12 | 20 | 25 |
| <Video 1>の保持指定 | fully_preserved | weak_reference | weak_reference |
| H3VM | 双卡后台/100% | 双卡扩容/25% | 双卡扩容/25% |
| 所要時間 | 33分08秒 | 51分00秒 | 63分09秒 |
| 1ステップあたり | — | 約141秒(初回約169秒) | 約141秒(初回約168秒) |
| メモリ確保失敗の警告 | 1,448行 | 0 | 0 |
| VRAM採取最大 GPU0/GPU1 | 15.93/14.76GiB | 13.74/6.01GiB | 13.78/5.91GiB |
| 終盤の色 | 深度画像へ戻った | 残った | 残った |
所要時間は秒のまま並べた。1本目と2本目は条件が4つ違うので倍率にはしない。2本目と3本目は同条件で、1ステップあたり約141秒が同じで、ステップが5つ増えた分だけ長くなっている。VRAMはstep内の採取値の最大で、絶対のピークではない。
振付はどこまで追えたか
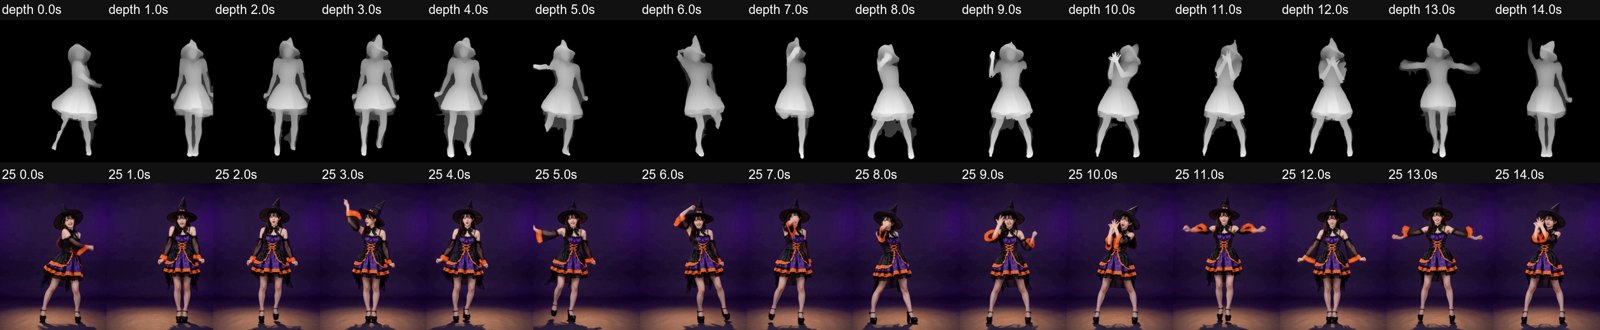
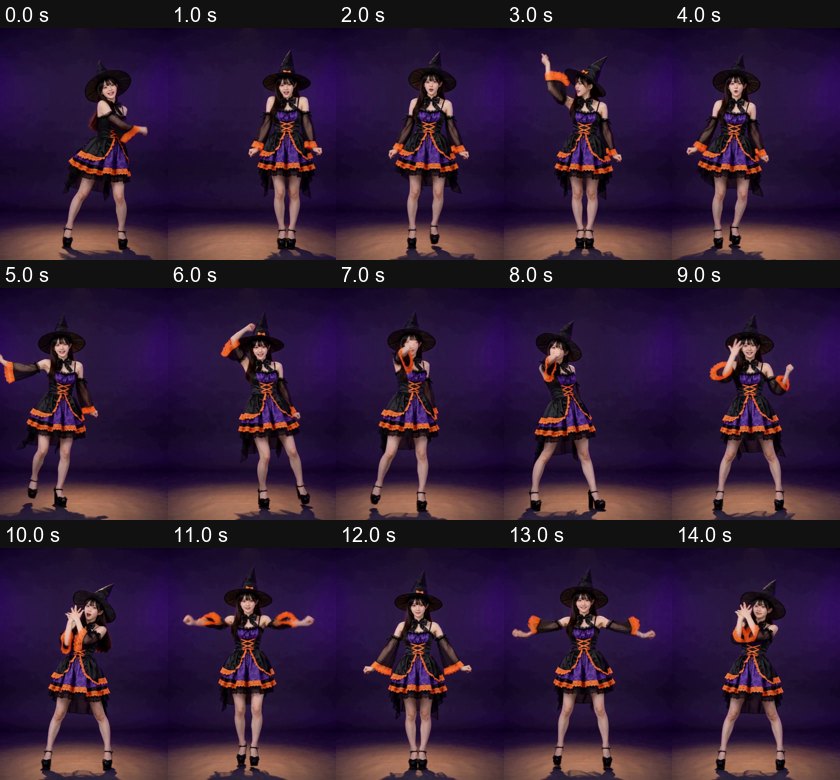
音は参照と0.000秒でぴったり合っている(相互相関0.896)。動きは、5秒の片腕伸ばし、6秒の額のあたり、10秒の顔のそば、13秒の両腕開きはおおむね対応している。一方、3秒で参照は腕を下げているのに出力は片腕を上げ、11〜12秒と14秒もポーズが違う。最終フレームの姿勢も参照と一致していない。「音に合わせて踊っている」が、「参照の振付をなぞっている」とは言えない出来だ。
帽子は15秒間ずっと頭に乗っていた。完全に背中を向ける場面はなく、斜め向きまで。指定していないのに、9.5〜10.5秒あたりで口が歌に合わせて動く。音を fully_copy で渡しただけで、歌詞に口が付いてきた。キャラシートとの一致は、顔立ち・髪・帽子のリボン・胸のレースアップ・袖・裾・靴の要素は保たれ、レースの細かさや柄、厚底の形までは簡略化された。

小ネタ: 進捗バーが0%のまま
今回はAPIから投入したので、ComfyUIの画面上部は「Running… in another tab」、進捗バーは0%のままだった。実際の進みは左下のコンソールで読める。5/20 [12:12<35:50] なら、20ステップ中5つ完了、サンプリング経過12分12秒、残り35分50秒の見込み。0%表示だけ見て止まったと決めて再投入しないこと。
Macはどうなったか
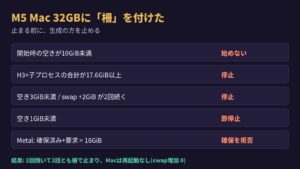
前編で止まったMac側は、同じ日にメモリ保護(Metal割当16GiB上限・開始時の空きが10GiB未満なら起動拒否・実行中の監視)を付け、参照動画の読み方もタイル化して、深度動画で2回焼いた。2回とも途中で柵に当たって止まり、完成動画はない。ただしMacは2回とも再起動なしで生き残った(スワップ増加0)。1回目は参照動画の処理を全部通過してQwenの視覚処理で、2回目はその解放漏れを直してQwenを全部通過し、生成本体の作業領域の確保で、それぞれ上限に当たった。15秒の本番はデスクトップで、という前編の段取りどおりになった。
分かったことと、分かっていないこと
- 分かったこと: 深度動画は参照として動きと音を渡せる。参照を fully_preserved にすると、その見た目が出力に漏れることがある(1本で観測)。weak_reference+20ステップ+容量優先設定で色は最後まで残った。20→25は同条件で、1ステップ約141秒は変わらず、細部が一部よくなった。
- 分かっていないこと: 白化の原因がプロンプトか、ステップか、H3VMの設定かは分けていない。振付の追従は部分的で、どうすれば3秒・11〜12秒・14秒が合うかは次の課題。口は指定なしで歌に合った(狙って出せるかは未確認)。
関連: 前編(40) / 第39回 同条件で測り直した / 第34回 背景の縦縞はステップ数で消えた / 第14回 Blenderで動きを先に決める
コメント