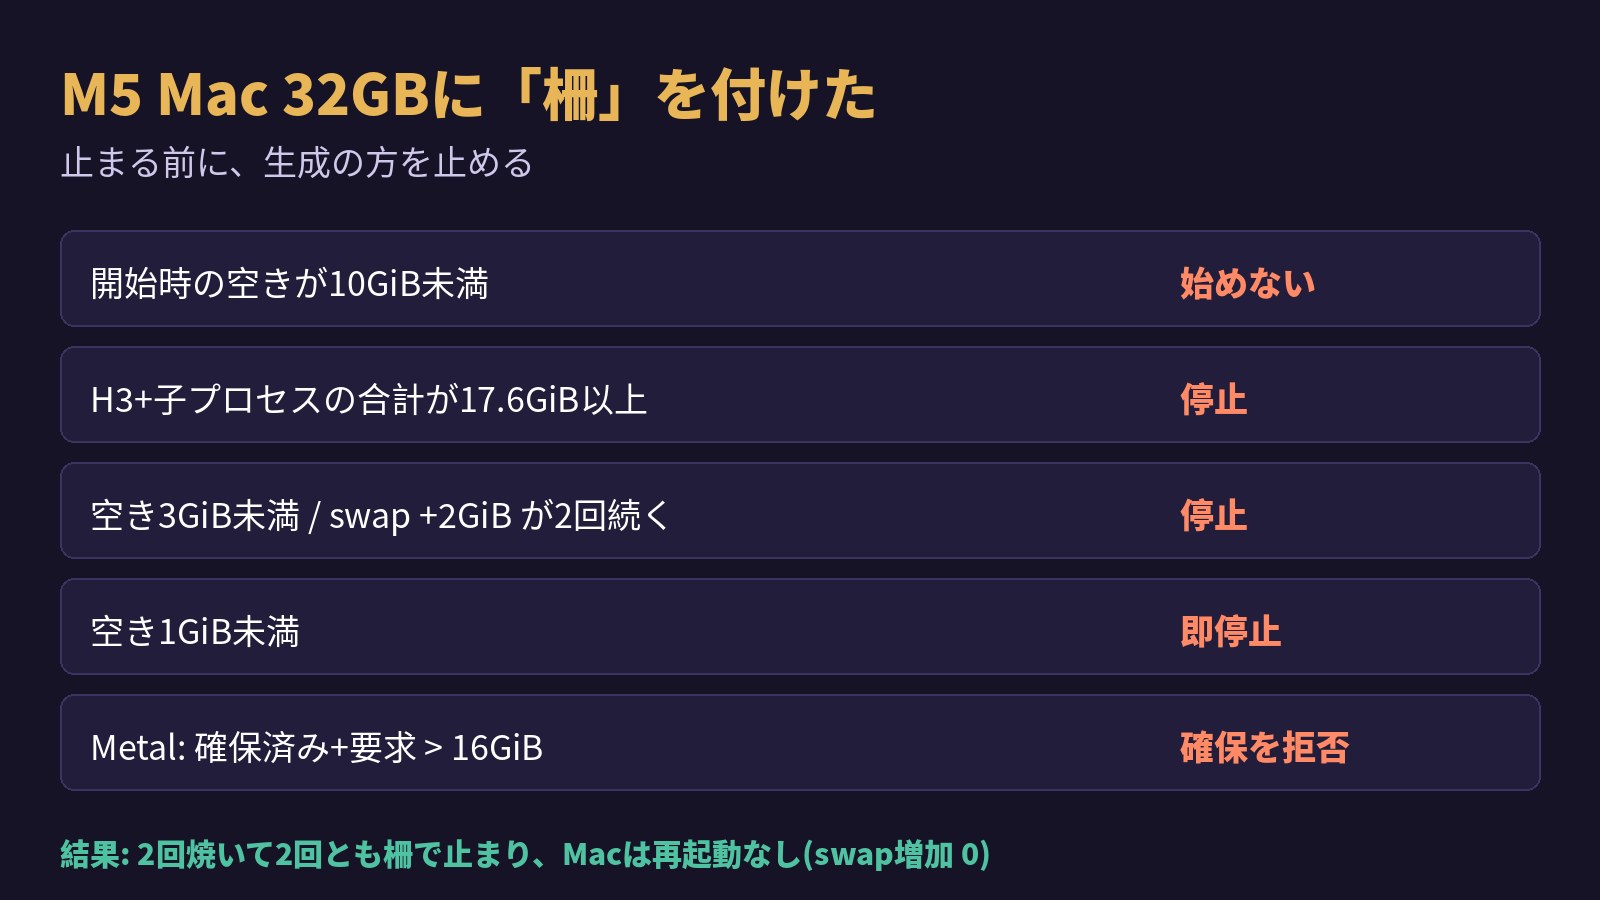
前編で、参照動画を読ませた直後にM5 Mac(32GB)が止まった。後編はデスクトップで焼いた話だったが、同じ日にMac側では別の作業が進んでいた。止まる前に自分で止まる柵を付け、参照動画の読み方を変え、同じ15秒を2回焼いた。結果は、2回とも柵に当たって途中で止まり、完成動画はゼロ。ただしMacは2回とも再起動なしで生き残った。この記事はその記録で、「M5 Mac 32GBで15秒はいま何が足りないか」の答えでもある。
何を柵にしたか
止まる原因は確定していない。だから原因を潰すのではなく、「危なくなったら生成の方を止める」仕組みを先に入れた。柵は2段ある。
Python側(ComfyUIのノード)
| 条件 | 動作 |
|---|---|
| 開始時の空きメモリが10GiB未満 | 生成を始めない |
| H3と子プロセスのメモリ合計が 18GiB か RAMの55% の小さい方(このMacでは17.6GiB)以上 | 停止 |
| 空きが3GiB未満、または開始時からswapが2GiB以上増えた状態が、0.5秒間隔で2回続く | 停止 |
| 空きが1GiB未満 | 次の確認で即停止 |
| 出力画像の一括領域を取ると空きが3GiB残らない | 取り込む前に拒否 |
止める相手は、そのH3と、H3が起動したFFmpegなどの子プロセスだけ。別のPythonや他のアプリは巻き込まない。
エンジン側(Metal)
GPUのメモリ(Metalバッファ)を新しく確保する前に、「確保済み+今回の要求」が物理RAMの半分か16GiBの小さい方(このMacでは16GiB)を超えるか、macOSのメモリ圧力が警告以上なら、確保を拒否する。
どちらのしきい値も「安全が実証された限界」ではなく、保守的な初期値だ。後で出てくるが、この16GiBが2回とも効いた。
参照動画の読み方を変えた
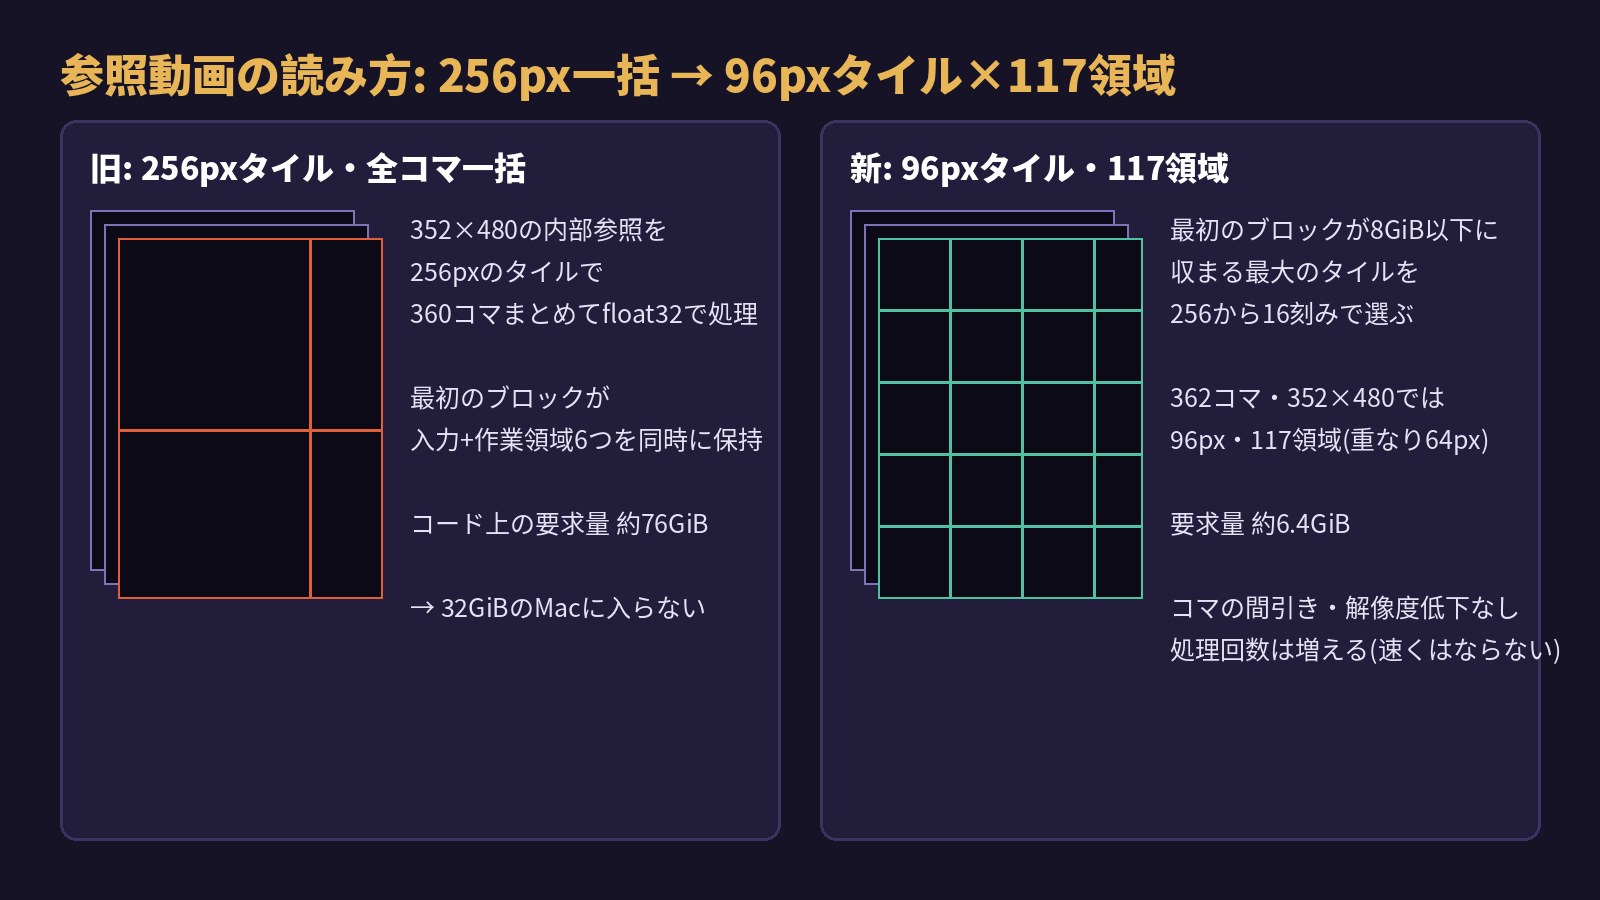
前編で「2.2MBの参照動画が読み込むと約0.95GiBになる」と書いたが、本当の重さはその先にあった。旧コードは参照動画を256pxのタイルで、全コマを一括して、float32で処理し、最初の残差ブロックで入力と6つの作業領域を同時に持つ。360コマの参照では、このブロックの要求量がコード上で約76GiBになっていた。32GiBのMacで通るはずがない。
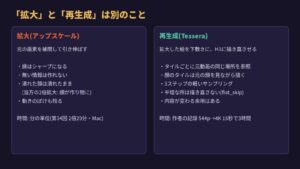
新コードは、最初のブロックが8GiB以下に収まる最大のタイルを256から16刻みで選ぶ。362コマ・352×480の内部参照では96pxタイルになり、117領域に分けて処理する。要求量は約6.4GiB。タイルの重なり64pxは維持し、コマの間引きも解像度の低下もしない。処理回数は増えるので速くはならないが、メモリの交換は減る。
もう1つ、末尾の切り捨ても直した。旧コードは360コマの参照を345コマ(14.375秒)に切り捨てていた。新コードは360コマを全部使い、最終コマを2回反復して362コマ(15.0833秒)にする。
1回目: 参照は全部通った。止まったのはその先
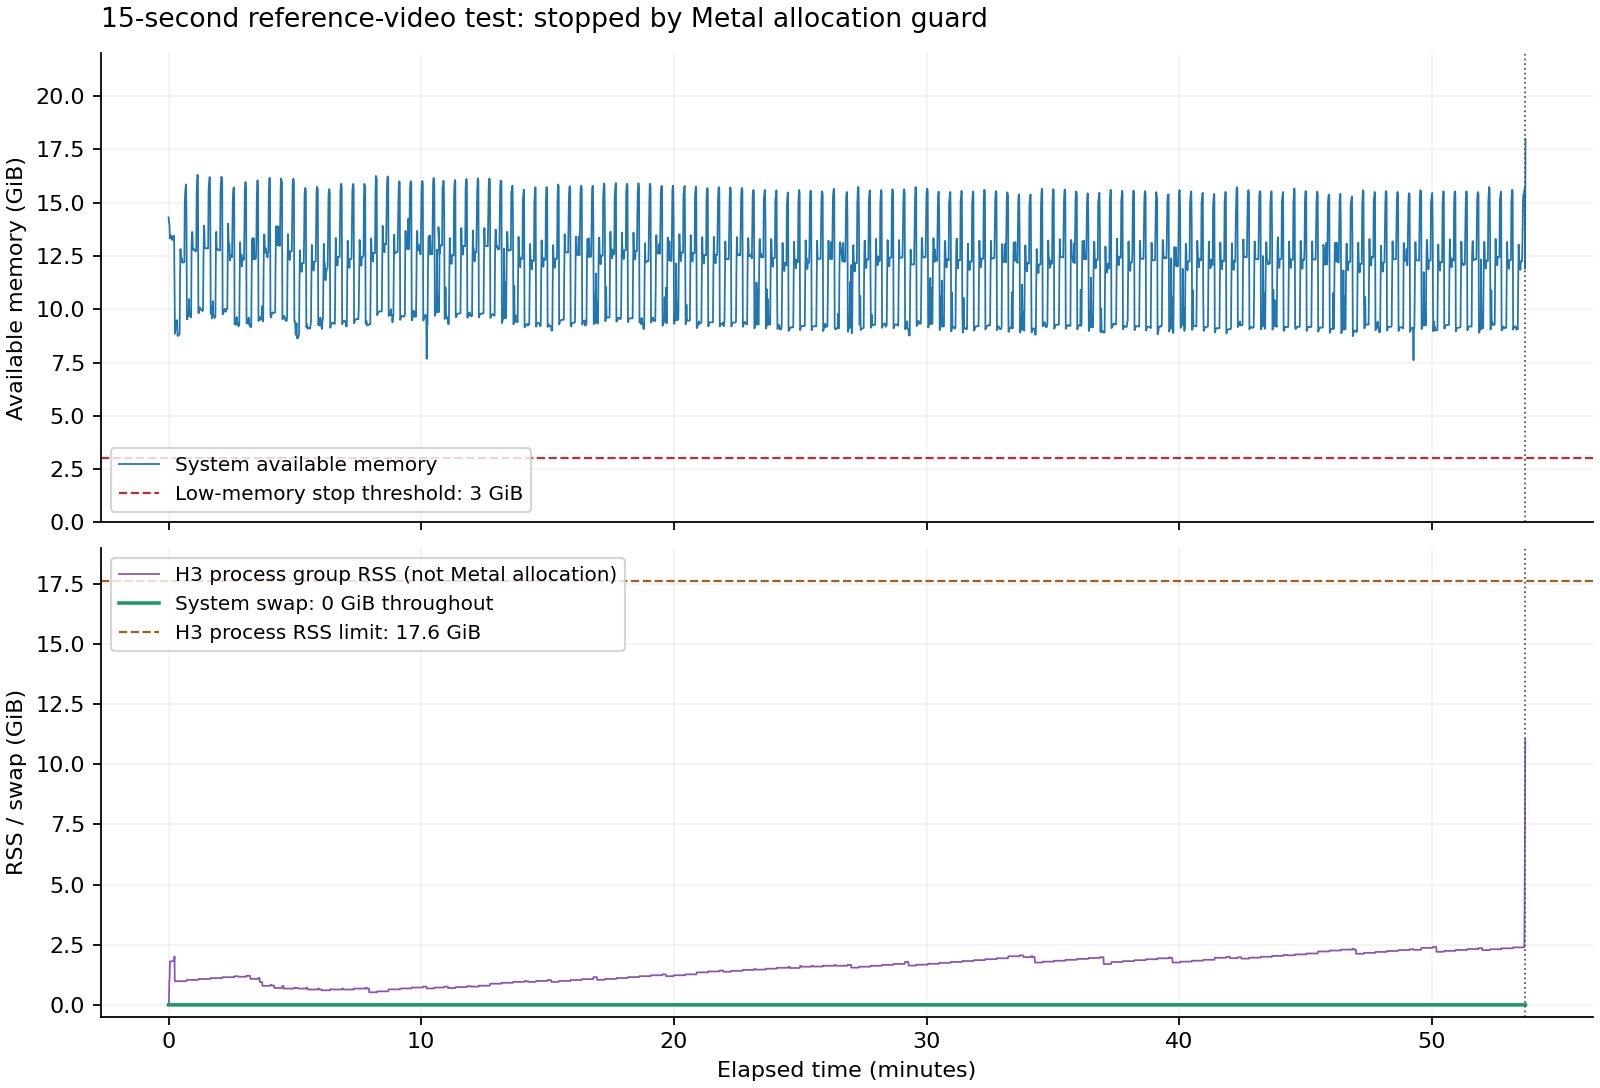
11月1日 01:43、深度参照(360×480・24fps・15秒)+キャラシートで、672×928・362コマ・12ステップ・LoRAなし。53分42秒で柵により停止した。
- 音声の参照 7/7、画像の参照 15/15、動画の参照 117/117、すべて完了。末尾の2コマ反復もログで確認。
- 止まったのは、その後のQwen(テキストエンコーダの視覚処理)の9回目。Metalの確保済み15.99GiBに0.01GiBを足そうとして16GiBの柵に当たった。
- Macの空きメモリの最小は7.61GiB、swapの増加は0、H3のプロセス群は最大11.05GiB。Macは再起動なし。
前編で止まった場所(参照動画の読み込み)は通った。代わりに、Qwenの処理で何かが積み上がっていた。
積み上がっていたのはQwenの解放漏れだった
同じ参照動画から同じ寸法の2コマを取り出して、Qwenを3回呼ぶ切り分けをした。旧版は呼ぶたびにMetalの割当が約1.12GiBずつ増え、3回で3.36GiB。Objective-Cのオブジェクトが解放待ちのまま残っていた。呼び出しを autoreleasepool で囲むだけで約3.45MiBで一定になり、20回繰り返しても増えない。出力は旧版と全バイト一致。柵の値は上げていない。
2回目: Qwenは通った。止まったのは生成本体の入口
05:17、同じ条件・同じseedで再投入。55分31秒で、また柵により停止。
- Qwenの視覚処理17回、文章処理50層、AdaLNの準備、生成モデルの読み込み50/50まで通過。
- 止まったのは、生成本体(DiT)の作業領域の確保。確保済み15.72GiBに0.87GiBを足そうとして16GiBの柵に当たった。
- Macの空き最小7.56GiB、swap増加0、H3のプロセス群は最大7.11GiB。再起動なし。
| 1回目 | 2回目 | |
|---|---|---|
| 条件 | 672×928・362コマ・12ステップ・深度参照 | 同じ・同seed |
| 所要 | 53分42秒 | 55分31秒 |
| 通過 | 参照(音声・画像・動画)すべて | 参照+Qwen全部+生成モデル読込 |
| 止まった所 | Qwen視覚処理の9回目(Metal 15.99+0.01GiB) | 生成本体の作業領域(Metal 15.72+0.87GiB) |
| Macの空き最小 | 7.61GiB | 7.56GiB |
| swap増加 | 0 | 0 |
| Mac再起動 | なし | なし |
2回とも、Mac全体のメモリが枯れたのではなく、設定した16GiBのMetal上限に当たって自分で止まっている。柵は仕事をした。逆に言うと、672×928・15秒は、今の実装ではこのMacの16GiBの内側に入っていない。
ついでに118GiB空けた
同じ日に、9月の診断で残していた中間データ(33.27GiB)と、LoRAを適用した派生モデルのキャッシュ4組(85.13GiB・次に使うとき自動で作り直される)を消して、空きは189.85GiB→308.25GiB。実測で118.41GiB。旧GGUFの4本(約61GiB)は、古いワークフローから参照されているので残した。
分かったことと、次
- 分かったこと: 参照動画の読み込みは96pxタイルで通る。Qwenの解放漏れは直った。15秒・672×928は、このMacでは生成本体の入口で16GiBを超える。Macは柵の内側なら止まらない。
- 分かっていないこと: 柵の16GiBを上げて安全かどうか(実証なしに上げない)。タイルを小さくしたことで画質や動きが旧版と同じかどうか(完成動画がないので未評価)。
- 次の手: 解像度か尺を下げて柵の内側に入れるか、生成本体の作業領域の持ち方を見直すか。15秒の本番は、後編のとおりデスクトップで焼く。
関連: 前編(40) / 後編(42) / 第1回 H3はローカルMacで動くか
コメント