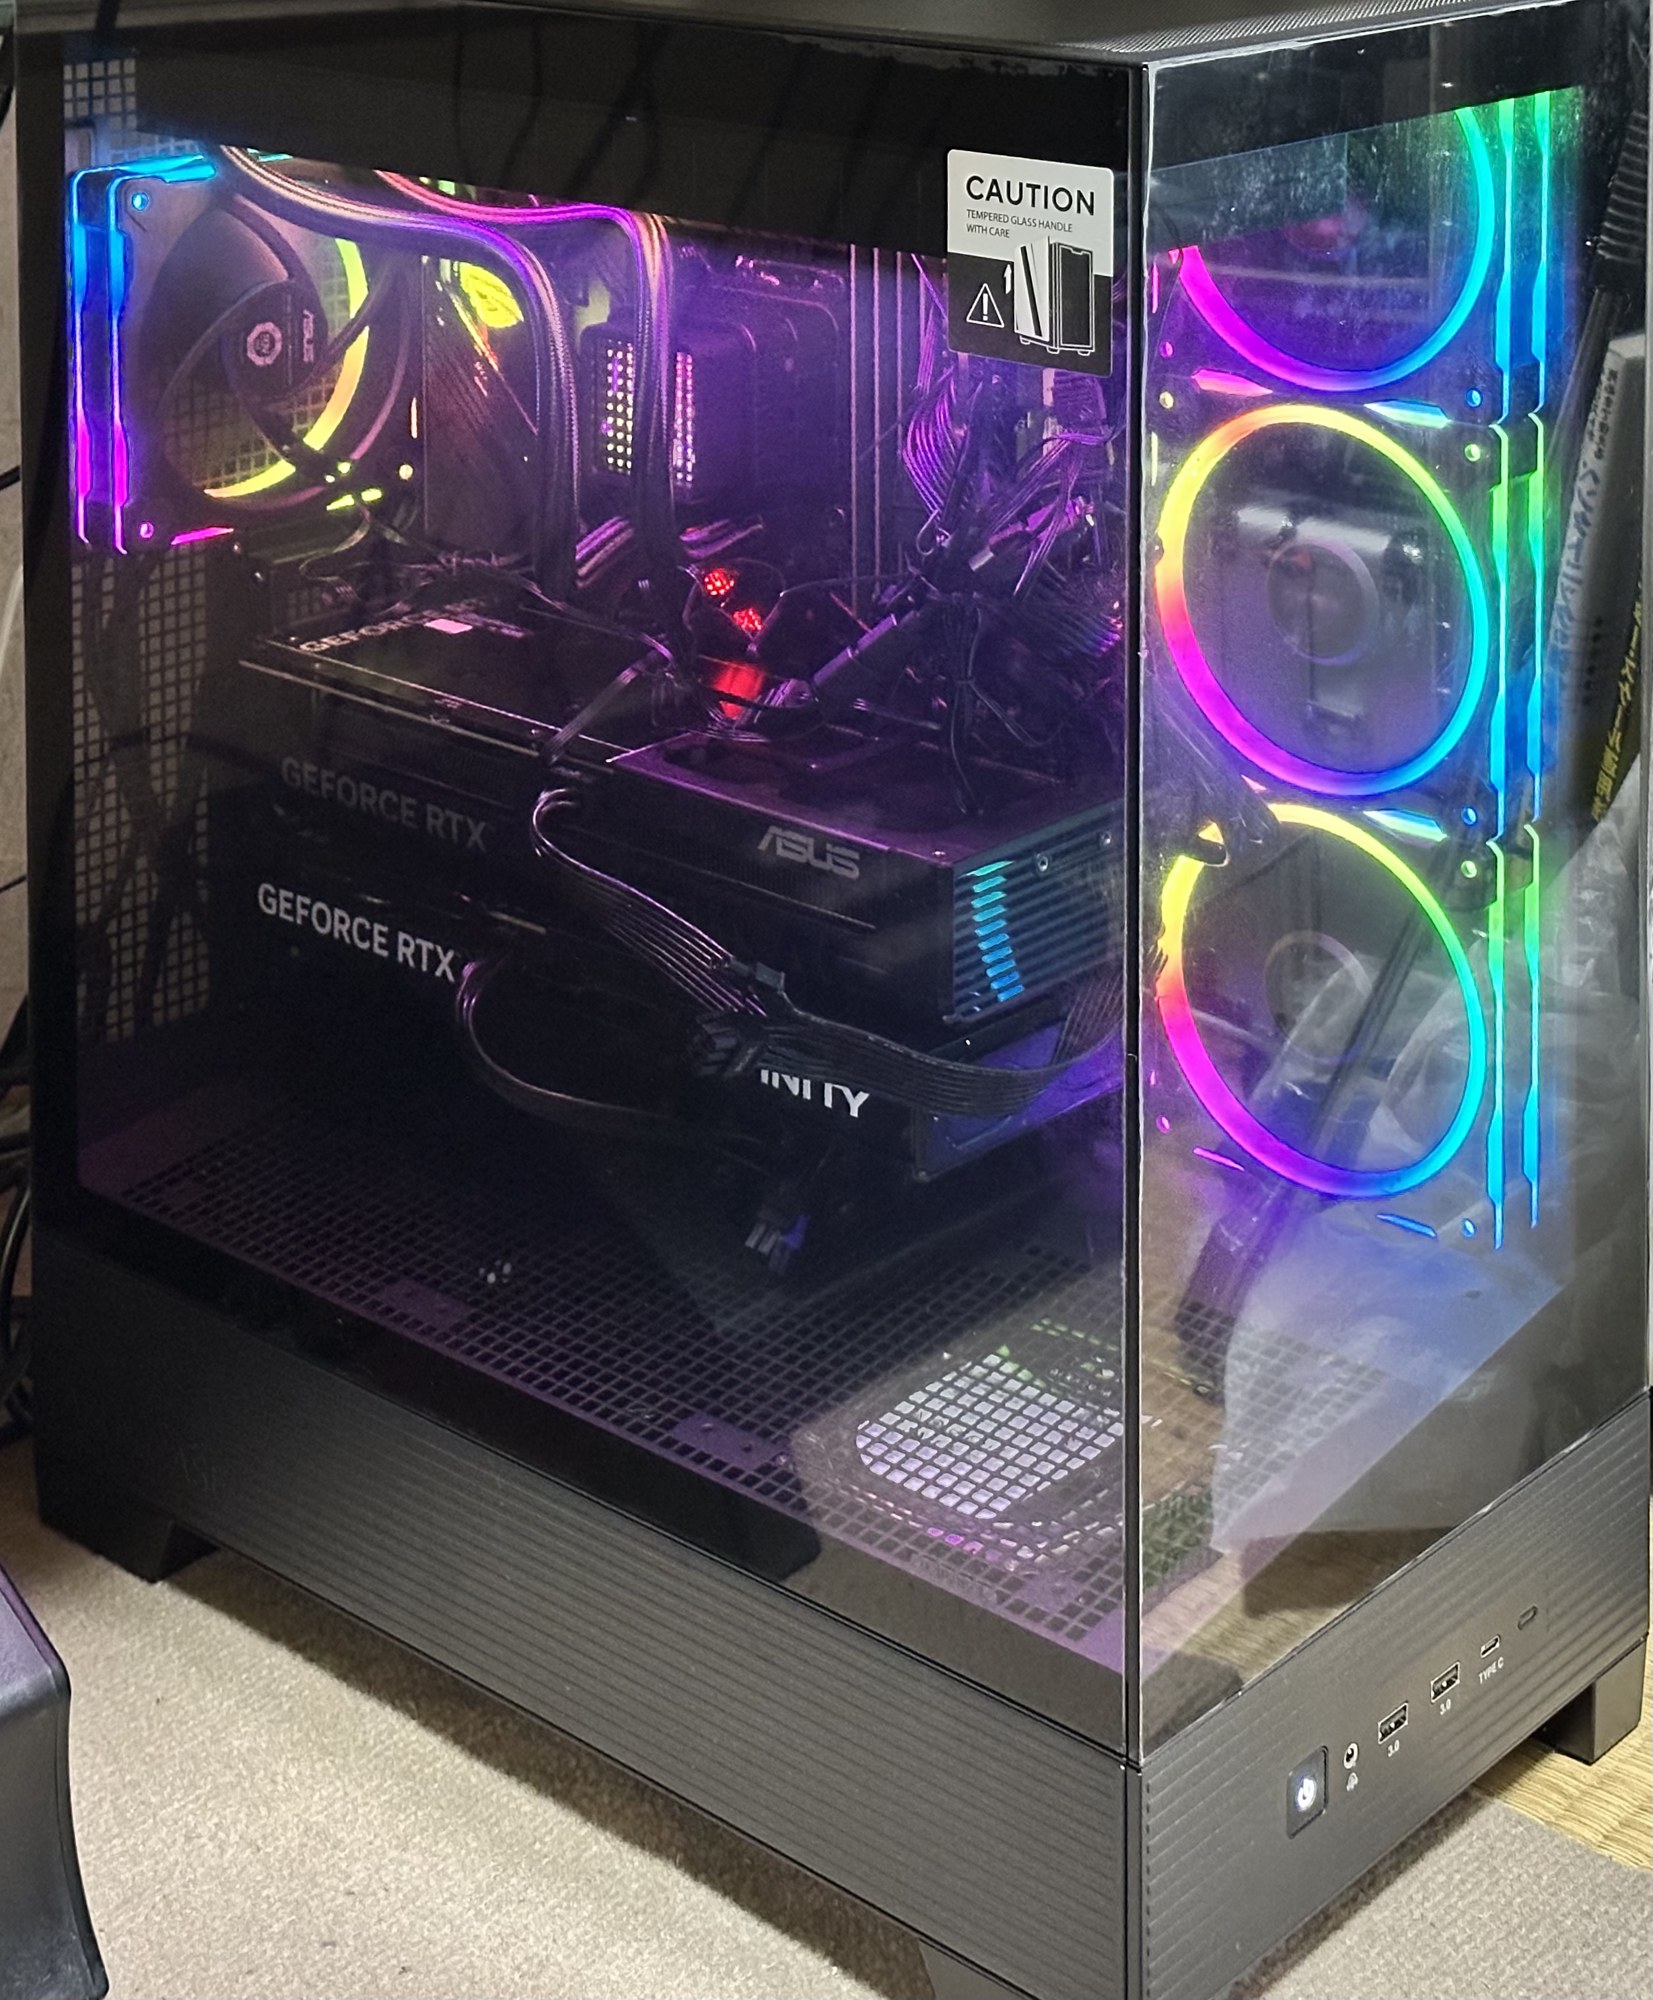
第37回でCPUとマザーボードを替え、第38回で「帯域は仕様上2倍、生成時間が縮むかは次回」と書きました。測りました。第30回(10月21日)と同じ条件・同じseedで、同じAPIグラフを流しています。
先に結論
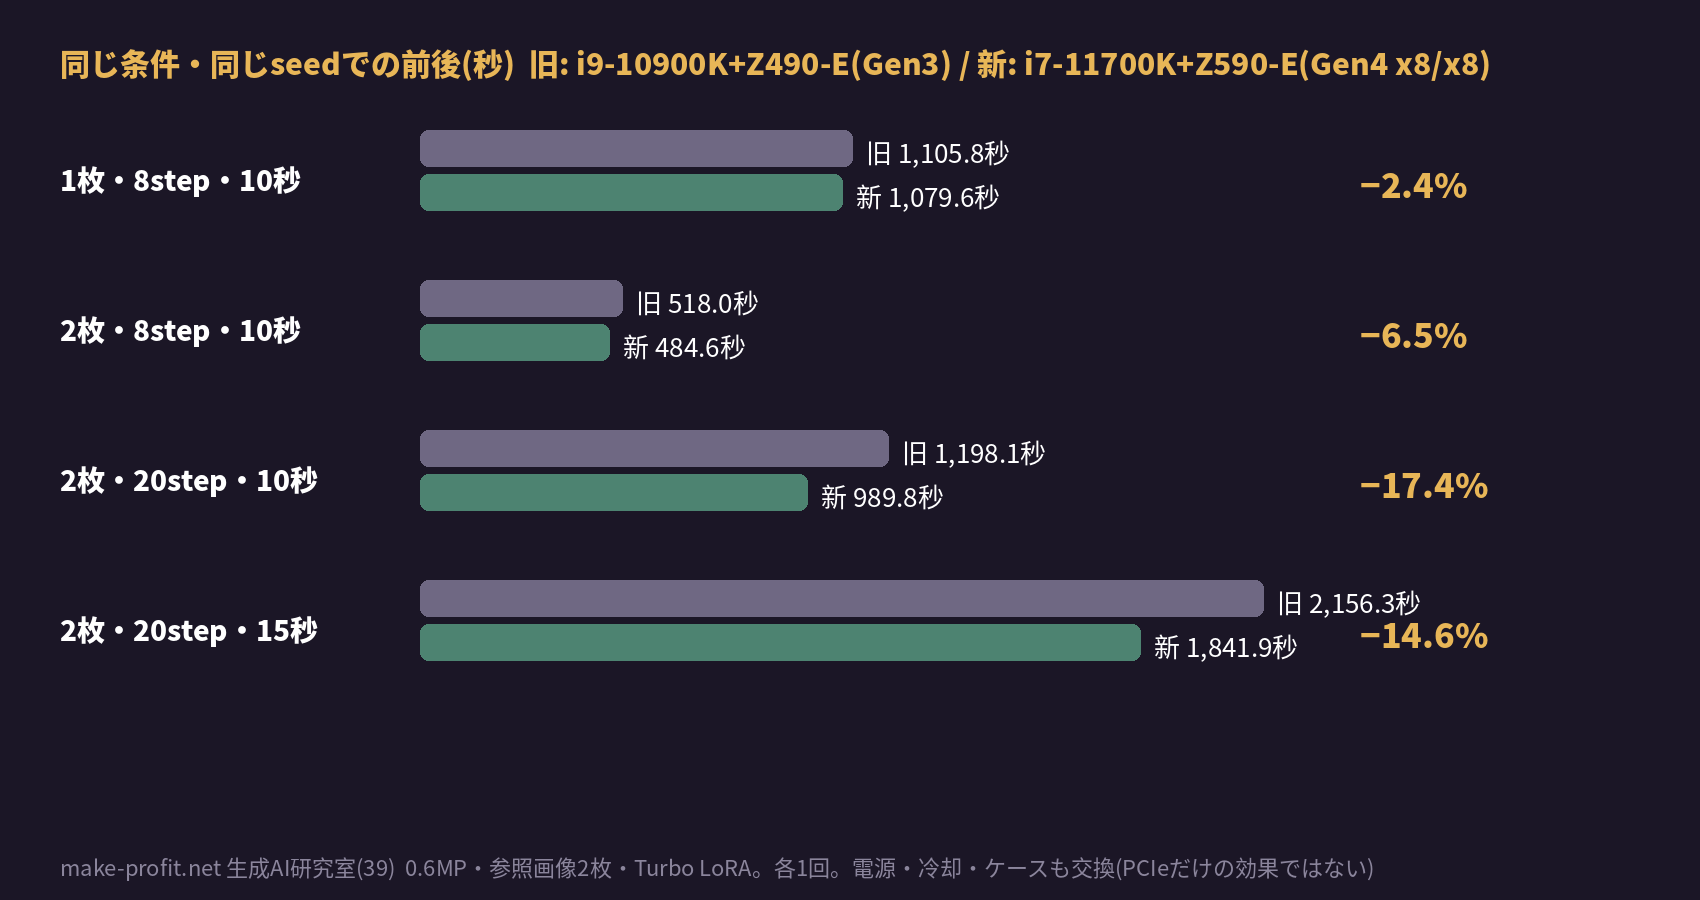
- 2枚挿し(H3VM)の8ステップ: 518秒→485秒、6.5%短縮。 1枚(H3VMなし)は1,106秒→1,080秒、2.4%短縮。
- 2枚挿しの20ステップ: 10秒は1,198秒→990秒(17%短縮)、15秒は2,156秒→1,842秒(15%短縮)。
- 負荷中のPCIeは両GPUともGen4 x8でした。第38回で「基板の印字からx8のまま」と読んだとおり。
- 2枚の方が1枚より縮み幅が大きい。第38回の「帯域が効くのは、2枚が生成中にやり取りする仕事」という読みと向きは合っています。
- ただし、PCIe 4.0だけの効果とは言えません。 替えたのはCPU(コア数も10→8)、マザー、電源、水冷、ケース、吸気。全部まとめての前後です。
1. 何を同じにしたか
| 項目 | 内容 |
|---|---|
| 解像度・尺 | 0.6MP(672×928)・10秒・24fps |
| サンプラー | Euler / simple・denoise 1・video shift 12 / audio shift 3 |
| モデル | Ref2VA int8_convrot・テキストエンコーダ Qwen3-VL 32B nvfp4_awq |
| LoRA | Turbo 8step LoRA 強度1。人物・武闘LoRAは無効 |
| 参照 | 静止画2枚(10月21日と同じ画像)。動画・音声参照なし |
| 2枚挿し | H3VM DUAL_QUIET・参加率100%・dual VAE無効。10月21日に直した2ファイルがそのままであることをハッシュで確認 |
| 1枚 | 同じグラフからH3VMノードを外したもの |
| ソフト | ComfyUI 0.36.0 / Python 3.13 / PyTorch 2.13+cu130。更新なし・BIOS変更なし |
| APIグラフ | 10月21日のものを再利用。差分はH3VMノードの有無・接続先・保存名だけ |
| 時間の定義 | ComfyUIの実行履歴の開始〜完了(モデル読み込み・生成・VAE・保存を含む。キュー待ちは含まない)。ノードキャッシュは無効 |
| 旧構成(10月21日) | 新構成(10月30〜31日) | |
|---|---|---|
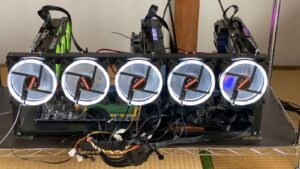
| CPU | Core i9-10900K(10コア) | Core i7-11700K(8コア) |
| マザーボード | ROG STRIX Z490-E GAMING | ROG STRIX Z590-E GAMING WIFI |
| 負荷中のPCIe | Gen3 | Gen4 x8 / x8(実測) |
| GPU | RTX 5060 Ti 16GB×2 | 同じ2枚 |
| メモリ | DDR4 64GB | 同じ(16GB×4・2666) |
| 電源・冷却・ケース | 旧 | 全部交換(第37回) |
同じにできなかったこと: モデルの常駐やOSのキャッシュが温まっているかどうか(cold/warm)は統制していません。旧構成の値は10月21日の各1回です。
2. 結果
8ステップ・10秒(同じseed)
| 旧構成 | 新構成 | 短縮 | |
|---|---|---|---|
| 1枚(H3VMなし) | 1,105.8秒(18分26秒) | 1,079.6秒(18分00秒) | 2.4% |
| 2枚(H3VM) | 518.0秒(8分38秒) | 484.6秒(8分05秒) | 6.5% |
新構成で3つのseed(8ステップ・10秒)
| seed | 1枚 | 2枚 | 1枚÷2枚 |
|---|---|---|---|
| A(上と同じ) | 1,079.6秒 | 484.6秒 | 2.23 |
| B | 1,062.4秒 | 507.2秒 | 2.09 |
| C | 1,046.9秒 | 482.3秒 | 2.17 |
| 中央値 | 1,062.4秒(17分42秒) | 484.6秒(8分05秒) | 2.19 |
同じseedを3回繰り返した統計ではなく、違う3つのseedでの1枚/2枚の対比較です。2日に分けて測っています。
20ステップ・2枚(同じseed、各1回)
| 条件 | 旧構成 | 新構成 | 短縮 |
|---|---|---|---|
| 0.6MP・10秒 | 1,198.1秒(19分58秒) | 989.8秒(16分30秒) | 17.4% |
| 0.6MP・15秒 | 2,156.3秒(35分56秒) | 1,841.9秒(30分42秒) | 14.6% |
Turbo LoRAを入れたまま20ステップを回す、第30回と同じやり方です。20ステップの方が良い絵になるという話ではなく、重い条件での時間の前後です。
3. なぜ2枚の方が縮んだのか(断定はしない)
第38回で、2枚挿しの帯域が効くのは「2枚が生成中に結果をやり取りする仕事」だと書きました。H3VMのattention並列はまさにそれで、1枚の仕事はGPU1枚の中で閉じます。今回、1枚は2.4%、2枚は6.5〜17%。向きはその読みどおりです。
ただし、理由をPCIe 4.0に絞ることはできません。CPUが替わり(第10世代10コア→第11世代8コア、クロックとキャッシュも違う)、チップセットとの道(DMI)もx4→x8になり、電源と冷却も替わっています。「同じ条件で測ったら、これだけ縮んだ」までが今回の事実です。
進捗表示から読んだサンプリング部分だけの概算では、1枚が16分24秒→15分44秒(約4%)、2枚が6分34秒→5分53秒(約10%)で、総時間と同じ向きでした。
4. 資源と温度
| 実行 | GPU0 / GPU1 VRAM | GPU0 / GPU1 温度 | RAM | コミット |
|---|---|---|---|---|
| 1枚・8ステップ | 12.4GiB / 0.3GiB | 68℃ / 29〜32℃ | 43〜46GiB | 60GiB |
| 2枚・8ステップ | 12.7GiB / 12.1〜12.9GiB | 69〜71℃ / 60〜62℃ | 46〜49GiB | 100〜101GiB |
| 2枚・20ステップ・10秒 | 12.8GiB / 13.2GiB | 72℃ / 63℃ | 46GiB | 102GiB |
| 2枚・20ステップ・15秒 | 15.3GiB / 13.9GiB | 71℃ / 54℃ | 46GiB | 105GiB |
約10秒間隔で採った最大値です。15秒ではGPU0が15.3GiBまで上がり、16GBのほぼ上限。今回は完走しましたが、この上に解像度や尺を積める余裕があるとは言えません。電力の最大は1枚で181W/23W、2枚で182W/90W(初回の採取)。
CPUの温度は測れていません。 温度の取得元(LibreHardwareMonitorなど)が動かず、記録なし。第37回のBIOS画面の27℃は起動直後の値で、負荷中の値ではありません。GPUが72℃以下で完走したことだけで、CPUの熱が安全だとは言わないでおきます。
5. 絵の注意
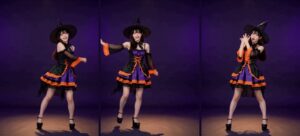
6本とも映像(H.264)と音声(AAC)があり、全区間のデコードに問題はありません。5秒・9秒・14秒の静止画を見て、全面の白濁や黒画像(第30回で直した症状)は出ていません。
同じseedでも、1枚と2枚で構図・顔・ボールの位置は変わります。初回の9秒のコマでは、1枚の方は手前の球が2個に見え、2枚の方は顔の上が画面外。10秒・20ステップの9秒では帽子の上が切れています。全編の動きの自然さと音声は、まだ評価していません。時間の記事であって、画質の記事ではありません。
言えること、言えないこと
- 言える: 同じ条件・同じseedで、2枚挿しの8ステップは6.5%、20ステップは15〜17%、1枚は2.4%縮んだ。負荷中のPCIeは両GPUともGen4 x8。
- 言える: 2枚の方が縮み幅が大きい。第38回の読みと向きは同じ。
- 言えない: 縮んだ理由がPCIe 4.0であること。CPU・DMI・電源・冷却も替わっている。
- 言えない: 新構成でCPUが安全な温度で回っていること。測れていない。
- 次回: CPU温度を取れる状態での負荷測定。cold/warmをそろえた反復。0.8MPや15秒超えの余裕。
まとめ
- 板とCPUを替えて、2枚挿しは6.5〜17%、1枚は2.4%縮んだ。
- 効いた先は「2枚がやり取りする仕事」。向きは仕様の読みどおり。
- ただし、原因を1つに絞らない。全部まとめて替えた前後の数字。
- 15秒・20ステップはVRAM 15.3GiBで、16GBの上限が見えた。
環境: Windows 11・RTX 5060 Ti 16GB×2・Core i7-11700K・ROG STRIX Z590-E GAMING WIFI・DDR4 64GB・ComfyUI 0.36.0。旧構成の値は第30回(10月21日)。数字は実測早見表にも載せます。
コメント