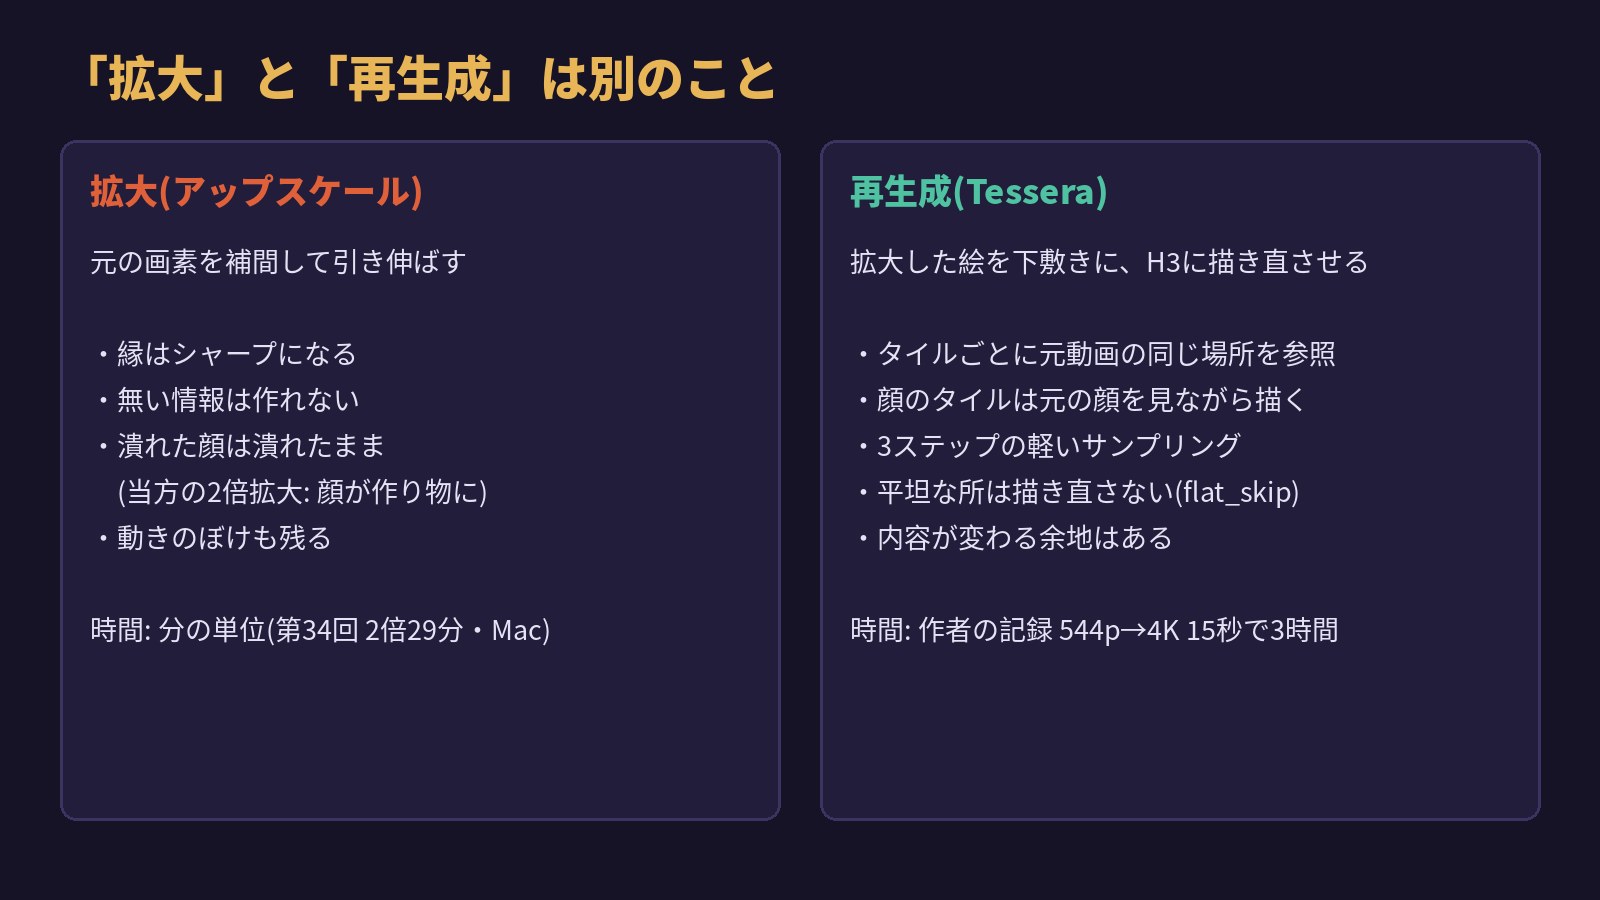
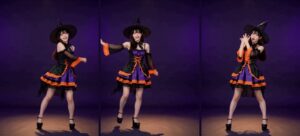
昨夜、ハロウィン後編の25ステップ版を2倍に拡大してみた。帽子や衣装の縁は締まったが、顔は作り物のようになった。動きの速い手のぼけも、拡大では直らない。
同じ日に、Xで「ComfyUI-Tessera」を試した投稿が伸びていた。480×864で生成して顔が潰れた動画を、3倍の1440×2592に「再生成」して顔と細部が戻る、という内容だ。当方がそれを引用したポストは6時間で976表示・ブックマーク18と、普段の3〜4倍動いた。「拡大ではなく再生成」に需要があるのは明らかなので、公開されている資料(GitHubのREADME・設計文書・例ワークフロー)を読んで整理した。当方はまだ動かしていない。 この記事は出典つきの参考情報で、実測は次の記事になる。
Tesseraとは
- 公開場所: GitHub hashu786/ComfyUI-Tessera。MITライセンス。11月2日時点でコミット2、できたばかり。
- 作者の説明: 「MiniMax H3で作った動画アップスケーラー。クリップを読み、倍率を決めて実行すると、タイルごと・時間チャンクごとに再生成して2K/4K/8Kにする。1枚のコンシューマGPUで、どんな長さでも。VAEのエンコードとデコードをストリーム化し、フル解像度のピクセル列はメモリに存在しない」。
- ノードは9つ。中心は Streamed Encode(元動画→拡大した板の潜在+ガイド)、Refine(タイル再生成の本体)、Streamed Decode(ストリーム復号・救出用)、Tile Plan(GPUを使う前の空撃ち見積)。ほかに Guide Anchor(細部の静止画を差し込む)、Temporal Dilate/Decimate(速い動きの区間だけコマを増やして戻す)、Guide Grain、Extra Options。
仕組み: 隣のタイルではなく、「真実」に錨を下ろす
設計文書(docs/LAWS.md)に、作者が測りながら決めた経緯が書かれている。要点を日本語にする。
- 元の動画を lanczos で目標サイズに拡大し、VAEで潜在に落とす。これを「板(plate)」と呼ぶ。
- 板を、モデルが学習した大きさの窓(タイル)に分ける。high_vram なら1024×1024、時間方向は124コマ。low_vram は73コマ。
- 各タイルに、そのタイルの位置で切り出した参照を与える。参照動画の同じ切り出し、画像参照、帯域内のガイド、そしてその切り出しから再エンコードしたテキスト。タイルごとに H3 ref2va で軽く再サンプリングする。
- 再サンプリングは3ステップ(sigma 1.0→0.7→0.4→0.0)。頭の1ステップは蒸留(turbo)で構造を決め、尾の2ステップは euler で質感を乗せる。作者の測定では、尾を2ステップにしたとき質感が「生まれて整う」(+67%)、3にすると硬くなり(+7%)ちらつきが増えた(+17%)。
- ノイズは1つの場を全体で共有し(seed_mode=global)、タイルの縫い目32pxは両隣が生成して重みで混ぜる。隣のタイルの結果を継承する旧方式は、位置ずれが行ごとに積み上がった(+1.5, −2.1, −9.3, −15.5 px)ので捨てた。
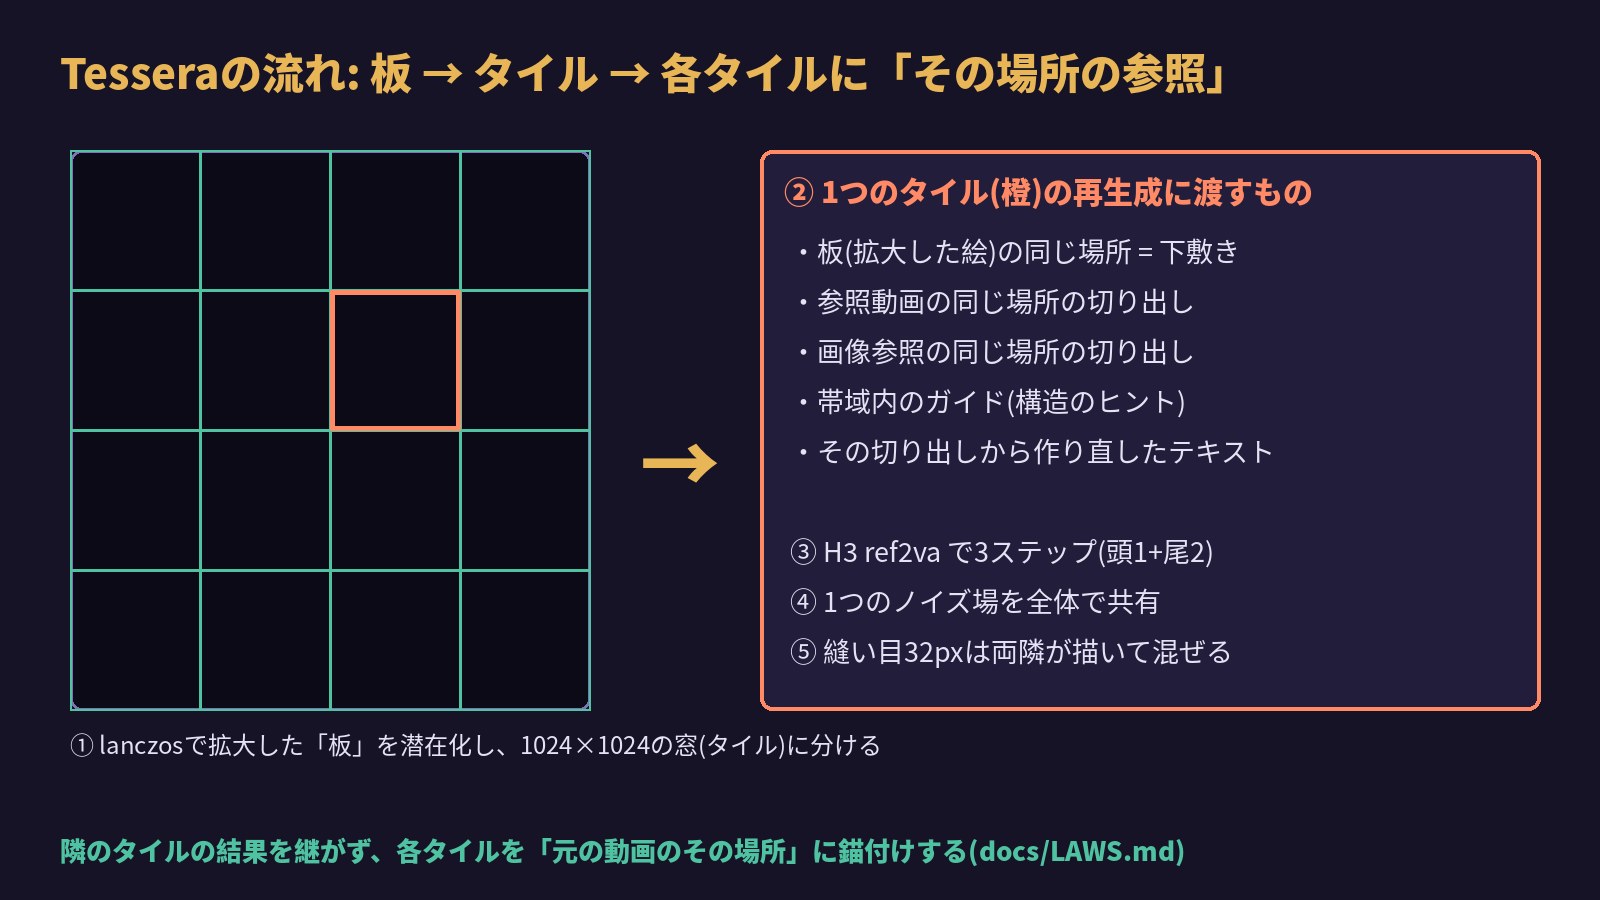
つまり「拡大した絵をぼかして直す」のではなく、「拡大した絵を下敷きに、元の動画の同じ場所を見ながらH3に描き直させる」。顔が戻るのは、顔のタイルが元動画の顔の切り出しを参照しているからだ。
要るもの(例ワークフローから)
例ワークフロー tessera_upscaler.json は100ノード。使っているモデルは次のとおり。
| 役割 | ファイル |
|---|---|
| 本体 | MiniMax H3 ref2va pruned int8 convrot |
| 頭の1ステップ用 | TaoMate 3step LoRA |
| 細部用 | LMS v1.0 r64 LoRA(Alissonerdx)。0.75と1.0の2段で読む |
| 動画VAE / 音声VAE | int8 convrot / fp32 |
| テキストエンコーダ | Qwen3-VL 32B int8 convrot |
| 任意: 最初のコマのアンカー | Qwen Image 2.1 int8+turbo LoRA+texture fix VAE |
| 任意: 主役マスク | SAM3 |
本体・VAE・テキストエンコーダは、当方が第39回までデスクトップで使っている構成と同じ。追加で要るのは LMS detail LoRA と(使うなら)Qwen Image 2.1 と SAM3。
設定の勘所(READMEと設計文書から)
spatial_tile/temporal_tile: high_vram か low_vram を選ぶと、タイルと時間窓が予算に合わせて一緒に変わる。flat_skip(既定4.0): 空や煙のような平坦なタイルは再生成せず板のまま残す。モデルがそこに何かを描き込む(幻覚)のを防ぎ、その分のステップも浮く。- first-frame anchor: 2xのときだけ細部の静止画を差し込む。4x以上では外してモデルに描かせる。アンカーを使うときは
motion_release_floorを0.3に。 - 動きの速い場面:
guide_releaseがカメラや被写体の動きに応じて自動で絞られる(動いているときに質感を自由にすると、毎コマ描き直されて画面全体が煮える)。 - 最後のデコードが失敗したら(ディスク不足など)、再生成済みの潜在が
tessera_rescue_*.latentとして保存され、LoadLatent→Streamed Decode で救える。
作者が記録している数字
- 4倍にすると、15秒のクリップはfloat32で1コピー約36GBになり、普通のつなぎ方(拡大→VAEエンコード)はGPUに関係なくOOMになる。そのためのストリームエンコードで、窓あたりのピクセルは約5.2GB。
- 本番検証: 544p→4K・15秒(拡張617コマ・18窓・24タイル×3チャンク)で合計3時間。GPUの型番は書かれていない。
- 8Kのサンプリングを8時間49分走らせた後、デコード用の67.6GBをディスクに確保できず終了した。これを機に、開始前にディスクの空きを検査する仕組みと、失敗時の潜在保存を入れた。
Xで出ている報告
- @DeepForest_Inc(11月1日): 480×864→3倍1440×2592の再生成。25,145表示・ブックマーク558(11月2日13:50時点)。
- @Hemi3AI(11月1日): 「恐ろしく時間がかかる」。
- @Ozygpt(11月1日): 3倍にしたとき顔の同一性が保たれるのか、という問い。
- @toyxyz3(10月30日): 紹介投稿が27,840表示。
いずれも投稿者の環境での報告で、当方は再現していない。
当方はどうするか
昨夜の2倍拡大は、縁は直り顔は作り物になった。Tesseraは「顔のタイルが元の顔を見ながら描き直す」仕組みなので、当方の結果と正反対の方向を向いている。試す価値はある。
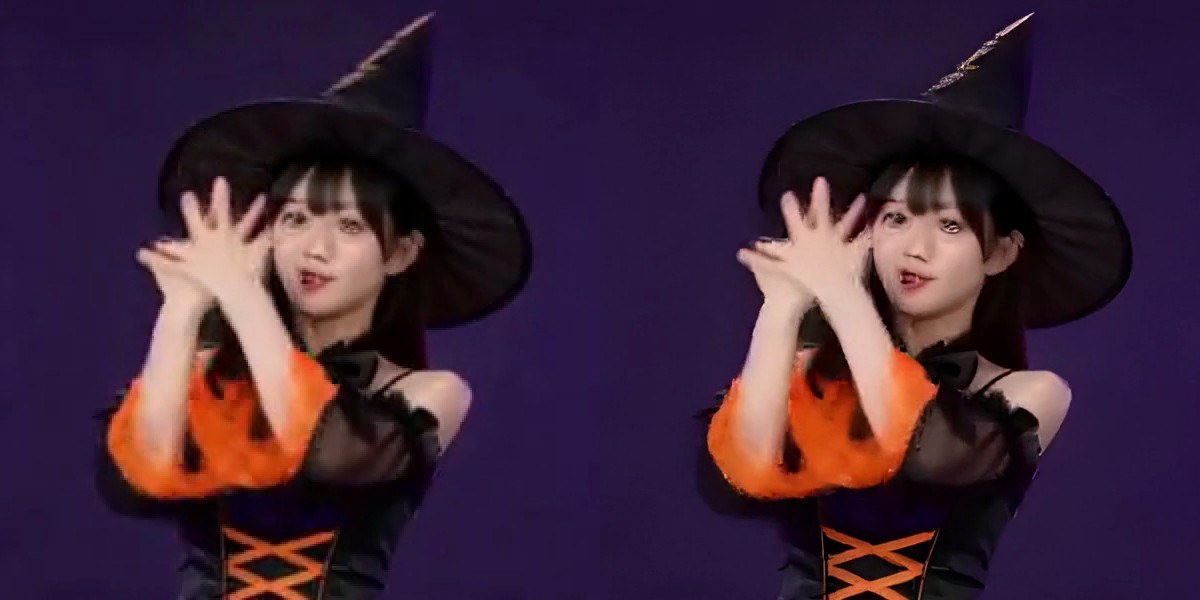
ただし、公開資料にはVRAMの必要量も、RTX 5060 Ti 16GB×2で動くかも書かれていない。段取りは、Tile Planで空撃ちして見積を出し、16GBに収まるなら25ステップ版を2xで1本、昨夜の拡大版と同じ寸法(1344×1856)で顔・手・縁を並べる。この記事を書いている間に、デスクトップで1本目が走り始めた。結果は次の記事で。
出典: GitHub hashu786/ComfyUI-Tessera(README・docs/LAWS.md・example_workflows/tessera_upscaler.json、2026年11月2日閲覧) / 関連: 後編(42) / 第34回 2倍拡大29分・48fps補間59秒(Mac) / 第27回 GPU2枚が一番素直に効いたのはアップスケール
コメント