第25回で、Windows上のComfyUIで16GBのGPU2枚にMiniMax H3の仕事を分ける経路(H3VM)が動き、15秒が45分34秒で完走した話を書きました。その後、同じ経路で焼いた動画の絵が「もや」になりました。処理は成功扱い、ファイルも保存される、でも中身が崩れている。今回はその原因を2か所突き止めて直し、同じ入力・同じseedで8〜20ステップの7本を焼き直した記録です。
症状: 成功しているのに、絵が崩れている
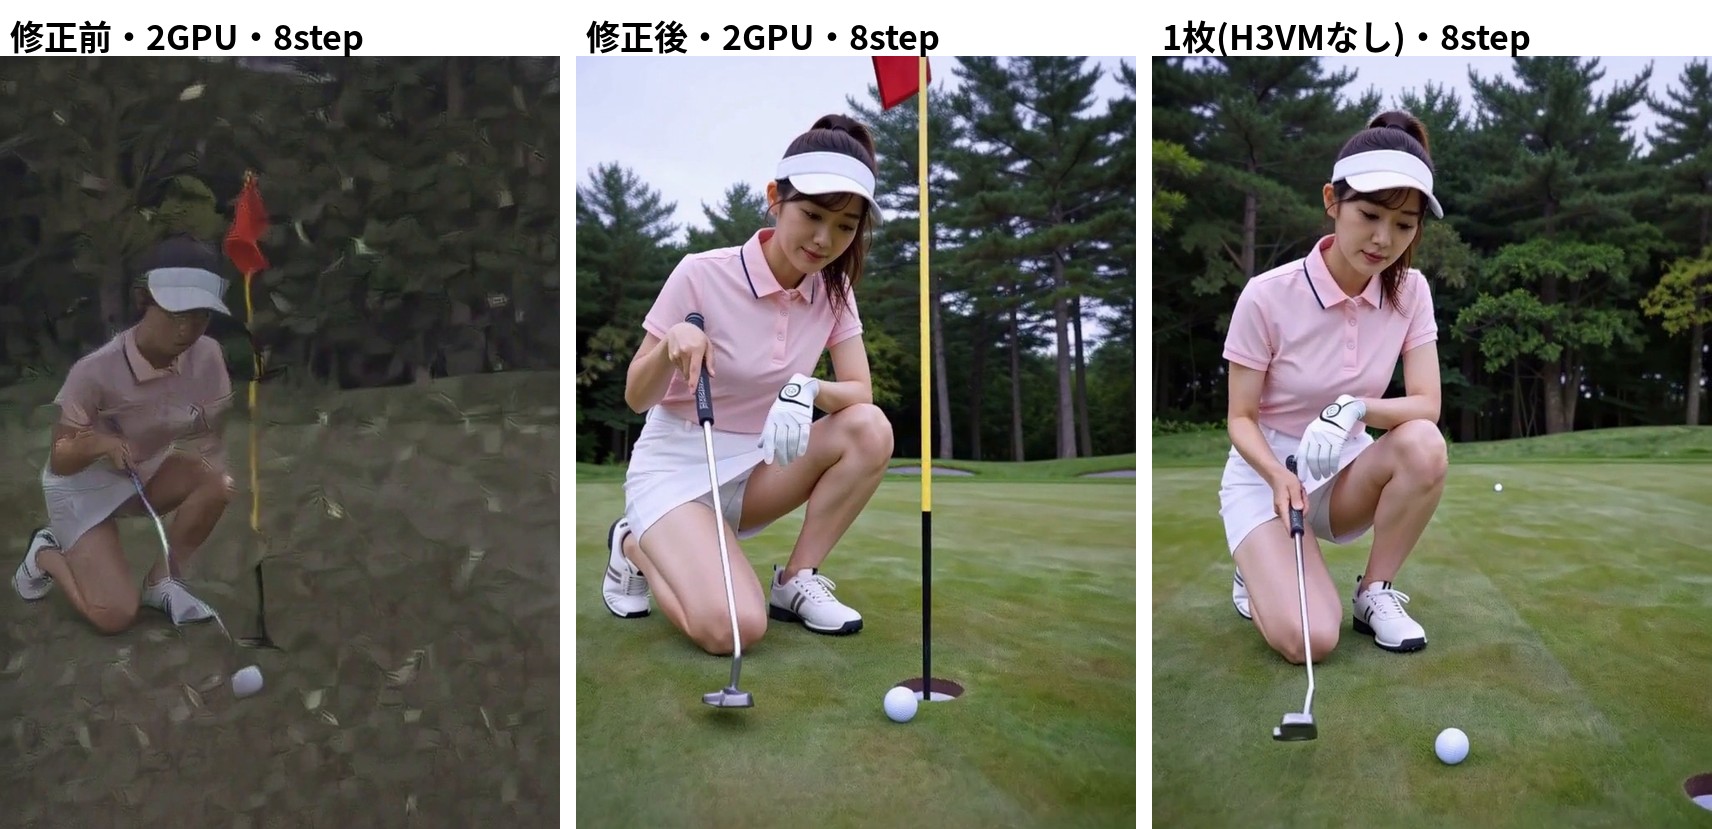
左が修正前の2GPU・8ステップ。人物も背景も、油膜のようなもやに溶けています。なお今回の動画は試し焼きで、カップやポールがゴルフとしては変な場所にありますが、見るのは「崩れているか、崩れていないか」だけなので、そこは気にしないでください。ComfyUI上のステータスは「成功」で、MP4も保存されていました。成功したかどうかは、ステータスではなく絵を見ないと分かりません。
続けて10ステップで焼くと、今度は最後の保存ノード(VHS_VideoCombine)の音声エンコードで止まりました。
Input contains (near) NaN/+-Inf
Error encoding a frame: Invalid argument
終了コード: -22
保存ノードのエラーですが、保存ノードの問題ではありません。上流から来た数値が壊れている(NaN)ので、エンコーダが受け取れない。右端の「1枚(H3VMなし)・8ステップ」は同じ条件でH3VMを切ったもので、こちらは普通に出ます。モデルでもプロンプトでもなく、2枚に分ける処理の中に原因がある、と切り分けました。
原因と修正: 2か所
1. 結合が終わる前に、読み始められる順序になっていた
対象は ComfyUI-H3-MultiGPU/h3vm/attention_parallel.py。2枚のGPUが出した結果を1つに結合してから次に渡すのですが、修正前は「結合完了を待つ」命令が、結果を読む reshape の後に置かれていました。
+        caller_stream.wait_event(merge_done)
         if not skip_output_reshape:
             output = output.transpose(1, 2).reshape(batch, -1, heads * dim_head)
-        caller_stream.wait_event(merge_done)
         output.record_stream(caller_stream)
transpose の後の reshape は見かけの並べ替えで済まず、メモリのコピーを起こすことがあります。そのコピーが、結合の完了より先に走ると、できかけのバッファを読んでしまう。「GPUが遅いから待ち時間を増やした」のではなく、「結合済みの結果を読むべきところで、完了待ちより先に読み始められる順序になっていた」のを直した、が正確です。全体を同期して並列を潰す直し方ではなく、必要な依存関係を1本足しただけです。
この順序を再現するテストでは、修正前は3回中2回で非有限値が出て、修正後は3回とも期待結果と一致。INT8のattention単体でも、系列長1,024と4,096を各3回、計6回とも1枚のGPUの結果と完全一致しました(この一致はattention単体の話で、最終動画の画素一致ではありません)。
2. ステップ数の「ヒント」で、途中のカウンターが0に戻っていた
対象は ComfyUI-H3-MultiGPU/h3vm/streaming_exact.py。H3VMには「何ステップ回すか」のヒント値があり、修正前はカウンターがヒントに達すると0に戻していました。サンプラーが10ステップで、ヒントが8のままだと、8で一度リセットされる。
-            if self.expected_steps and self._step >= self.expected_steps:
-                self._step = 0
+            # expected_steps is a hint, not a sampling boundary.
+            # sampling_end() resets the counter after the actual sampler finishes.
リセットを消して、実際のサンプリング終了時の処理に任せました。ヒントを8のまま8〜20ステップを回し、内部ログが1からステップ数まで連続することを確かめています。
2つの修正を同時に入れて最終動画を検証したので、10ステップのエラーにどちらがどれだけ効いたかは、個別には数値化していません。
結果: 8〜20ステップ、7本全部完走
修正後、同じプロンプト・同じ参照画像2枚・同じseedで、8/10/12/14/16/18/20ステップを1本ずつ。
| 条件 | 値 |
|---|---|
| GPU | RTX 5060 Ti 16GB × 2(CUDA 0 / 1) |
| ComfyUI / PyTorch | 0.36.0 / 2.13.0+cu130 |
| 本体 | minimax_h3_ref2va_pruned_int8_convrot |
| テキストエンコーダ | qwen3vl_32b_minimax_h3_nvfp4_awq |
| Turbo LoRA | minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16、強度1.0(20ステップまで同じ) |
| H3VM | ON、参加率100%、dual VAE OFF |
| サンプラー | euler / simple、Shift 映像12 / 音声3 |
| 画面・尺 | 0.6MP 縦3:4(672×928)、10秒設定、24fps |
| 参照 | キャラクターシート1枚、ゴルフ場1枚。参照動画・音声なし |
| ステップ | 総時間 | うちサンプリング(概算) | 結果 | GPU0 / GPU1 使用率(採取最大) |
|---|---|---|---|---|
| 8 | 8分38秒(517.968秒) | 約394秒 | 完走・音声あり | 100% / 100% |
| 10 | 10分10秒(609.643秒) | 約491秒 | 完走・音声あり | 100% / 100% |
| 12 | 11分44秒(703.555秒) | 約586秒 | 完走・音声あり | 100% / 99% |
| 14 | 13分13秒(792.848秒) | 約676秒 | 完走・音声あり | 100% / 100% |
| 16 | 15分20秒(920.058秒) | 約804秒 | 完走・音声あり | 100% / 100% |
| 18 | 18分16秒(1096.258秒) | 約980秒 | 完走・音声あり | 100% / 100% |
| 20 | 19分58秒(1198.082秒) | 約1082秒 | 完走・音声あり | 100% / 100% |
総時間は実行履歴の開始から成功までで、モデルのロードや保存を含みます。サンプリングはサンプラーの進捗表示から読んだ1秒単位の概算。使用率はnvidia-smiを約30秒間隔で採ったときの最大値で、平均ではありません。7本とも、FFmpegで先頭から末尾までデコードして終了値0を確認しています。
8ステップは、H3VMなし(1枚)の1,105.848秒(18分26秒)に対して517.968秒。2.13倍、53%の短縮です。同じPCで同じ条件を各1回ずつ比べた数字で、他の解像度や参照動画つきにそのまま当てはまる倍率ではありません。
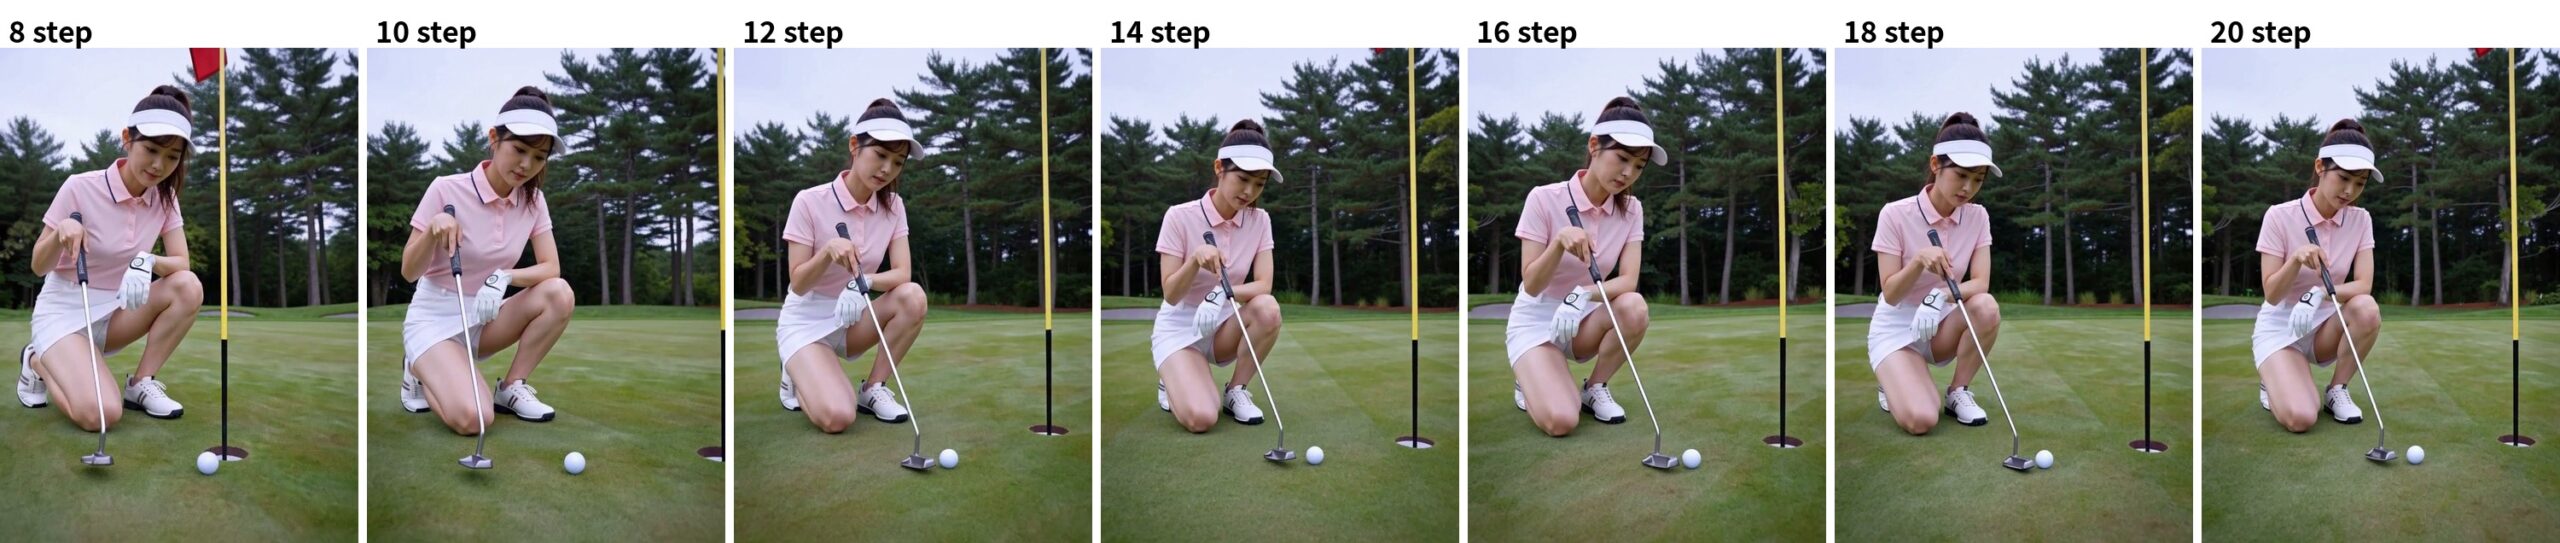
5秒時点のフレームをステップ順に並べたもの。どれも崩れていません。ステップを増やすほど良くなる、という採点はしていません(人物の形・ボールの位置・動作の精度は未評価)。
負荷を上げる: 0.8MPと15秒
修正を入れたまま、解像度と尺を上げてみました(10ステップ基準)。
| 解像度 | 尺 | ステップ | 結果 | 総時間 |
|---|---|---|---|---|
| 0.8MP(800×1056) | 10秒 | 10 | 完走・音声あり | 14分32秒(872.809秒) |
| 0.6MP(672×928) | 15秒 | 10 | 完走・音声あり | 16分20秒(980.379秒) |
| 0.8MP | 15秒 | 10 | GPU0がメモリ不足(OOM)。3ステップ目で停止 | — |
| 0.6MP | 15秒 | 20 | 完走・音声あり | 35分56秒(2,156.261秒) |
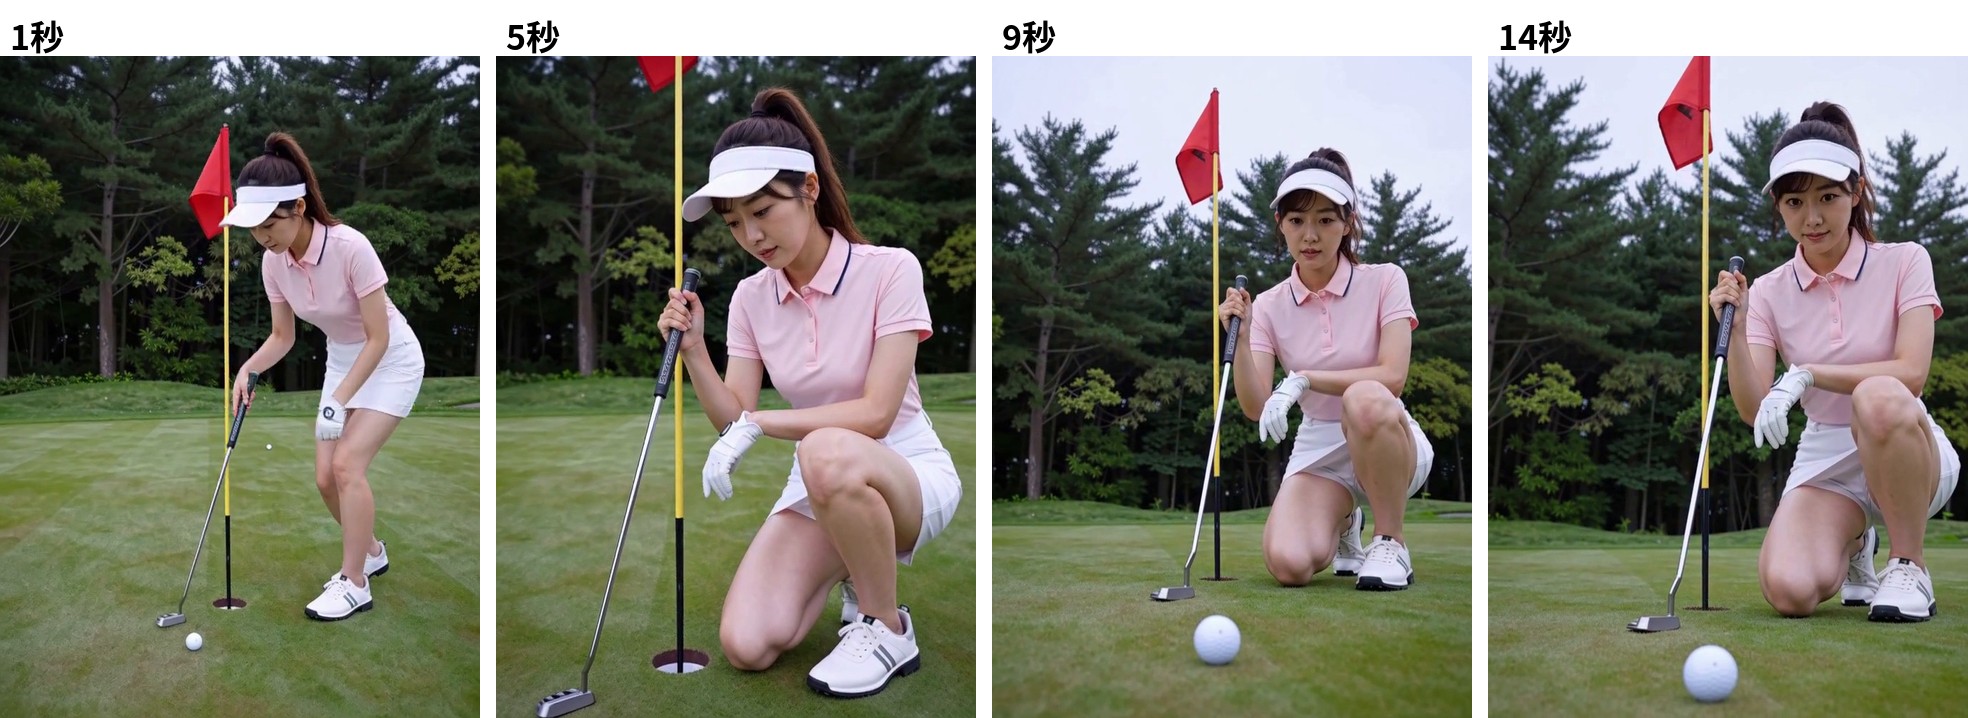
0.6MP・15秒・20ステップの1秒・5秒・9秒・14秒。最終動画は361フレーム・24fps・実尺15.04秒・AAC音声つき。
0.8MP・15秒では、GPU0がINT8のMLP用の作業領域(872MiB)を確保できずに止まりました。そのときGPU0は空き0、GPU1には余力が残っていた。16GB×2枚は「32GBの連続した空き」ではなく、GPUごとの割り当てが上限になる、というのが今回の結論です。OOMのあとモデル解放処理から戻らず、ComfyUIの再起動で復旧しました。
| 条件 | GPU0 / GPU1 VRAM採取最大(MiB) |
|---|---|
| 0.8MP・10秒・10ステップ | 14,005 / 15,082 |
| 0.6MP・15秒・10ステップ | 15,196 / 14,778 |
| 0.8MP・15秒・10ステップ(OOM) | 15,997 / 10,540 |
| 0.6MP・15秒・20ステップ | 15,955 / 12,920 |
各GPUの総量は16,311MiB。成功した条件でもGPU0は上限ぎりぎりで、同じ指定で常に余裕がある、とは言えません。
分かったこと
- 「成功」ステータスは画質の保証ではない。 修正前の8ステップは成功扱いでもやだった。抜き出したフレームを見るまで分からない。
- 保存ノードのエラーは、上流の数値異常のサインのことがある。 AACのNaN/Infは、エンコーダではなく2枚の結合順序が原因だった。
- 2GPUの同期は「待ち時間」ではなく「順序」。 依存関係を1本正しい位置に置くだけで直り、並列性は落ちていない。
- 16GB×2は32GBではない。 0.8MP・15秒はGPU0だけが先に溢れた。
- 第25回の「15秒が45分34秒」は参照動画つき。今回の0.6MP・15秒・10ステップは参照画像2枚で16分20秒、20ステップで35分56秒。条件が違うので倍率は出しません。
修正版のワークフロー(8〜20ステップ)は手元に保存し、デスクトップに20ステップ版のアイコンを置きました。H3VMを更新すると修正が上書きされる可能性があるので、再生成前に該当箇所の順序を確認する運用にしています。
まとめ
- 2GPU(H3VM)で絵がもやになる原因は、結合完了を待つ前に読み始められる順序と、ステップ数ヒントによる途中リセットの2つ。
- 2か所を直して、同じseedで8〜20ステップの7本が全部完走。8ステップは1枚の2.13倍。
- 0.6MP・15秒・20ステップが35分56秒で完走。0.8MP・15秒はGPU0のOOM。
- 16GB×2枚は、GPUごとの上限で決まる。
症状から対処を引く表はトラブル早見表に、機材ごとの所要時間は実測早見表にまとめています。
本記事の数値は2026年10月21日の当方環境(Windows・RTX 5060 Ti 16GB×2・ComfyUI 0.36.0・H3VM v0.21.1相当にローカル修正)の記録です。人物はAI生成です。
コメント