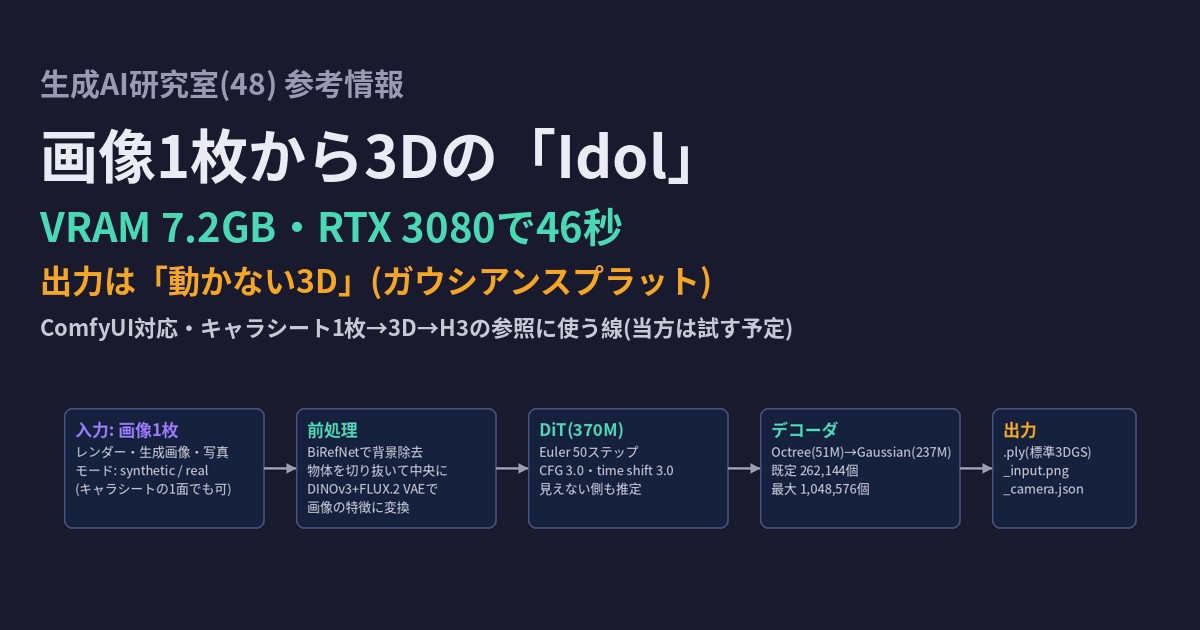
今朝、「VRAM 8GBで動く3D生成AI」として引用した投稿が、当方の投稿としては珍しく読まれました。まとめて読める日本語の一次情報整理が見当たらなかったので、公式の配布元を読んで1本にします。当方はまだ動かしていません。 動かしたら続報を書きます。
先に、今朝の引用で当方が書き間違えた点を直します。「3Dモデルと動きが作れる」と書きましたが、Idolが作るのは動かない3Dです。「45秒」は動きではなく、3Dモデル1個の生成時間でした。
Idolとは何か
speridlabs(スペリドラボ)が2026年10月29日に公開した、画像1枚から3Dの物体を作るモデルです。ライセンスはApache-2.0、重みとコードは公開されています。
出典: speridlabs/idol-sdk(GitHub)、speridlabs/idol(Hugging Face)
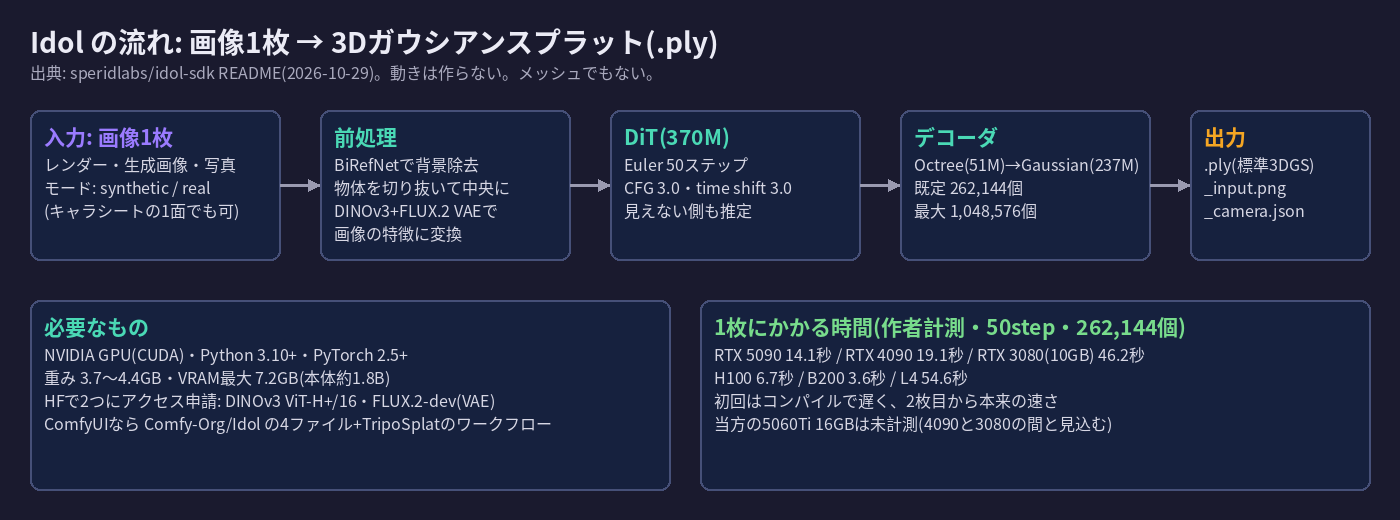
やることは単純です。
- 画像を1枚入れる(レンダー、生成画像、写真のどれでも)
- 背景を消して、物体を中央に切り抜く
- 画像の特徴を読んで、見えていない側も含めて3Dを推定する
- 3Dガウシアンスプラットとして
.plyに書き出す
中身は、TripoSplat(VAST-AI・MIT)を土台に学習し直したもので、画像の読み取りにDINOv3とFLUX.2のVAE、背景除去にBiRefNetを使っています。本体の規模は約1.8B(18億)パラメータ。重みは3.7〜4.4GBで、VRAMの最大使用は7.2GBと作者が書いています。
「ガウシアンスプラット」は、メッシュではない
ここが一番大事なところです。
Idolの出力は、Blenderでおなじみの「メッシュ」(頂点と面)ではありません。3Dガウシアンスプラットという、小さな半透明の楕円を何十万個も空間に置いて、見た目を再現する形式です。既定で262,144個、最大で1,048,576個の楕円を使います。
できること:
- 専用のビューアで、物体をぐるぐる回して見る(見た目はきれい)
- 標準の
.plyなので、対応するソフトやBlenderのアドオンで読み込める
できないこと(そのままでは):
- メッシュとして編集する、リグを入れて動かす
- 動きの生成。Idolはアニメーションを作りません。
つまり「キャラシート1枚から、動くキャラが出てくる」道具ではなく、「キャラシート1枚から、回して見られる立体が出てくる」道具です。
どのGPUで、何秒か
作者がGPUごとに計測した表を、消費者向けのGPUだけ抜き出します(50ステップ・262,144個・8枚の中央値)。
| GPU | VRAM | 1枚の生成時間 |
|---|---|---|
| RTX 5090 | 32GB | 14.1秒 |
| RTX 4090 | 24GB | 19.1秒 |
| RTX 3080 | 10GB | 46.2秒 |
参考に、データセンター向けはB200 3.6秒・H100 6.7秒・L4 54.6秒です。今朝の引用元の「VRAM 8GBで45秒」は、この表の3080の帯と合っています。
注意が2つ。1枚目はPyTorchのコンパイルが走るので遅く、2枚目から本来の速さになります。それと、当方のRTX 5060 Ti 16GBは表にありません。4090と3080の間と見込みますが、計測してから書きます。
作者のベンチマーク
同じH100で、TripoSplat・TRELLIS・LGMと並べた表が公開されています。Idolは入力画像との一致(SSIM・LPIPS・IoU)と、別の角度から見たときの一貫性(DINOv2・CLIP)で最良、1枚6.8秒(TripoSplatは9.9秒)。PSNRだけはLGMが上ですが、作者自身が「LGMはぼけているのにPSNRが高く出る」と注記しています。作者計測であることは添えておきます。
動かすのに必要なもの
- NVIDIAのGPU(CUDA)、Python 3.10以上、PyTorch 2.5以上。コードはCUDAがなければCPUに落ちますが、高速化はCUDA前提です。Macは公式の対応表記にありません。
- Hugging Faceで2つにアクセス申請が要ります: DINOv3 ViT-H+/16(Meta)と、FLUX.2-dev(Black Forest Labs)のVAE。申請して
hf auth loginしてから、初回実行で重みが落ちてきます。 - コマンドは1行です。
python -m idol.sample --image photo.jpg --mode real。CG画像なら--mode synthetic(既定)。
ComfyUIで動かす
TripoSplatは2026年6月1日にComfyUI本体がネイティブ対応しています(v0.23.0・テンプレート「TripoSplat」)。IdolはそのTripoSplatの改良版なので、既存のTripoSplatワークフローのモデルを差し替えるだけで動く、というのがComfy-Orgの説明です。
Comfy-Orgが再パッケージした4ファイルが11月2日に公開されています(Comfy-Org/Idol)。
| 置き場所 | ファイル |
|---|---|
| models/diffusion_models/ | idol_fp16.safetensors |
| models/clip_vision/ | dino_v3_vit_h_bf16.safetensors |
| models/vae/ | flux2-vae.safetensors |
| models/vae/ | idol_decoder_fp16.safetensors |
別途、有志のカスタムノード(ComfyUI-Idol)も2つ出ています。当方はまず公式テンプレートの差し替えから試します。
当方の線: キャラシート1枚→3D→参照動画
このサイトで続けている「Blenderで作ったセットや人形を参照動画にして、MiniMax H3に渡す」線(第11回・第14回)に、Idolはこう刺さります。
- 今は、キャラの立体はBlenderで手作りするか、既製の人形を使っている
- Idolなら、キャラクターシートの正面1枚から、回して見られる立体が数十秒で出る
- その立体をビューアかBlenderで回した映像を、H3の参照動画にする——構図と向きの指示を、文ではなく絵で渡せる
できないことも書いておきます。スプラットはメッシュではないので、Blenderでポーズを付けて踊らせる、という使い方はそのままではできません。「動き」はこれまでどおり、実写の参照動画かBlenderのリグから持ってくることになります。
クリスマス向けに考えている企画(キャラシート編→動画編)は、この線で組めるかを先に試します。
試す順番
- 5060 Ti 16GB×2のデスクトップで、公式テンプレート差し替え版を動かす(所要秒・VRAMを記録)
- 白チャイナのキャラシート正面1枚で生成→ビューアで回す→壊れ方を見る(背中・髪・手)
- 回した映像をH3の参照にして15秒を1本——構図が通るか
結果が出たら、同じ型で続報を書きます。動かなかったら、動かなかったと書きます。
本記事は公開情報(GitHub・Hugging Face・ComfyUI公式ブログ)の整理で、数値はすべて作者の公表値です。当方の実測は含みません。
コメント