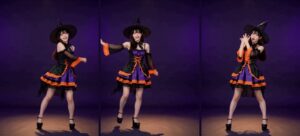
昨日の記事で仕組みを読んだComfyUI-Tesseraを、同じ日のうちにデスクトップ(RTX 5060 Ti 16GB×2)で動かした。素材はハロウィン後編の25ステップ版(672×928)。まず全編ではなく、手が顔の前で交差する8〜11秒の3秒(72枚)だけを2倍の1344×1856に再生成し、同じ3秒をSwinIR・Bicubic・RealESRGANの2倍拡大と並べた。
入れたもの
- ノード: hashu786/ComfyUI-Tessera。追加のPython依存なし、ComfyUI本体とH3VMのコードは触っていない。
- モデルは現役のまま: H3 ref2va int8 convrot、fp16の動画VAE、fp32の音声VAE、Qwen3-VL NVFP4 AWQ。
- 追加したのは2つのLoRA。頭の1ステップ用の TaoMate 3Step LoRA(1.0)と、細部用の LMS detail LoRA(頭0.75・尾1.0)。配布元のSHA-256を照合した。
- 設定: sigma 1→0.7→0.4→0の3ステップ(頭 er_sde 1段+尾 Euler 2段)、cfg 1。spatial/temporal とも low_vram。タイルは2×3=6枚(実行時768×704)で、各3段階の計18段階。Lanczosで2倍にした板を39枚単位でストリームエンコード。アンカー画像・SAM・RIFEは使っていない。motion_adapt は有効で、動きが大きい区間なので guide_release は0.8の設定から実効0.0に絞られた。flat_skip は4だが、6タイルとも平坦ではないので全部が再描画された。参照は元のカラー動画(深度動画は使わない)。
1本目: ホストRAMの柵で止まった
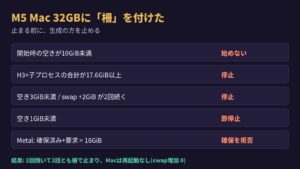
最初は全部をGPU0に置いた標準構成で投入した。13:59、物理RAMの空きが2.9GiBまで下がり、既存のホスト保護(空き3GiB未満で停止)が働いて止まった。コミットは92.6/127.8GiB。GPUのメモリ不足ではない。64GiBのRAMの機械で、3秒の2倍でこれになる。
2本目は、テキストエンコーダ(Qwen3-VL)を SelectCLIPDevice でGPU1に置き、H3と動画VAEはGPU0のままにした。H3VMの「双卡扩容」でモデルを割るのとは別の、ただの置き場所の分担だ。
2本目: 22分51秒で完走
14:01に投入して14:24に完了。総時間1,371.8秒(22分51.8秒)。内訳は、ストリームエンコードがコンソール表示で152秒、Refineが18/18で進捗表示17分56秒(タイルの準備やデコードを含む)。
| 項目 | 値 |
|---|---|
| 対象 | 8.000〜10.958秒・72枚・24fps |
| 出力 | 1344×1856・H.264・音声あり |
| 総時間 | 22分51.8秒 |
| VRAM採取最大 | GPU0 11,394MiB / GPU1 12,650MiB |
| GPU温度最大 | 68℃ / 60℃ |
| 物理RAM空き最小 | 3.809GiB |
| コミット採取最大 | 107.4GiB(1本目より大きい) |
| OOM警告 | 0 |
成功した2本目のコミットは、止まった1本目より大きい。だから「メモリの使用量を減らして解決した」のではなく、「置き場所を変えたら、保護の内側で完走した」が正しい。物理RAMの空き最小3.8GiBは、停止線3GiBのすぐ上で、全編15秒や4倍がこのまま通る保証はない。
細かい話を1つ。H3の入力は17k+5枚の制約があり、72枚をそのまま渡すと56枚に切られる。そこで11秒ちょうどの1枚を足した73枚で処理し、先頭72枚を保存した。時間の伸縮はない。
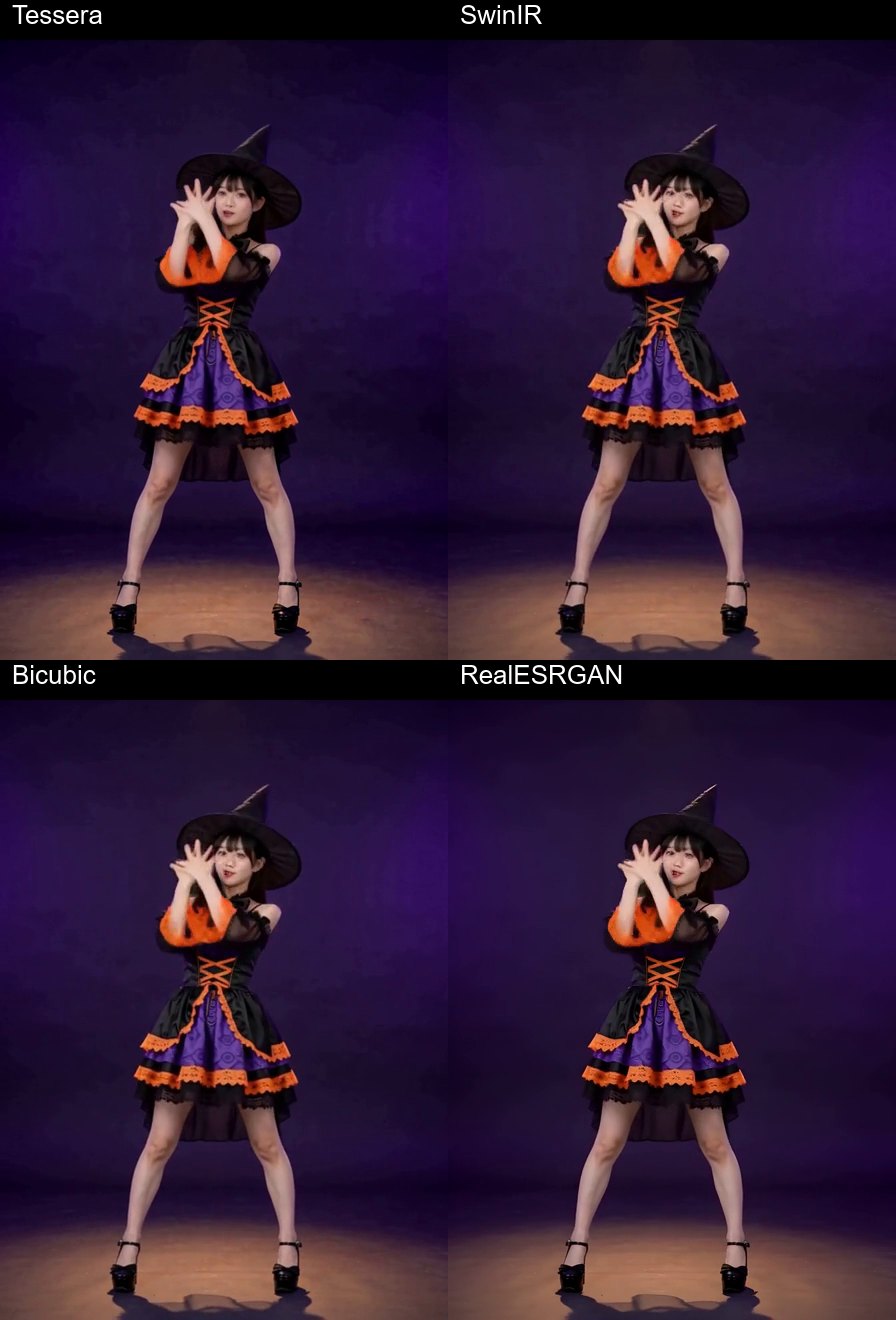
4方式を並べる
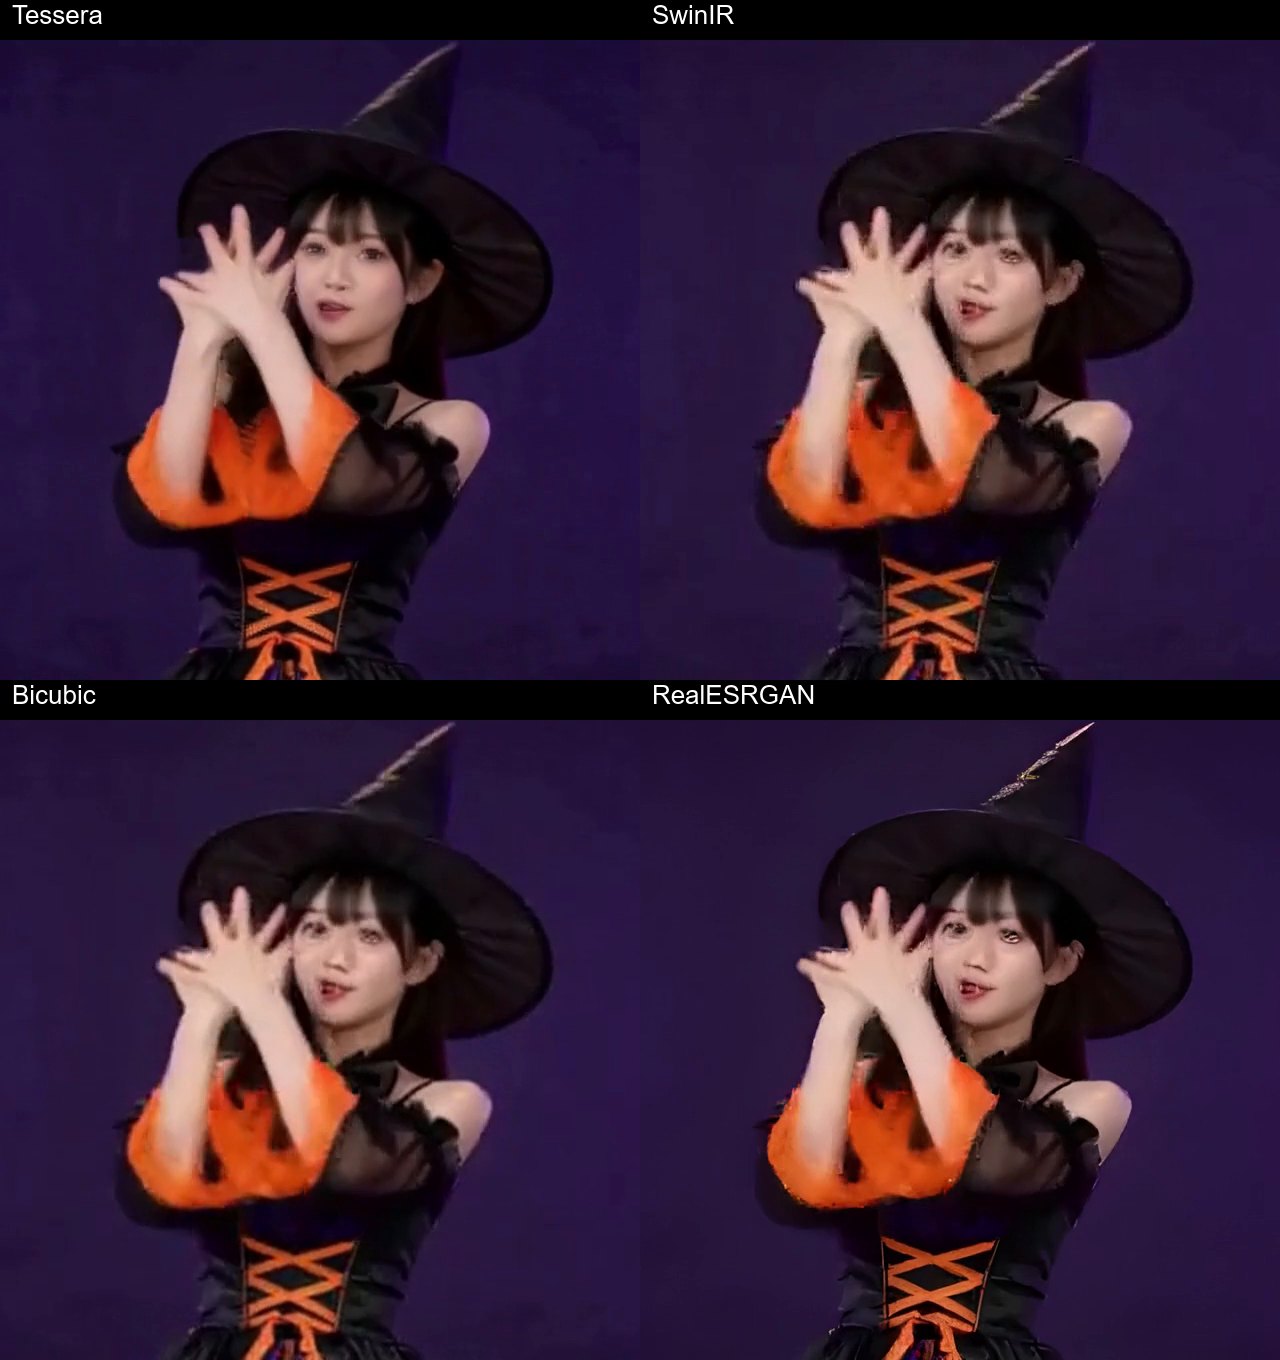
同じ3秒・72枚・同じ音声(PCMのSHA-256が4本とも一致)で、Tessera・SwinIR・Bicubic・RealESRGANの2倍を並べた。
見えたこと。
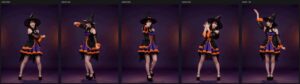
- Tesseraは、SwinIRとBicubicにあるざらつきと粗い輪郭が減り、RealESRGANの硬い輪郭とも違う、なめらかな仕上がり。9.5秒の手元では、Tesseraだけ肌がなめらかで目鼻が明瞭、手の輪郭が読める。
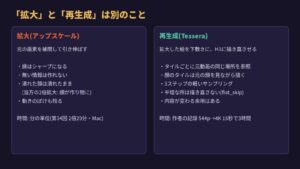
- 一方で、9.5秒の目・口・輪郭と、10.875秒の手と顔の重なりは、元の形から描き変わっている。元の情報を正確に復元したのではなく、「元を見ながら描き直した」結果だ。
- 速い手のぼけと、重なった指の判別の難しさは残る。
- 9.5秒の全身では紫のスタジオと衣装の色が保たれ、タイルの境界は目立たない。ただし全72コマのちらつきが消えたかは判定していない。
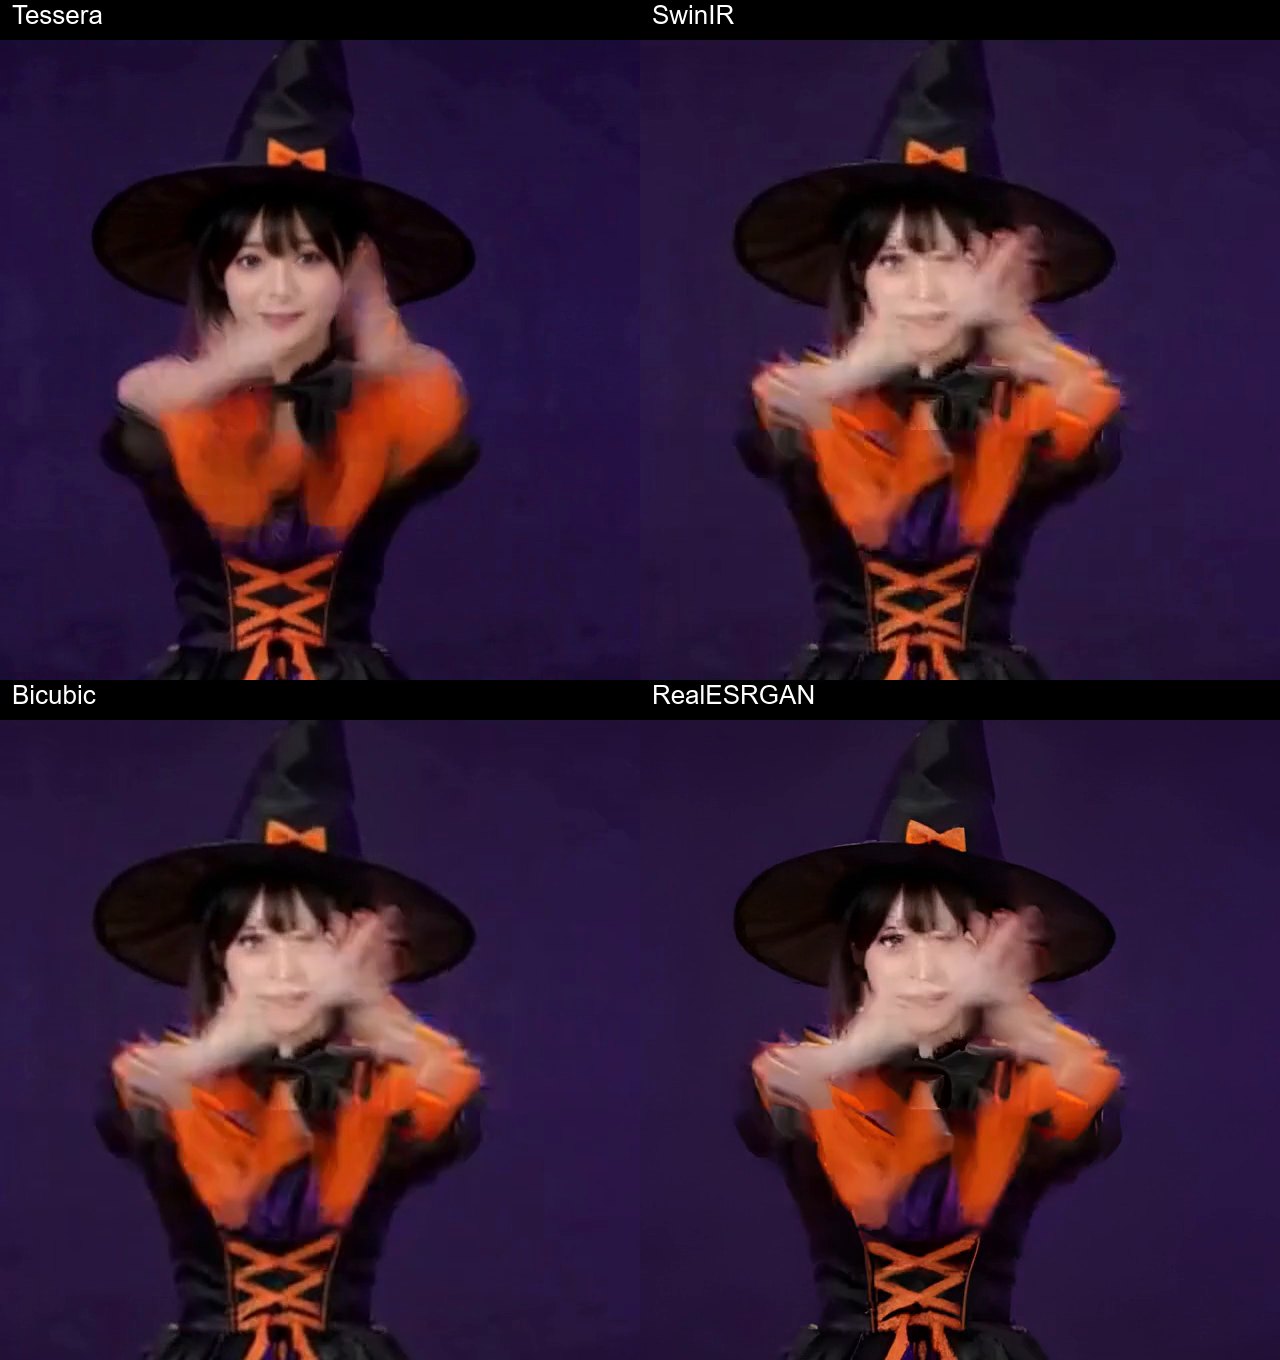
通しで見た当方の印象は、「多少よくなる程度で、劇的ではない」。それより目についたのは機械への要求の高さで、ここまでに2回止まっている。使い続けるなら、タイルや置き場所のノード調整が前提になる。
今回はアンカー画像なし・動きが大きい区間で細部の解放が実効0、という条件なので、Tesseraの上限を試した結果ではない。
分かったことと、次
- 分かったこと: 16GB×2で、3秒の2倍は22分52秒で通る。先に当たるのはGPUではなくホストRAMの柵。顔はなめらかになるが、形は変わり、効果は劇的ではない。
- 分かっていないこと: 全編15秒と4倍。ちらつき。アンカー画像(2xで有効とされる)を使った場合。
- 次: 視聴評価を踏まえて、全編化か、アンカーありの短区間比較のどちらかを選ぶ。
関連: 第45回 Tesseraの仕組みを読む / 後編(42) / 第43回 Macの柵 / 第27回 2枚挿しとアップスケール / 出典: GitHub hashu786/ComfyUI-Tessera
コメント