前回(第3弾)まで、魔女のダンスはデスクトップ(RTX 5060 Ti 16GB×2)とMacで焼いてきました。今回は同じプロンプト・同じseedを、クラウドGPU(RunPod)のRTX PRO 6000 Blackwell(96GB)で、条件を1つずつ変えながら7本焼きました。1日分の時間と費用、メモリ、止まった1本、そして見た目を並べます。
使ったもの
| 項目 | クラウド(RunPod) | デスクトップ(当方) |
|---|---|---|
| GPU | RTX PRO 6000 Blackwell Server ×1(VRAM 97,887MiB) | RTX 5060 Ti 16GB ×2 |
| CPU/RAM | 48 vCPU/283GB | i7-11700K/64GB |
| 料金 | $2.49/h+コンテナ200GB $0.028/h=$2.52/h | — |
| 環境 | PyTorchテンプレートにComfyUI 0.43.0を自分で導入 | ComfyUI(H3VMで2枚使い) |
| モデル(bf16の5本) | minimax_h3_ref2va_bf16+qwen3vl_32b bf16、LoRAなし、res_multistep | — |
| モデル(量子化の2本) | デスクトップと同じ pruned_int8_convrot+nvfp4_awq+Turbo 8step LoRA、euler | 同左 |
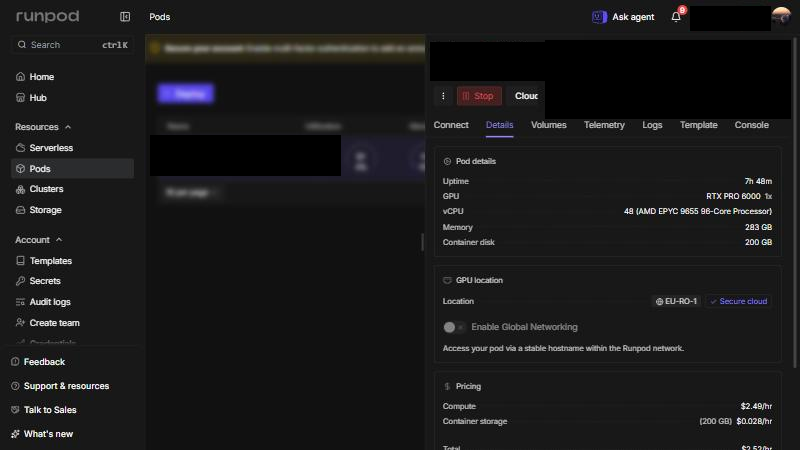
準備に34分、焼き始めるまで
Podを立ててから1本目を投入するまで、約34分かかりました。内訳は、ComfyUIの取得と依存の導入、モデル4点(生成モデル66.3GB・テキストエンコーダ51.5GB・VAE 5.8GB=計123.6GB)のダウンロード、カスタムノード7パック、ポートの変更、ワークフローと素材の登録です。
意外だったのはダウンロードの速さで、123.6GBが70.7秒。Hugging Faceの高速転送を使うと、クラウド側はこの速度で届きます。準備時間の大半は、モデルではなく環境づくりでした。手順を固めれば、準備は数分の帯まで縮む見込みです(未検証)。
7本の結果
変えた条件は1本につき1つです。時間はすべてサーバーのログと履歴の値(画面の丸めではありません)。
| 本 | 変えた条件 | 参照動画 | 出力 | 秒/ステップ | 総時間 | 結果 |
|---|---|---|---|---|---|---|
| 1 | 基準(0.6MP・bf16) | 540×720 縦・縮小版 | 672×928 | 71.0 | 32分00秒 | 完走 |
| 2 | 出力を1.0MPへ | 同上 | 896×1184 | 131.0 | 57分37秒 | 完走 |
| 3 | 参照を横1280×720へ | 1280×720 横 | 896×1184 | 233.6 | 1時間42分58秒 | 完走 |
| 4 | 参照を縦クロップへ | 540×720 縦・クロップ | 896×1184 | 131.0 | 57分27秒 | 完走 |
| 5 | 参照をグレー背景へ | 540×720 縦・クロップ・背景除去 | 896×1184 | 131.0 | 57分28秒 | 完走 |
| 6 | 量子化構成(cu128) | 同上 | — | — | 54秒 | 初回ステップ前にOOM |
| 7 | 量子化構成(cu130に更新) | 同上 | 896×1184 | 113.0 | 49分53秒 | 完走 |
25ステップ・15秒・24fps・同じseed・同じプロンプト(937語)。1本目を100%とすると、総時間は2本目180%・3本目322%・4本目180%・5本目180%・7本目156%。
数字から読めること
出力の画素数と時間。 0.6MP(623,616画素)→1.0MP(1,060,864画素)で画素は170%、秒/ステップは184%でした。ほぼ画素数なり、少し上乗せ。
参照動画の画素数は、前処理と各ステップの両方に効く。 参照を540×720(388,800画素)から1280×720(921,600画素・237%)にすると、秒/ステップは178%、前処理は408%(50.6秒→206.8秒)。第3弾で「参照の負荷は色ではなく画素数×コマ数」と書いたことが、クラウドでも同じ形で出ました。
参照の作り方は、時間に出ない。 同じ540×720でも、縮小版(2本目)・クロップ版(4本目)・クロップ+背景除去(5本目)の3本は、サンプリング時間が3,275.4秒・3,275.4秒・3,276.0秒で、差は最大0.634秒(0.02%)。中身を変えても、画素数が同じなら時間は同じです。
bf16と量子化。 同じ参照・同じ解像度で、量子化構成(7本目)はbf16(5本目)に対して秒/ステップ86%・総時間87%、生成中のGPUメモリ57%(96.7GB→54.9GB)、ホストRAM 35%(132GB→45.6GB)。
メモリ: 96GBでも、bf16は載り切っていない
bf16の5本では、生成中のVRAMが96,725〜96,733MiB/97,887MiB(98.8%)で張りつき、ComfyUIのプロセスがホストRAMを132GB使っていました。生成モデル63GB+テキストエンコーダ49GB+VAE 6GBは96GBを超えるので、載り切らない重みをホストRAMに置いてストリーム転送する構成(起動ログに「async weight offloading」「DynamicVRAM」)で動いています。それでもOOMはなく、スワップは領域ごとありませんでした。
量子化の7本目は、VRAM 54.9GB・RAM 45.6GBで、96GBの中に余裕を残して動いています。
止まった1本: cu128でOOM、cu130で完走
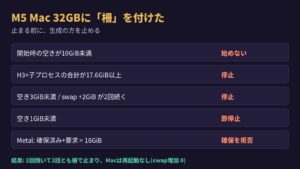
6本目は、デスクトップと同じ量子化構成(int8の生成モデル・nvfp4のテキストエンコーダ・Turbo LoRA・euler)をそのまま投入したところ、初回ステップの前で torch.OutOfMemoryError で止まりました(54秒)。ログを見ると、PyTorchが2.8.0+cu128で、ComfyUIの量子化バックエンドが「cu130以上が必要」と警告を出し、eager(汎用)実装のint8線形層の中で失敗しています。
PyTorchを2.14.1+cu130に上げてComfyUIを再起動した7本目は、同じワークフローで完走しました。再起動でVRAMの初期状態も変わっているので、cu130の効果だけとは言い切れません。デスクトップがcu130で動いていたのは、たまたまではなく必要条件だった、というのが今回分かったことです。
見た目: 7秒までは揃い、10秒から割れる
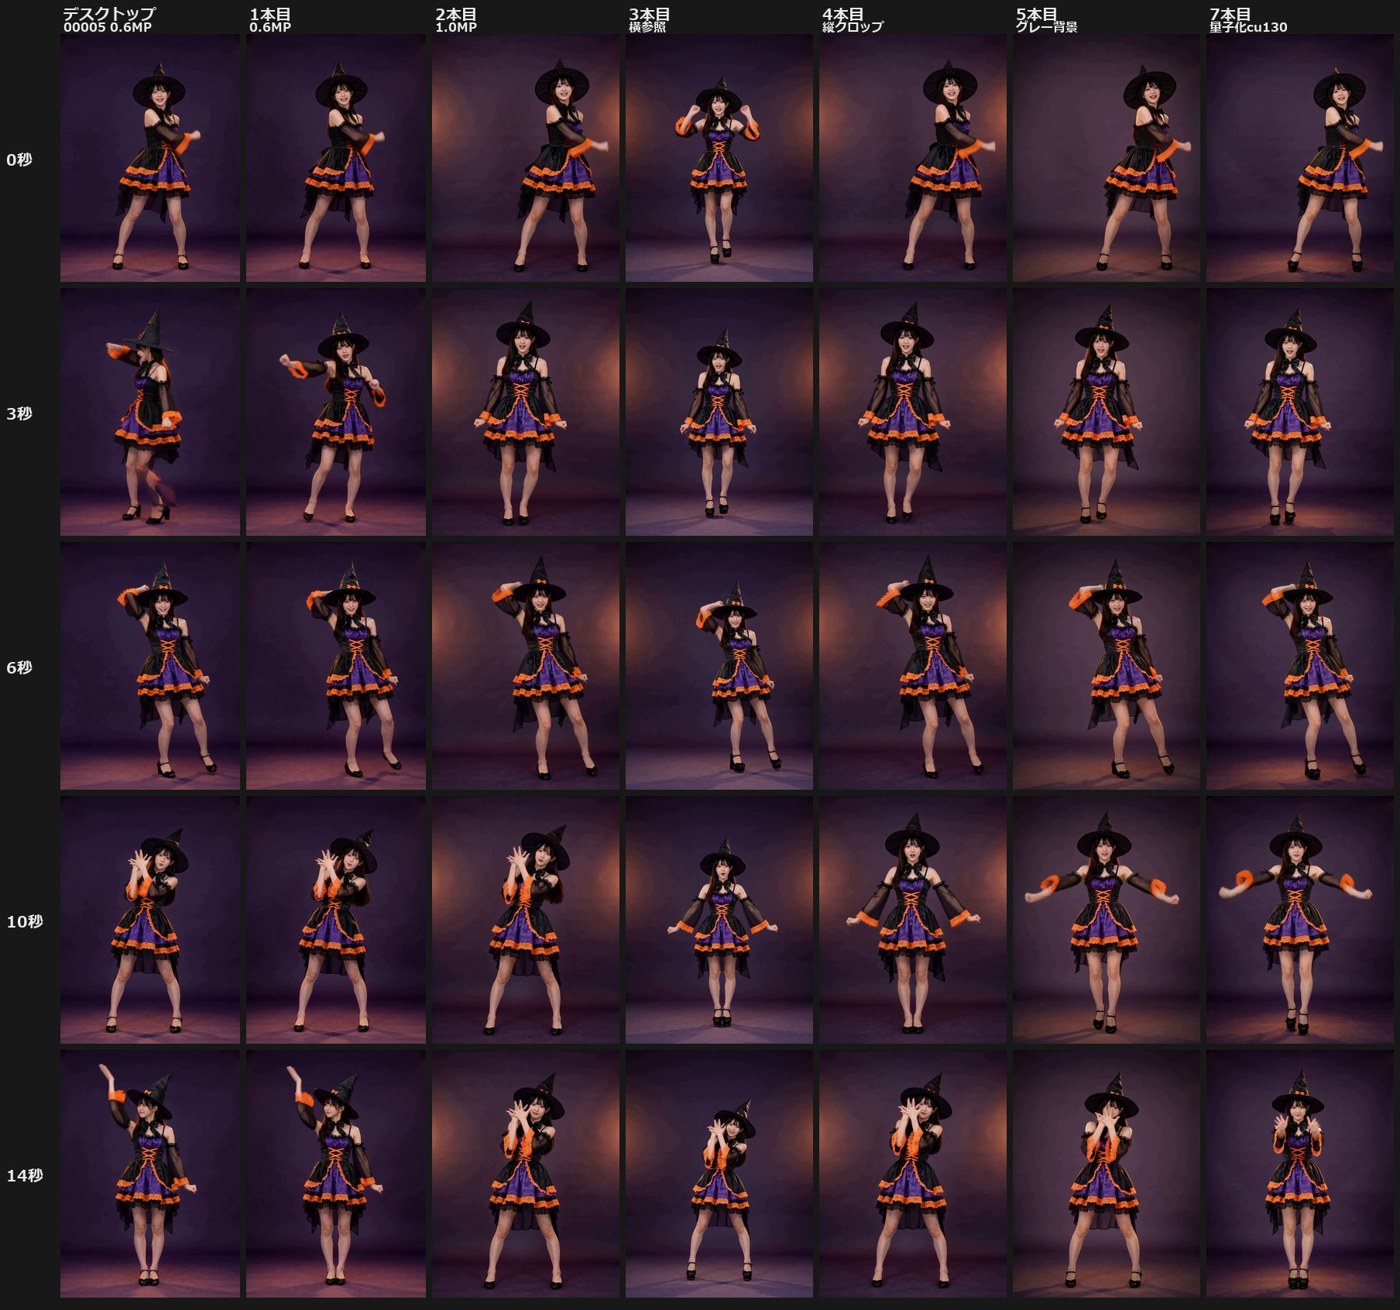
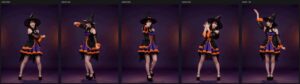
保存した毎秒のコマで、参照との主要ポーズを照合しました(骨格の数値計測ではなく目視。時間をずらして合わせる操作はしていません)。
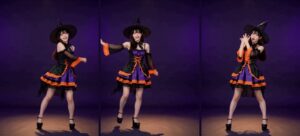
- 0〜7秒は7本とも主要ポーズが対応。 腕を横へ、正面で腕を下げる、片腕を画面左へ、片手を頭の後ろへ、の流れは全部にあります。
- 3秒: 参照は正面で両腕を下げています。デスクトップと1本目(0.6MP)は横向きで片腕を前へ出し、2〜7本目(1.0MP)は正面。1.0MPのほうが参照に沿っています。
- 10秒(顔の横で両手を開く): デスクトップ・1本目・2本目は一致、3・4・5・7本目は両腕を下げていて不一致。
- 13〜14秒: デスクトップと1本目は「一部一致」、2〜7本目は不一致(顔の横や前に両手)。後半は0.6MPの2本が参照に近く、1.0MPの5本は別の動きに流れました。 解像度の違いか、たまたまかは、この本数では決められません。
- グレー背景(5本目)は、クロップ版(4本目)と8〜12秒・14秒で主要ポーズが違います。 背景を消しただけで動きが変わりましたが、背景除去が原因だと確定したわけではありません。
- bf16(5本目)と量子化(7本目): 7秒までは対応、12秒で手の形(拳と開いた掌)、13〜14秒でポーズが違います。衣装の紫・橙・黒は両方で保持。
- デスクトップと1本目(同じ0.6MP・同seed・ただしモデル構成は別): 15秒のうち10秒で主要ポーズが一致。
- 「5〜6秒で指を一本ずつ開く」の指定は、7本とも確認できませんでした。 毎秒のコマでは、開始秒もどの指からかも判定できません。
- 帽子は確認した全コマで頭上。色は全本で保持。終盤の白化はなし。口の動きと歌の同期は未検査。
費用
- 生成した時間だけなら、7本で5.97時間・$15.05(単価からの計算値)。
- Podを立ててから止めるまで(Uptime約7時間49分)なら$19.70(計算値)。管理画面の請求表示は1時間遅れで$17.11でした。
- 準備34分・生成76%・残りは待ちと回収。クラウドでは「焼いていない時間」も課金されるので、1本だけ焼きに行くと準備代が重くなります。
デスクトップの同じ量子化構成・25ステップ・0.6MPは1時間29分55秒。クラウドの量子化・1.0MP(画素170%)は49分53秒。出力画素が違うので同条件比較ではありませんが、1時間30分の仕事が1ドルの帯で返ってくる、というのが今回の体感です。
まとめ
- RTX PRO 6000(96GB)・$2.52/hで、準備34分、0.6MPで32分、1.0MPで58分、参照を横にすると103分。
- 参照動画の画素数は前処理と各ステップの両方に効き、参照の作り方(縮小・クロップ・背景除去)は時間に出ない(差0.02%)。
- bf16は96GBでも載り切らず、ホストRAMに132GBを置いて動く。量子化はVRAM 57%・RAM 35%で、時間も87%。
- 量子化構成はcu128で初回ステップ前にOOM、cu130で完走。
- 見た目は7秒まで7本とも揃い、10秒以降で版ごとに割れた。後半は0.6MPの2本が参照に近かった。指の順序は7本とも確認できず。
- 1日で$19.70。生成だけなら$15.05。
次は、クラウドで8ステップ(Turbo LoRA本来の設定)と、指の順序が出る条件の切り分けです。
本記事の数字は2026年11月3日の当方の記録(サーバーログ・履歴・管理画面)です。費用は単価からの計算値で請求実績ではありません。見た目の判定は毎秒のコマの目視で、骨格の計測ではありません。動画は当方の生成物で、参照にした実写は載せていません(振付: まなこ)。
コメント