MiniMax H3の「モデル」は、この3か月で本体3種から数十のファイルに増えました。本体の種類、軽くした版、別物に仕立て直した派生、差し替えられる部品——が混ざって配布されているので、初めて見る人には「どれを落とせばいいか」が分かりにくい。このサイトでも第1回から第56回まで、その時々のものを使ってきました。
この記事は、それを1枚の表にします。列は「何が違うか」「配布元とサイズ」「当方の機材(RTX 5060 Ti 16GB×2・M5 Mac 32GB・クラウド)で載ったか」「所要時間の実測」。数字は配布元の公表値と当方の実測で、試していないものは試していないと書きます。
0. 先に用語
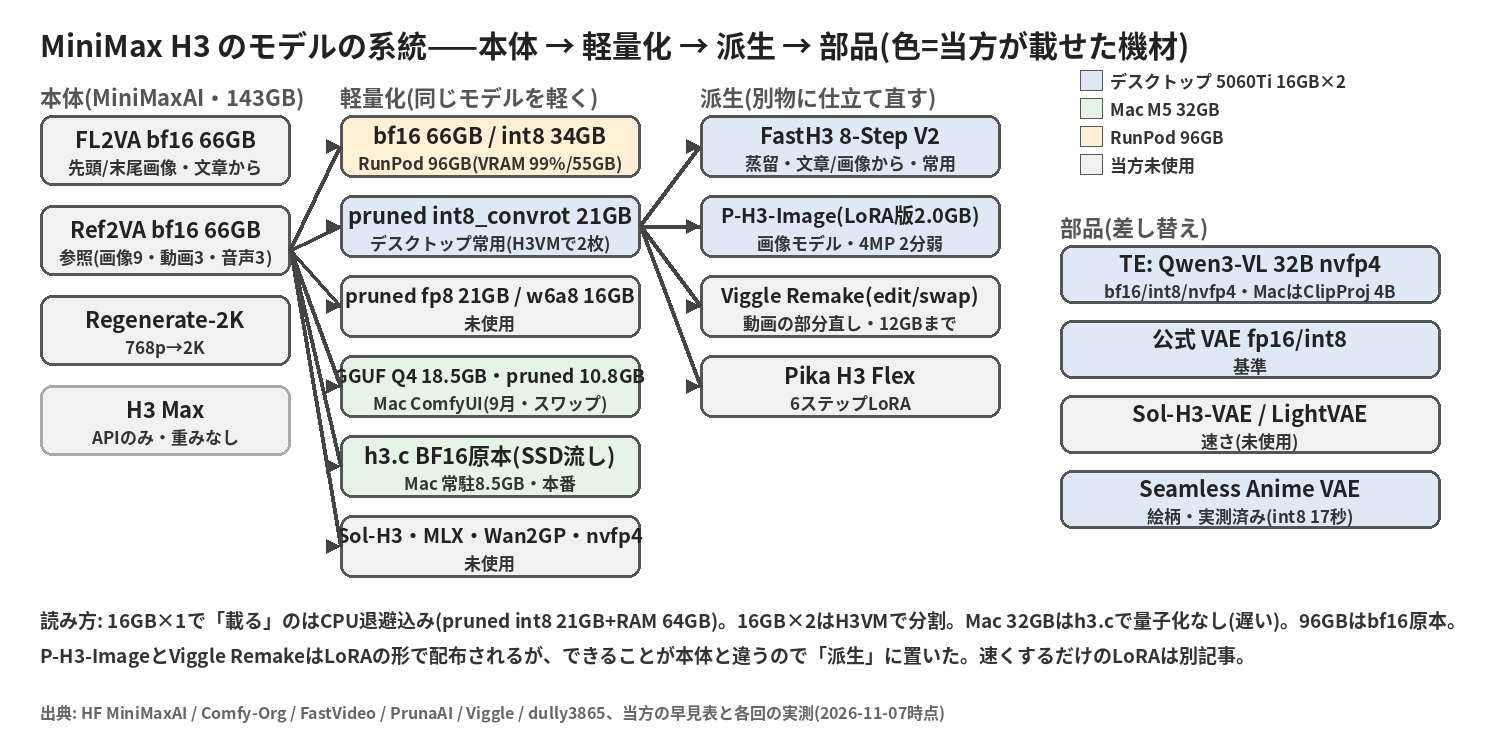
- FL2VA / Ref2VA: 本体の2つの型。FL2VAは「先頭・末尾の画像から(画像なしなら文章から)」、Ref2VAは「参照素材(画像9枚まで・動画3本・音声3本)から」。当方の参照動画の線は全部Ref2VA。
- pruned: 層を間引いた軽量版。66.3GB→40.2GB(bf16)。Comfy-Orgの配布。
- int8_convrot / fp8_scaled / w6a8: 重みの精度を落とす量子化。int8_convrotが推奨(cu130が要る)、fp8はcu130が使えない場合、w6a8はさらに小さい(16GB)。
- GGUF: llama.cpp系の量子化形式。Q4_K_Mなど。MacのComfyUIや、stable-diffusion.cppで使う。
- テキストエンコーダ(TE): 文章を読む部分(Qwen3-VL 32B)。本体と別ファイルで、bf16 / int8 / nvfp4(nvfp4はBlackwell以外でも動く、と配布元)。
- VAE: 最後に絵に戻す部分(第51回)。
1. 本体(MiniMaxAI公式)
出典: MiniMaxAI/MiniMax-H3。約33B、重み一式143GB、MiniMax H3 Community License。出力は4〜15秒・24fps・短辺768p・32kHzステレオ音声。
| モデル | 何をする | 公開の形 |
|---|---|---|
| H3-Base-FL2VA | 文章/先頭画像/先頭+末尾画像→動画+音声 | 重み公開 |
| H3-Base-Ref2VA | 画像≤9・動画≤3・音声≤3の参照→動画+音声 | 重み公開 |
| H3-Regenerate-2K | 768pの結果を文脈ごと入れ直して2Kに | 重み公開(当方未使用) |
| H3-Context-IR | 入力を読み替える前処理(公式のプロンプト書き直し) | ホスト側の仕組み。重みではない |
| H3 Max | 上位版 | APIのみ(ComfyUIにAPIノード6種・11/2)。ローカルの重みなし |
当方が使っているのはFL2VAとRef2VAの軽量化版だけです(下記)。
2. 軽量化版(同じモデルを軽く)
2-1. Comfy-Org(ComfyUI用の再パッケージ)
出典: Comfy-Org/MiniMax-H3(11/7時点のdiffusion_models)。FL2VAとRef2VAで同じ6種類。
| ファイル | サイズ | 当方 |
|---|---|---|
| bf16 | 66.3GB | RunPod RTX PRO 6000 96GBで使用(第49回・VRAM 98.8%+RAM 132GB) |
| int8_convrot | 34GB | RunPod(cu130)で使用(同・VRAM 54.9GB) |
| pruned bf16 | 40.2GB | 未使用 |
| pruned fp8_scaled | 21GB | 未使用 |
| pruned int8_convrot | 21GB | デスクトップ(5060 Ti 16GB×2)の常用。Ref2VA(第22回〜)、FL2VA(第55回) |
| pruned w6a8 | 16GB | 未使用(1か月前に追加) |
テキストエンコーダ: Qwen3-VL 32Bの bf16 / int8_convrot / nvfp4_awq(当方はnvfp4)。VAE: 映像fp16・int8、音声fp32。
2-2. GGUF(Mac・stable-diffusion.cpp向け)
| ファイル | サイズ | 当方 |
|---|---|---|
| 本体 Q4_K_M | 18.49GiB | Mac(ComfyUI)で87分/5秒・スワップ常時(早見表) |
| 本体 pruned Q4_K_M | 10.77GiB | Mac(ComfyUI)+ClipProj 4Bで40分03秒/5秒・スワップ最大52GB |
| ClipProj 4B(軽量TE) | 約5.0GB | Macで使用(15.4GB→5.0GB) |
配布元はrealrebelai・unsloth・Abiray・molbal・leejet(stable-diffusion.cpp作者)など複数。当方の数字は9月のもので、以後MacはGGUFを使っていません。
2-3. h3.c(Mac・量子化なし)
antirez/h3.c。C+Metalで、Pythonなし。BF16の原本をSSDから流して動かすので、M5 Mac 32GBで最大常駐8.5GB。0.6MP・5秒・8ステップで26分04秒、15秒で2時間19分、0.8MP・15秒・20ステップで10時間14分(早見表)。当方のMacの本番はこれです。
2-4. その他(当方未使用・配布元の説明)
- DeepBeepMeep/MiniMax-H3・Wan2GP: 低VRAM向けの包装。
- nvfp4本体(lilcheaty・Abiray): Blackwell向けの4bit。
- MLX移植(PipeNetwork/minimax-h3-mlx・Phosphene): Macの学習と生成。
- Sol-H3(NVlabs): 「RTX 5090 1枚かDGX Sparkで音つきH3」のエンジン。Sol-H3-VAE(デコーダ)とLTX latentアダプタが部品として公開。
3. 派生モデル(別物に仕立て直したもの)
| モデル | 配布元 | 何が違う | サイズ | 当方 |
|---|---|---|---|---|
| FastH3 8-Step V2 | FastVideo(Comfy版: FastVideo-FastH3-Comfy) | 8ステップ固定の蒸留。文章/画像から。参照からは対象外 | pruned int8 22.13GB | デスクトップで常用(0.6MP・15秒 8分21秒)。第22回 |
| P-H3-Image | PrunaAI | H3から切り出した画像モデル。8MP・8ステップ・編集8枚入力 | フル20〜55GB / LoRA版2.0GB | LoRA版をFL2VA int8に載せて4MP 1枚94〜141秒(第55回) |
| Viggle Remake | Viggle | H3に載せる2つのLoRA(edit/swap)で動画の部分直し。ComfyUIノード+int8/GGUFで12GBまで | LoRA 5.5GB(rank128で1.34GB) | 未使用(11/5公開) |
| Viggle Animate | Viggle | Remakeの前身(人物の置き換え) | — | 未使用 |
| Pika H3 Flex | Pika(Comfy-Orgに同梱) | 6ステップ向けの単一LoRA(FL2VA/Ref2VA各v1) | — | 未使用 |
ここで「LoRA」と「モデル」の境目がぼやけます。P-H3-ImageとViggle Remakeは、LoRAの形で配られているが、できることが本体と違うので派生モデルに入れました。速くするだけのLoRAは次回のLoRA一覧に回します。
4. 部品(差し替えられるVAE)
| VAE | 配布元 | 目的 | 当方 |
|---|---|---|---|
| 公式 H3 VAE(fp16/int8) | MiniMaxAI / Comfy-Org | 基準 | 常用 |
| Sol-H3-VAE | NVlabs | 速さ(36層→24層蒸留・5秒768pが12.5→5.0秒@5090) | 未使用 |
| LightVAE | lightx2v | 速さ(約半分・専用ノード) | 未使用(第26回) |
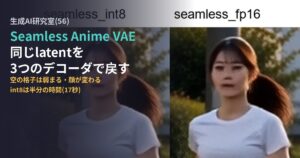
| Seamless Anime VAE | dully3865 | 絵柄(2D寄りの追加学習) | 実測済み: 公式34.3秒/int8 17.3秒/fp16 34.7秒(第56回) |
5. 当方の機材別・載ったもの早見
| 機材 | 載せた本体 | TE | 所要の目安 |
|---|---|---|---|
| M5 Mac 32GB | h3.c: BF16原本(SSD流し・常駐8.5GB) / ComfyUI: GGUF Q4_K_M・pruned Q4 | ClipProj 4B(GGUF時) | 0.6MP 5秒 8ステップ 26分(h3.c)。15秒 2時間19分 |
| RTX 5060 Ti 16GB×2・RAM 64GB | pruned int8_convrot(Ref2VA/FL2VA・21GB)+H3VMで2枚に分割 / FastH3 V2 pruned int8 | nvfp4_awq | 0.6MP 5秒 10ステップ 約8分(Ref2VA+Turbo 8step LoRA)。FastH3 0.6MP 15秒 8分21秒。P-H3-Image LoRA 4MP 1枚2分弱(RAM 43GiB) |
| RunPod RTX PRO 6000 96GB | bf16(66.3GB・VRAM 98.8%+RAM 132GB) / int8_convrot(VRAM 54.9GB) | bf16 | 0.6MP 32分・1.0MP 57分(bf16・25ステップ)。第49回 |
| RunPod A40 48GB | (8月の試行) | — | クラウドGPU入門で別途 |
読み方: 16GB 1枚で「載る」のはpruned int8(21GB)ではなく、CPUに退避しながら動くか、H3VMで2枚に分けるか、です。w6a8(16GB)は当方未検証。Macは量子化なしでもh3.cなら動く(遅い)。
6. Xでの評価(当方の引用台帳から)
当方がXで引用した投稿の反応(いいね・表示)を、モデル別に並べます。評価の物差しは「当方の引用への反応」で、モデルの良し悪しではありません。
| 題材 | 引用日 | いいね / 表示 | リンク先記事への流入 |
|---|---|---|---|
| P-H3-Image(公式) | 11/5 | 0 / 322 | — |
| P-H3-Image(16GB報告) | 11/6 | 4 / 407 | — |
| P-H3-Image(12編集報告) | 11/6 | 4 / 462 | — |
| Seamless Anime VAE | 11/4 | 190 / 8,414 | (26)へ29 |
| Sol-H3-VAE(ComfyUIマージ) | 10/31 | (週刊(2)で観測: 元投稿186いいね) | — |
| Viggle Remake | 11/7 | 投稿直後 | — |
Seamless VAEの引用が突出しているのは、「差し替えるだけで絵が変わる」が刺さったためで、モデルそのものの評価とは別です。
7. どれを落とすか(当方の読み)
- 16GB GPU×1・RAM 64GB: pruned int8_convrot(21GB)+nvfp4 TE。CPU退避で動く。H3VMがあれば2枚に。
- 16GB×2: 上と同じでH3VM。当方の常用。
- 24GB(4090): pruned int8が載る帯。w6a8なら余裕。当方未検証。
- Mac 32GB: h3.c(BF16原本・遅いが壊れない)。GGUFはスワップ地獄。
- 96GB: bf16原本。1.0MPが1時間。
次回は、LoRAの一覧(高速化・編集・動き・人物・補助)を同じ型で。
本記事の数値は、配布元の公表値(ファイルサイズ・対応)と当方の実測(早見表・各回)です。当方未使用のものは「未使用」と明記しています。
続き: (58) MiniMax H3のLoRA一覧——高速化・入れ替え・カメラ・人物・絵柄の6分類に、作者公表値・Xの反応・当方の実測を並べた
コメント