(73)で「本家の画像モデルが来た、int8/4bitは16GBに載る段」と書いてから24時間。Hugging Faceには公式とComfy-Orgのほかに20を超える軽量版が並び、Xには12GBから96GBまでの実測が出てきた。形式・サイズ・報告された数字をひとつの表に集める。当方の16GB×2の実測は、この表の空欄を埋める形で続報にする。
目次
先に結論
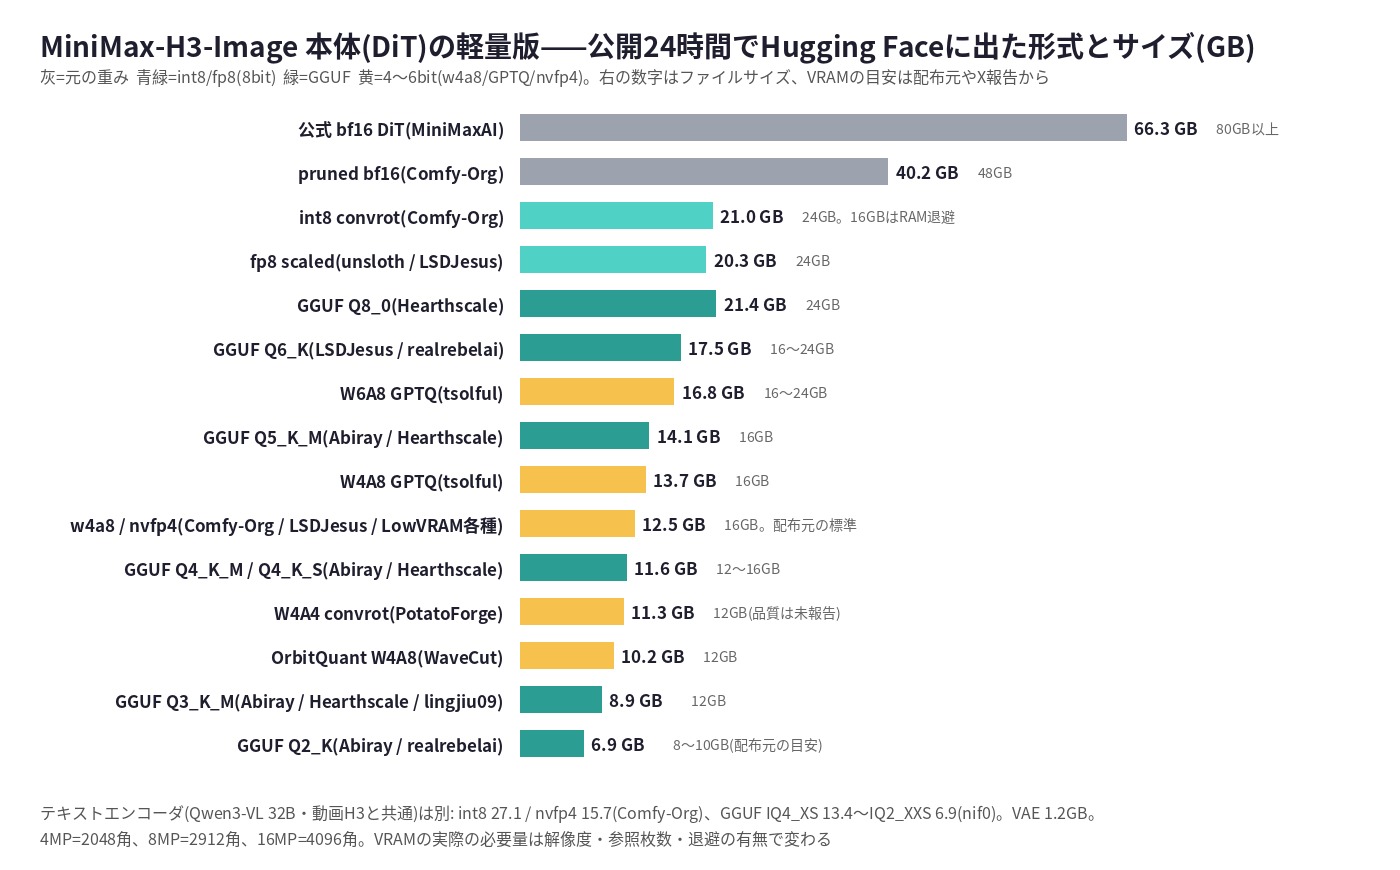
- 本体の段は4つ。 8bit(int8/fp8/GGUF Q8、20〜21GB)、6bit(GGUF Q6/W6A8、17GB)、4〜5bit(w4a8/nvfp4/GPTQ/GGUF Q4〜Q5、11.6〜14GB)、それ以下(W4A4/OrbitQuant/GGUF Q2〜Q3、7〜11GB)。配布元の標準はComfy-Orgのint8(21.0GB)とw4a8(12.5GB)。
- テキストエンコーダが本体と同じくらい重い。 Qwen3-VL 32Bを動画H3と共用。int8 27.1GB、nvfp4 15.7GB、GGUFなら13.4〜6.9GB。RTX 4090の報告では生成時間の8割がテキストエンコーダで、同じプロンプトの2回目は2.3秒。プロンプトを固定してseedを変えるのが速い。
- 12GBで16MPが出た。 RTX 4070 12GBで3072×5472(約16MP)が1枚1分という報告。16GB(RTX 5070 Ti、RTX 5080)でも動いたという報告が複数。16MPは本体が載るかよりRAM退避の設計で決まる。
- 速さの実測。 RTX 4090・int8: 4MP 11.5秒(ウォーム)、2回目2.3秒、初回23秒。RTX PRO 6000 96GB・int8: 4MP 9.3秒/9MP 10.4秒/16MP 19.7秒、ピーク48GiB。DGX Spark・int8: 16MP 88秒。
- 質の実測。 4モデル80枚の比較(RTX 4090)では、公式H3は人物・風景・看板の文字・配置で最良、アニメと手はMOSS/Qwenに劣る。拡張器は思考つきで+25秒。
- GGUFは「感度の高い層をfp32で残す」作り。 入力パッチ化、6ステップ用の出力ヘッド、AdaLNの基底は量子化せず、本体の線形層だけを落とす。配布元の目安はQ2が8〜10GB、Q3が12GB、Q4が12〜16GB、Q5が16〜24GB。
- 当方は16GB×2で、w4a8とint8の4MP/8MP/16MPを測る。 (73)の実測予定どおり。表の16GB行を自分の数字で埋める。
本体(DiT)の軽量版一覧
| 形式 | 配布 | サイズ | 備考 |
|---|---|---|---|
| bf16 DiT | MiniMaxAI(公式) | 66.3GB | 分割12ファイル。埋め込み・時刻・出力層はfp32 |
| pruned bf16 | Comfy-Org | 40.2GB | 単一ファイル。各量子化の元 |
| int8 convrot | Comfy-Org / unsloth | 21.0 / 20.3GB | 配布元の標準。comfy-kitchenのint8。CUDA 12.xではfallback(動くが遅い)という報告 |
| fp8 scaled | unsloth / LSDJesus | 20.3 / 21.0GB | Ada/Blackwell向け |
| GGUF Q8_0 | Hearthscale | 21.4GB | ComfyUI-GGUF |
| GGUF Q6_K | LSDJesus / realrebelai | 17.5 / 16.7GB | |
| W6A8 GPTQ | tsolful | 16.8GB | |
| GGUF Q5_K_M | Abiray / Hearthscale | 14.1 / 13.9GB | 配布元「bf16と見分けがつかない」 |
| W4A8 GPTQ | tsolful | 13.7GB | |
| w4a8 / nvfp4 | Comfy-Org / LSDJesus / LowVRAM各種 | 12.5GB | 配布元の4bit。同じファイルを束ねた「LowVRAM」リポジトリが複数 |
| GGUF Q4_K_M / Q4_K_S | Abiray / Hearthscale / LSDJesus(imatrix) | 11.4〜12.5GB | 配布元「16GBの標準」 |
| W4A4 convrot | PotatoForge | 11.3GB | 活性化も4bit。品質は未報告 |
| OrbitQuant W4A8 | WaveCut | 10.2GB | |
| GGUF Q3_K_M | Abiray / Hearthscale / lingjiu09 | 8.8〜8.9GB | |
| GGUF Q2_K | Abiray / realrebelai / LSDJesus(imatrix) | 6.9〜9.2GB | 配布元の目安8〜10GB |
| SDNQ uint4 | SD-Next | 約22GB(分割) | SD.Next用 |
| MLX 4bit / 8bit / bf16 | cguldogan / VisualInference | — | Apple Silicon用。別途MLX移植のGitHubあり |
| 2ステップ蒸留(PDMD) | akhaliq | 40.2GB+LoRA 2.0GB | 6→2ステップ。ComfyUI用LoRAあり |
いずれも公開から24時間以内。配布者の多くは動画H3のときと同じ顔ぶれで、作り方も動画H3の軽量版と同じ(Comfy-Orgの単一ファイルを元に変換)。
テキストエンコーダとその他
| 部品 | 形式 | サイズ |
|---|---|---|
| テキストエンコーダ(Qwen3-VL 32B・動画H3と共用) | int8 convrot(Comfy-Org) | 27.1GB |
| 同 | nvfp4 awq(Comfy-Org) | 15.7GB |
| 同 | GGUF(nif0: IQ4_XS / Q4_K_M / IQ3_XXS / Q2_K_XL / IQ2_XXS) | 13.4 / 14.9 / 9.8 / 9.6 / 6.9GB |
| VAE | fp16(Comfy-Org) | 1.2GB |
| 拡張器(H3-Image-PE) | NVFP4(公式) / w4a8 gptq(Comfy-Org) / GGUF(prithivMLmods) | 17.9 / 7.3 / — |
動画H3を持っていればテキストエンコーダは共用できる。持っていない人は本体と同じくらいの容量が追加になる。
Xの実測報告(11月11日、いずれも投稿者の環境)
| 報告 | GPU | 形式 | 結果 |
|---|---|---|---|
| @sep_is_heim | RTX 4070 12GB | (記載なし) | 約16MP(3072×5472)がt2iで1枚1分。「12GBでも全然生成できる」 |
| @CreaitiveLabs | RTX 4090 24GB・RAM 64GB | int8+TE int8 | 4MP 11.5秒(ウォーム)、同じプロンプトの2回目2.3秒、初回23秒。TEはVRAMに収まらずRAMから流す。4モデル80枚の比較で、人物・風景・看板文字・配置はH3が最良、アニメ・手はMOSS/Qwen |
| @AiXsatoshi | RTX PRO 6000 Blackwell 96GB | int8 | 4.2MP 9.3秒/46.3GiB、9.4MP 10.4秒/47.3GiB、16.8MP 19.7秒/48.1GiB。6ステップ・CFG 1・同一seed、ウォーム |
| @_Pranjal | DGX Spark | int8 | 16MP 1枚88秒 |
| @imaginaldomain | RTX 5070 Ti 16GB | (記載なし) | 動いた。「背景が強い、編集はP-H3で良さそう」 |
| @uzuki425 | (記載なし) | pruned+int8 weight-only の自作移植 | 1024²編集 10.0秒/33.6GB→7.4秒/21.1GB、1024² T2I 3.6秒/33.2GB→2.0秒/20.8GB |
| jo-nike(GitHub) | RTX 5080 16GB | 標準ComfyUIワークフロー | 16MPで600枚を生成し採点。形式と時間は未記載 |
| @pulpmatrix | — | — | 「ComfyUIの下限はint8 12GB+RAM約64GB」という見立て |
数字はそれぞれの環境・設定の値で、横に並べて優劣をつけるものではない。読み取れるのは3つ。①16MPは16GB以下でも出る(時間は分単位)。②24GB以上ならint8で4MPが10秒台、16MPが20秒。③時間の大半はテキストエンコーダで、プロンプト固定なら2回目以降は数秒。
選び方(配布元の目安と報告から)
| GPU | 本体 | TE | 見込み |
|---|---|---|---|
| 8〜10GB | GGUF Q2_K 6.9GB | GGUF IQ2 6.9GB | 配布元の目安では載る。4MPまで。品質は未報告 |
| 12GB | GGUF Q3〜Q4(8.9〜11.6GB)、W4A4 11.3GB | nvfp4 15.7GBを退避、またはGGUF Q2〜Q3 | 16MP 1分の報告あり(形式未記載)。RAM 64GBが前提 |
| 16GB | w4a8 12.5GB、GGUF Q4〜Q5(11.6〜14.1GB)。int8 21.0GBはRAM退避 | nvfp4 15.7GBを退避 | 5070 Ti・5080の動作報告。当方の実測はここ |
| 24GB | int8 21.0GB、GGUF Q8 21.4GB | int8 27.1GBをRAMから流す | 4090で4MP 11.5秒 |
| 48GB | pruned bf16 40.2GB | int8 | — |
| 96GB以上 | int8で16MPがピーク48GiB | int8 | bf16+TEも載る |
当方の実測予定
(73)で書いたとおり。キャラシート正面1枚を参照に、w4a8とint8で4MP→8MP→16MP、参照1→5→16枚、拡張器あり/なし。上の表の16GB行を自分の数字に置き換える。
続報: (77) H3-Imageは何に使われているか——公開48時間でXに出た実例7型
続報: (78) 公式H3-Imageを16GBで実測——w4a8もint8も16MPが出た
コメント