ASCII.jpの連載(新清士氏・11月9日)で「参照画像1枚で同じ人物を再現できる」と取り上げられたP-H3-Imageは、当方が(55)で16GB×2で動かし、(66)(67)の走る女性のキャラシートを作ったモデルでもある。何者で、なぜ画像なのに重く、どのGPUでどこまで使えるかを、配布元の一次情報と当方の実測で整理する。
先に結論
- 動画モデルH3の静止画版。 Pruna AI(ミュンヘン・パリ)がMiniMax H3を土台に、画像の生成と編集用に学習し直し、8ステップに蒸留したもの。動画・音声は作れない。
- 参照画像は最大8枚、8MPが本領、8ステップ・CFGなし。 1枚目が編集対象、2枚目以降は「Picture 2, 3…」として名前で呼べる。一行の指示を長い本番プロンプトに書き直す拡張器(Qwen3.5-9B)が同梱。
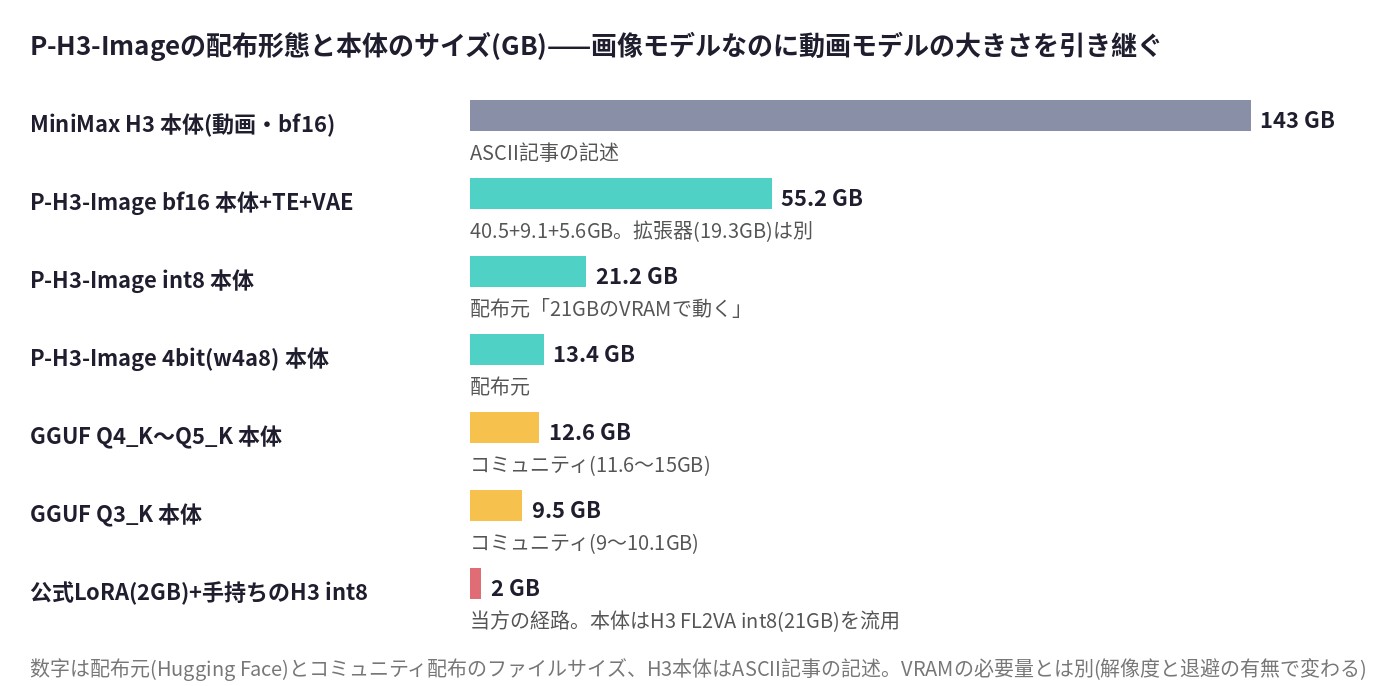
- 画像なのに重いのは、パラメータを減らしていないから。 本体は33B(H3と同じ)。bf16で本体+テキストエンコーダ+VAEが55GB、8MPのGPUメモリは拡張器込みで約101GB。重さは出力が動画か画像かでなく、パラメータ数で決まる。
- 一般のGPUで使う道は量子化かLoRA。 配布元のint8(21.2GB)・4bit(13.4GB)、コミュニティのGGUF(Q3 9GB〜Q8 22GB)、公式LoRA(2GB)+手持ちのH3本体。当方は16GB×2でLoRA経路、4MP・8ステップが1枚94〜141秒、GPU 13.4GiB+RAM 43GiB。
- 「LoRA」は2つある。 ASCIIが「効きにくい」と報告したのは自前で追加学習するLoRA。当方が使ったのは配布元が配っている、H3をP-H3-Imageに変える公式LoRA。別物。
何者か
| 項目 | 配布元の記述 |
|---|---|
| 開発 | Pruna AI。既存モデルの圧縮・最適化が専門 |
| 土台 | MiniMaxAI/MiniMax-H3のファインチューン(base_model_relation: finetune) |
| 用途 | 文章から画像、画像の編集(入力1〜8枚)。動画・音声は不可 |
| 生成 | 8ステップ、CFGなし、ネガティブなし |
| 解像度 | 文章から画像は8MP(既定2912×2912)。編集は4または8MP。2〜4MPは顔・手・細部が崩れやすい、と配布元自身が明記 |
| 部品 | 33.1Bのトランスフォーマー、4Bのテキストエンコーダ(Qwen3-VL-4B系)、VAE、拡張器(Qwen3.5-9B系) |
| 得意 | 写真風(肌の質感)、映画・雑誌風、アニメのTVフレーム風、短い引用文字入りのグラフィック |
| 公開 | 11月3日(ComfyUI向けリポジトリ。DL 62万超) |
配布元の説明では、動画モデルは「コマ間の一貫性を保つために角度・照明・動きを学んでいる」ので、画像モデルの出発点に向いている。H3でそのまま静止画を作るとぼやける問題を、生成の手順を画像用に見直して解いた、という作り方。
なぜ画像なのに重いか
| モデル | パラメータ | 本体ファイル(bf16) |
|---|---|---|
| SDXL | 2.6B | 約6.5GB |
| FLUX.1 | 12B | 約24GB |
| P-H3-Image | 33.1B | 40.5GB(本体のみ)。TE 9.1GB、VAE 5.6GB、拡張器19.3GBは別 |
蒸留は「少ないステップで同じ絵を出す」ための学習で、パラメータの数は減らさない。だから動画モデルの大きさがそのまま残る。推奨解像度が8MPで、途中の計算データも1024角の約8倍になる。配布元の性能表では、B200(メモリ大)でbf16・8MPの文章から画像が約9秒、GPUメモリ83GB。拡張器を同時に載せると101GB。
動画との違いは時間方向の計算量で、画像は1コマ分で済むので時間は短い。ただし重みを載せるメモリは同じ。
頑張って買えるGPUで、どこまで使えるか
配布元・コミュニティ・ASCII記事・当方の実測から、「載るかどうかの目安」を並べる。動作保証ではなく、解像度と退避(CPUオフロード)の有無で変わる。
| GPU | 載る形 | 根拠 | 当方の見立て |
|---|---|---|---|
| 8GB | GGUF Q3(9GB)でも本体が載らない | ファイルサイズ | 退避前提で、RAMが十分でも時間がかかる。未検証 |
| 12GB | GGUF Q3〜Q4(9〜12.6GB) | コミュニティ配布 | TE・VAEは退避。2〜4MPが現実的。未検証 |
| 16GB | 公式LoRA 2GB+手持ちのH3 int8本体(21GB)、またはGGUF Q4〜Q5(11.6〜15GB)、4bit w4a8(13.4GB) | 当方実測(LoRA経路) | 4MP・8ステップが1枚94〜141秒。GPU 13.4GiB+RAM 43GiB。RAM 64GBがないと厳しい |
| 24GB | int8本体(21.2GB)、4bit | 配布元「int8と4bitは21GBのVRAMで動く」 | 退避を減らせる帯。8MPは未検証 |
| 32GB | int8に余裕 | — | 8MPの途中データも載りやすい |
| 48GB(ASCII記事のA6000) | int8〜bf16の一部 | ASCII記事: 参照1枚で2MP 20秒、4MP 30秒、8MP 1分、16MP 1分40秒 | 業務用。速さはRTX 3090級 |
| 80〜100GB | bf16そのまま | 配布元: オフロードで80GB、拡張器込みで101GB | データセンター級 |
当方の16GB×2は、2枚に分ける仕組み(H3VM)がLoRAの読み込みと相性がなく、主にGPU1枚+RAM退避で動いている。「16GB×2だから32GB」ではない。
当方の実測((55)の要点)
- 入力: キャラシートの正面全身1枚(顔はぼかし)。参照は1枚だけ
- 出力: 向き(背面・左右)、表情(微笑・大笑い)、ポーズ(ジャンプ・走る・振り返り)、衣装(サンタ)、背景(雪の街・ツリー)の12枚。すべて4MP・8ステップで完走
- 服・髪・靴の大枠は12枚で保った。手足の増殖なし
- 入力の顔がぼけていると、ぼけたまま出るか、別の顔が描かれる。本人の顔を保つには顔の参照を足す(最大8枚)
- 衣装の細部は毎回変わる。揃えるなら出力を次の参照に渡す
- 2〜4MPでは顔と手に粗が出やすい、という配布元の記述どおり、4MPの結果には解像度の影響が混じる
この12枚から作ったキャラシートが、(66)(67)で走る女性の6〜7カットの容姿を一貫させている。
プロンプトの書き方(配布元の4原則)
配布元は「P-H3-Imageはプロンプトに敏感で、短い指示は弱く、煽り語は絵を悪くする」と書いている。だから拡張器が既定で動く。手で書くときの4点。
| 原則 | 内容 |
|---|---|
| 何の画像かを最初に言う | 「ベテランの街角写真家の写真」「日本のテレビアニメの1コマ」「2色のリソグラフ印刷」のように、画像の実体を1文目に |
| 一場面を書く | 視点、主役の一瞬、脇役を少し、光源と方向 |
| 文字は一字ずつ引用符で | 短く、位置を言い、「他に文字なし」で締める。文字がいらないなら看板に触れない |
| 煽り語を入れない | stunning・epic・cinematic・8k・masterpieceはツヤツヤで彩度過多の絵に寄る |
編集は「Edit Picture 1。変更後の見た目。Keep 残すものをそのまま」の型。対象を名指しし、動作でなく結果を書き、残すもの(顔・ポーズ・背景・光)を列挙する。列挙しないと全体を描き直しがち。
ASCII記事は、参照画像だけでなく人物と服装の特徴をプロンプトにも書く方が反映されやすい、と報告している。当方の(55)でも、衣装は毎回同じ説明を書いて揃えた。
ASCII記事が報告している点(当方は未検証)
- OpenPoseやDepthのポーズ参照が、専用のControlNetなしで効く(H3が学習済みのため)。SAM 3D BodyからOpenPoseへの変換はコミュニティのカスタムノード
- 自前で追加学習するLoRA(19枚・3,000ステップ)がほぼ効かなかった。筆者は蒸留モデルのためではと推測。原因は不明
- 16MPまで出力可能で、ディテールは精細
このうち「LoRAが効かない」は、配布元が配っている公式LoRA(H3本体に当ててP-H3-Imageにする2GBのファイル)とは別の話。公式LoRAは当方の16GB×2で動いている。
ライセンス
MiniMax H3 Community License。別契約がなければEU・英国・韓国・米国は対象外で、製品には「Powered by MiniMax H3」の表示が要る。テキストエンコーダのQwen3-VL-4B部分と拡張器はApache 2.0。
今週の動き
- ASCII.jp(11月9日)が「参照画像1枚で同じ人物を再現」として紹介
- スタジオ真榊がQwenImageとの比較記事を準備中と告知
- WaveSpeedがAPIで提供開始(4K、参照複数、LoRA最大3、8ステップ)
- コミュニティからGGUF各種(Q3〜Q8)、2ステップ蒸留版、ComfyUI向けの長尺・人物入れ替えワークフロー
コメント