11月上旬からXで、東京駅・大阪城・みなとみらい・函館といった実在の場所を空撮風に回る短い動画が、同じ作り方で次々に出ている。鍵は3つ。国土交通省の3D都市モデル「PLATEAU」、Blender、そしてMetaの個人向けAIエージェント「Muse」。何がどうつながっているのか、どこが新しいのかを整理し、当方が(54)で使っているBlender→MiniMax H3の経路と並べる。
目次
先に結論
- Museは「クラウド上に自分専用のPCを持つ」型のAIエージェント。 利用者ごとにVM(中身はUbuntu)が割り当てられ、アプリを閉じても作業が続く。そこにBlenderをインストールさせ、スクリプトで動かせる。
- PLATEAUは国交省が無償公開している実在都市の3Dモデル。 建物の形と高さが実測に基づくので、「東京駅」「大阪城」の形を先に押さえられる。
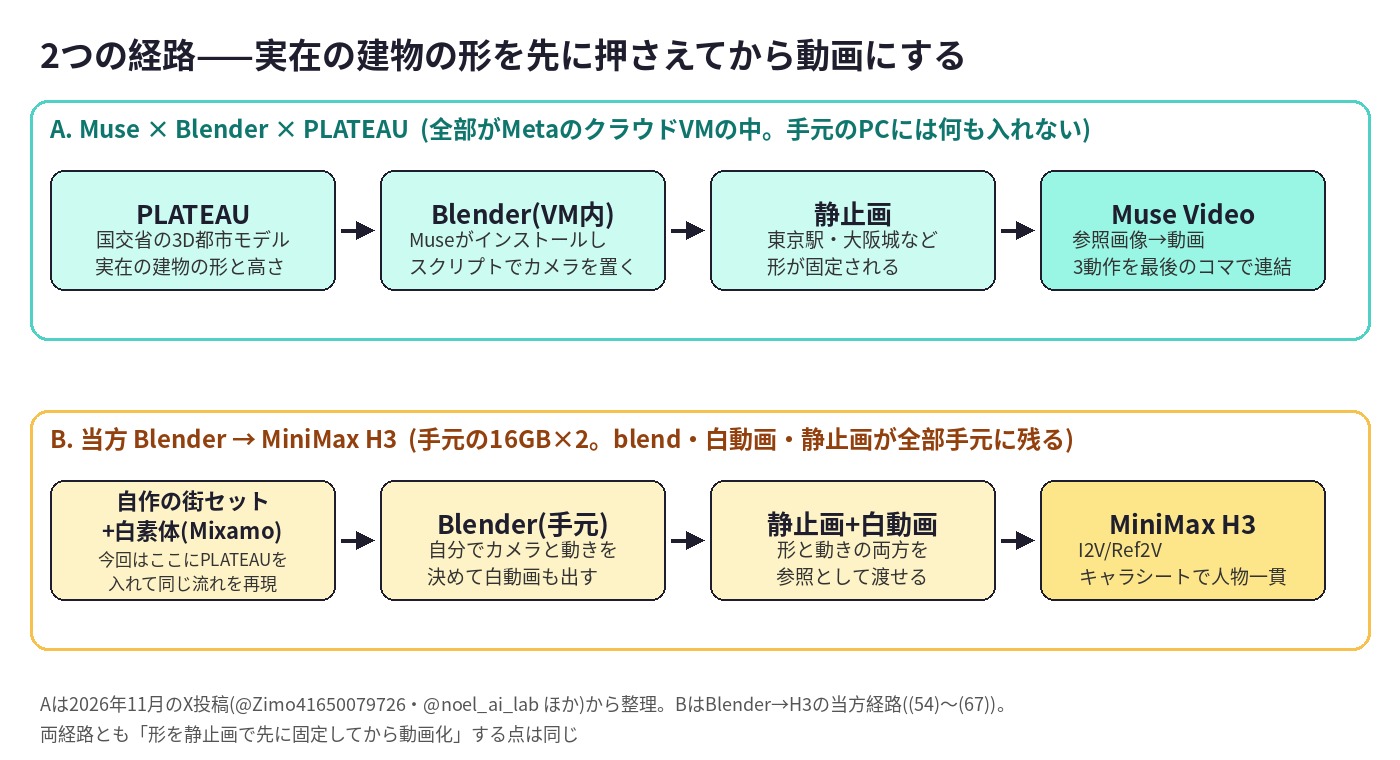
- 流れは「PLATEAU→Blenderで静止画→Muse Videoで動画」。 実在の形を静止画で固定してから動画にするので、動画生成だけで作るより形が崩れにくい。
- 広がった理由は「手元のPCに何も入れなくてよい」こと。 Blenderもデータも全部Museの側。利用者は頼むだけ。
- 弱点も報告されている。 制御のしづらさ、日本語の弱さ、姫路城を頼んだら大阪城になる、東京駅の時計が増える、など。
- 当方の経路との違いは計算場所と動画モデル。 当方は手元の16GB×2でBlender→MiniMax H3。人物の一貫性(キャラシート)は当方側にある。同じ流れを手元で再現する(続報)。
3つの部品
| 部品 | 何か | この流れでの役割 |
|---|---|---|
| PLATEAU | 国土交通省が整備・公開する3D都市モデル。CityGML形式を中心に、都市によってはOBJ/FBX等の変換済みデータも配布。無償、商用利用可、出典表示 | 実在の建物の形と高さの「正解」を供給 |
| Blender | 無償の3DCGソフト。Pythonスクリプトで操作できる | PLATEAUを読み込み、好きな位置・高さ・時間帯にカメラを置いて静止画を描く |
| Muse | Metaが2026年9月に発表した個人向けAIエージェント。利用者ごとのクラウドVMで動き、Web/iOS/Android/Macアプリから使える。無償枠あり(トークン制) | VMにBlenderを入れ、PLATEAUを取得し、静止画を作り、同社の動画生成(Muse Video)で動画にする。全工程を会話で頼む |
Museの中身がUbuntuのVMであることは、複数の利用者がシェルから確認して記事にしている。Blenderを「入れる」のは、このVMにapt等でインストールさせているということで、利用者のPCには何も入らない。
伝播の順
| 日付 | 投稿 | 内容 |
|---|---|---|
| 11月4日 | @Zimo41650079726 | MuseにBlenderとPLATEAUを入れて静止画を作り、Muse Videoに参照させて東京駅の動画。「だんだん時計が増えていく」失敗も明記 |
| 11月6日 | @noel_ai_lab | 大阪城を30秒で周回+空撮。18.7万表示・1,146いいね(11/9時点)。作り方をリプ欄に掲示 |
| 11月7日 | @tetumemo | 上記の作り方を図解メモ。4.5万表示 |
| 11月8〜9日 | 多数 | 函館、みなとみらい、瑞鳳殿、教室、中国語圏への波及。「姫路城を頼んだら大阪城になった」報告も |
作り方(@noel_ai_lab の掲示を @tetumemo がまとめたもの)
- Museが、PLATEAUの大阪市データからBlenderで大阪城の静止画を作る
- 「周りを回る」「門をくぐって上がる」「空から見渡す」の3つのカメラ動作で、動画を3本作る
- 前の動画の最後のコマだけを次の動画の参照に渡して、3本を1本につなぐ
3本を最後のコマでつなぐのは、当方が(59)〜(67)の走る女性で6〜7カットをつないでいるのと同じ考え方で、場所が変わってもそのまま使える。
試した人が書いている弱点
- 「とりあえず制御しづらい、使いづらい。日本語に弱い、演技下手。すごいのは、BlenderをMuseのVMの中でスクリプトで動かして、好きな位置・高さ・時間帯にカメラを置いて描けるから、空間の再現が合っていること」(@k_kaori_dododo)
- 姫路城を頼んだら、動画生成の段階で大阪城になった(@MokuMokuMove)。PLATEAUに該当都市のデータがない、または取得に失敗したときに、動画モデルが知っている別の城で埋めてしまう
- 函館のPLATEAUが見つからず、Museが別の手段で代替した(@Ayu_AI_0912)
- 東京駅の時計が増えていく(@Zimo41650079726)。静止画で形を押さえても、動画化で細部は増殖する
つまり「形は合うが、細部と動きは動画モデル任せ」で、当方がH3で見ている傾向(手足・看板・時計の増殖、カメラの反転)と同じところで止まる。
当方のBlender→H3経路との違い
| 項目 | Muse×Blender×PLATEAU | 当方(54)〜(67) Blender→MiniMax H3 |
|---|---|---|
| 計算場所 | Metaのクラウド(利用者ごとのVM) | 手元のRTX 5060 Ti 16GB×2 |
| 3Dソフト | Blender(VM内・Museが操作) | Blender(手元・自分で操作) |
| 3Dデータ | PLATEAU(実在都市) | 自作の街セット、Mixamoの白素体 |
| 静止画→動画 | Muse Video(参照画像) | MiniMax H3(I2V/Ref2V。白動画で動きも渡せる) |
| 人物の一貫性 | 報告なし(建物が主) | P-H3-Imageのキャラシート1枚で6〜7カット一貫 |
| 1本あたりの時間 | 投稿からは不明 | 5〜12秒の1カットが450〜1,010秒 |
| 費用 | 無償枠(トークン制。10億〜300億トークン配布との投稿あり) | 電気代のみ。機材は購入済み |
| 手元に残るもの | 動画(VM内のblendは取り出し可) | blend、白動画、静止画、動画のすべて |
| 弱点 | 制御しづらい、日本語に弱い、別の建物に化ける | 1本が長い、VRAM16GBの範囲で解像度と長さが決まる |
当方の経路に足りないのは「実在の建物」で、Muse経路に足りないのは「人物の一貫性」と「動きの指定(白動画)」。PLATEAUは誰でも取れるので、当方の手元でも「PLATEAU→Blender静止画→H3」は組める。次回、東京駅または大阪城で同じ3動作(周回・接近・俯瞰)を16GB×2で作り、所要時間と形の保持を実測する。
コメント