AIに仕事を手伝わせている方なら、一度はこの壁に当たっているはずです。昨日あれだけ細かく詰めた話を、今日のAIは覚えていない。同じ前提を毎朝説明し直し、同じ注意を毎回繰り返す。会話が終わるたびに、相棒の記憶がゼロに戻る——AIの記憶はセッション単位で消える。これは現行のAIツールほぼ共通の仕様です。
1体のAIと短い作業をしているうちは、我慢できる不便で済みます。しかし当方の環境では、これが致命傷になりかねません。というのも、役割の違うAIを計6体並走させているからです。
6体のAIと、記憶の分断
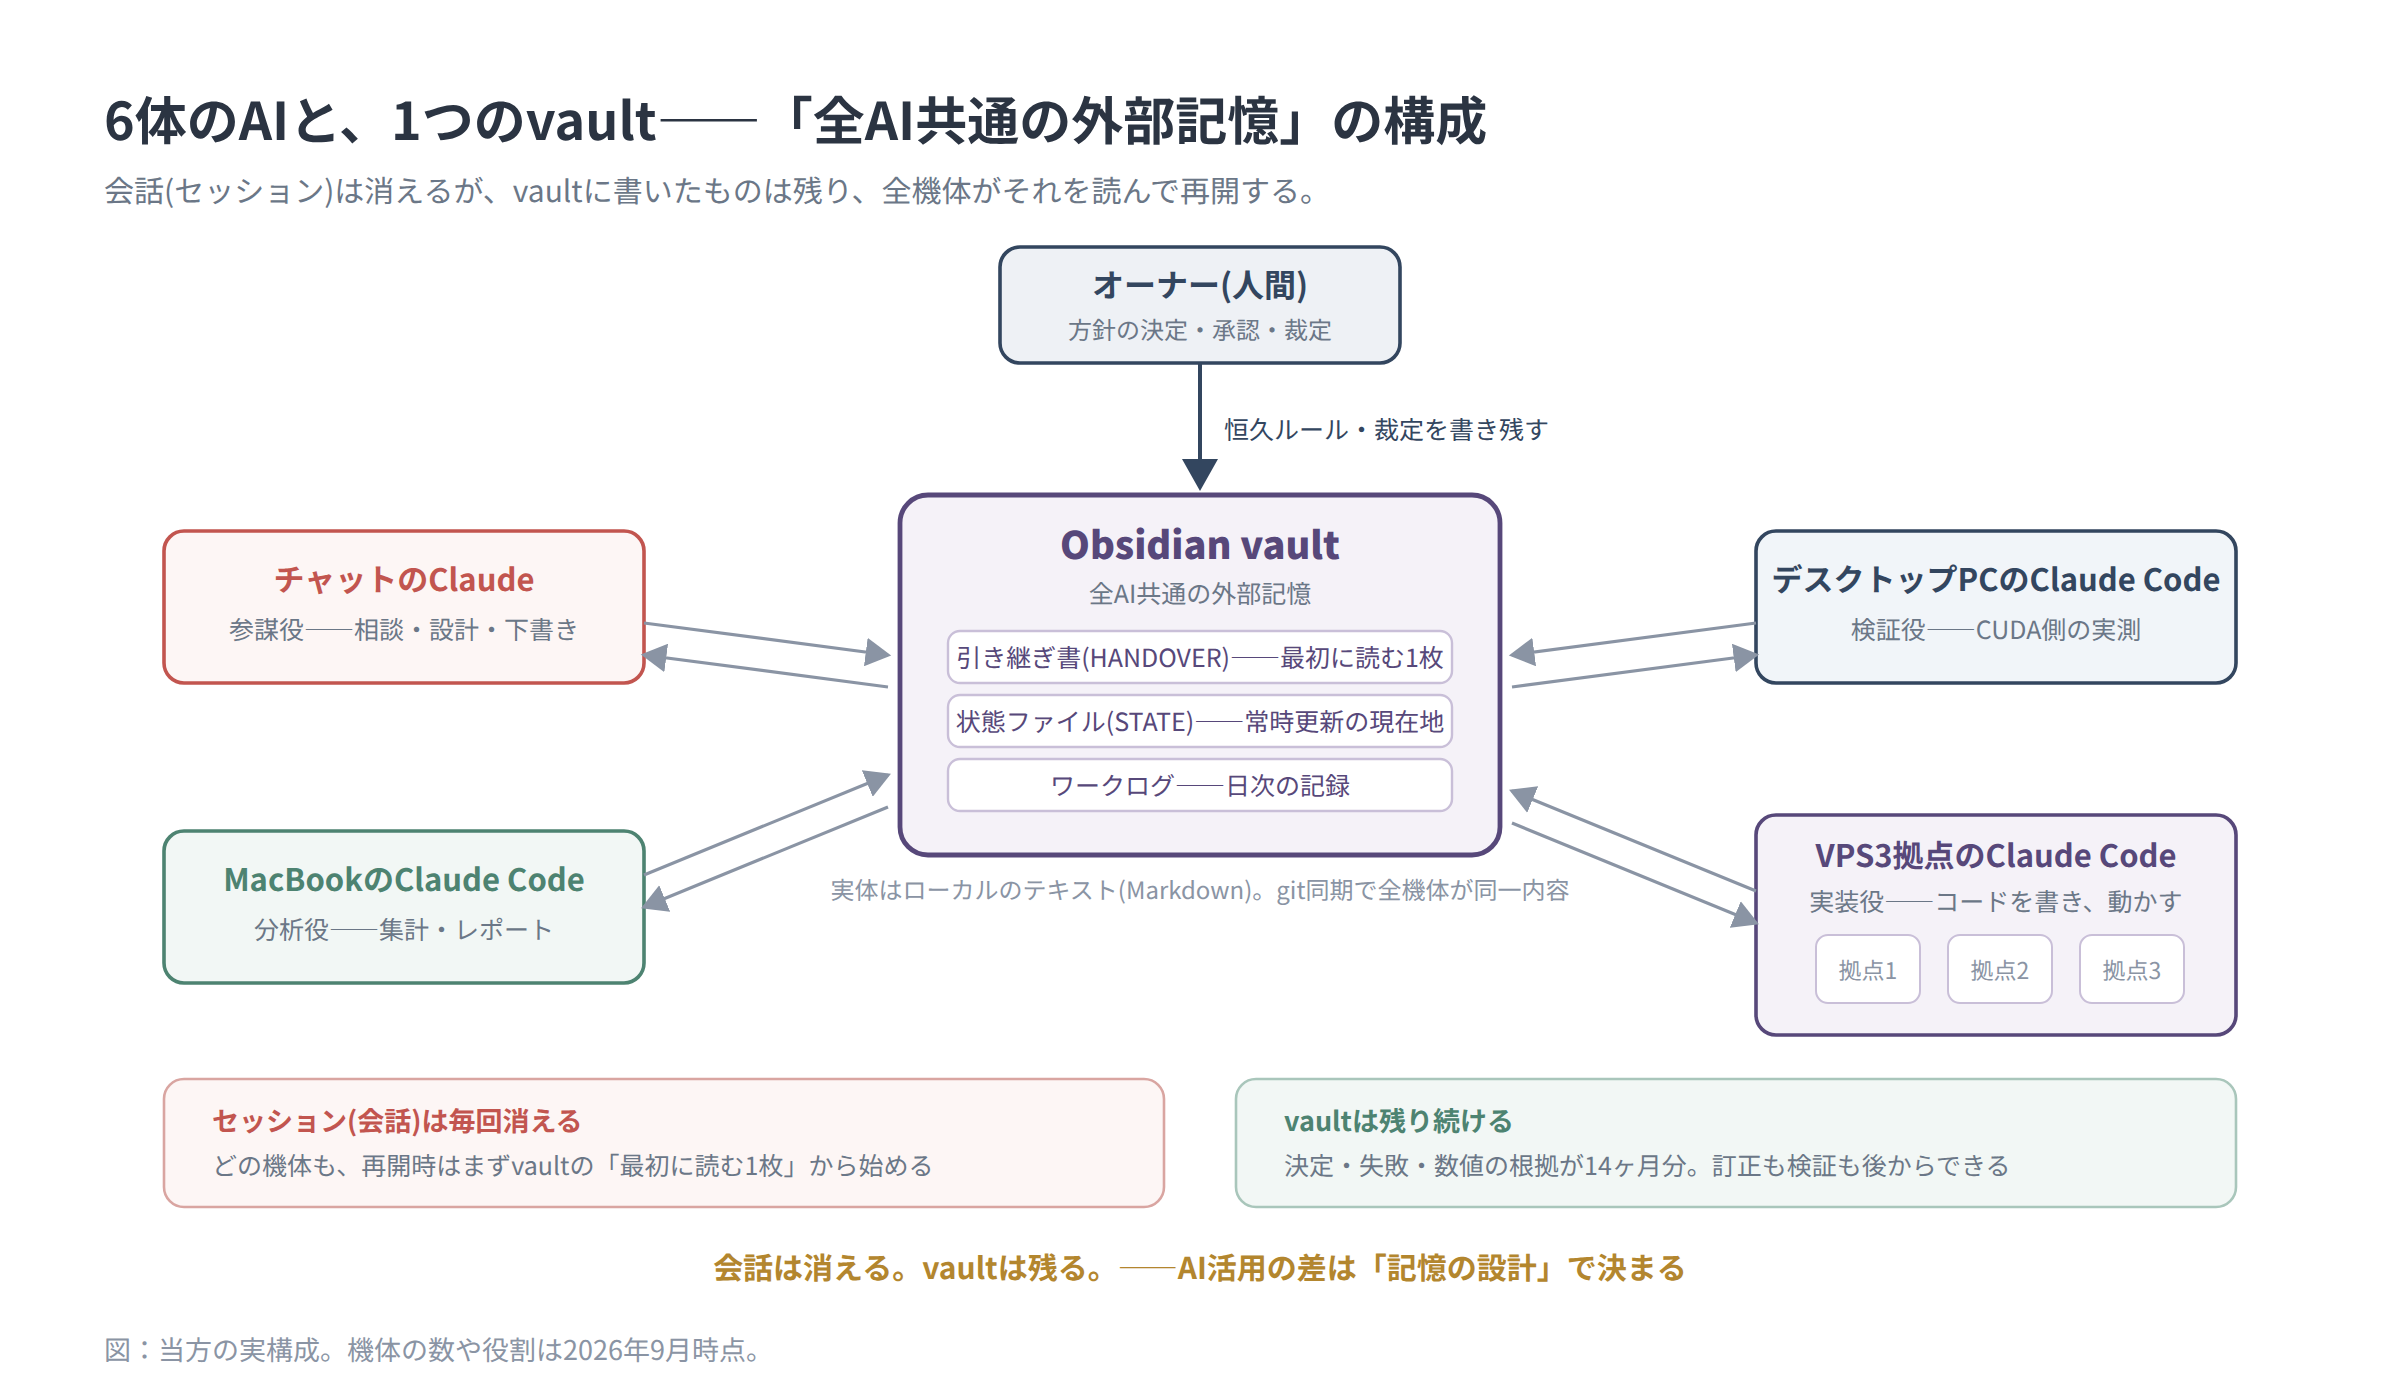
当方の作業体制はこうなっています。チャットのClaudeが参謀役——方針の相談、検証の設計、この連載の下書きもここから出てきます。MacBook上のClaude Codeが分析役——手元のデータを読んで集計し、生成AI検証のレポートを書きます。デスクトップPC(RTX 5060 Ti機)上のClaude Codeが検証役——この連載でMacと比較してきたCUDA側の実測を担当します。そしてVPS3拠点のClaude Codeが実装役——Botのコードを書き、実際に動かします。
6体はそれぞれ別のセッションで動いていて、互いの会話は見えません。参謀役が決めた方針を実装役は知らない。実装役が踏んだ地雷を、翌週の参謀役はまた踏みに行く。放っておくと、組織なのに議事録がない会社のようなことが起きます。実際、初期にはそれで痛い目を見ました——このサイトの過去記事(AIが止まらなかった日)に書いた「始末書事件」も、元をたどれば取り決めが記録として共有されていなかったことが一因です。
解決策: vaultを「全AI共通の外部記憶」にする
当方が採った解決策は単純です。Obsidianのvault(ノート置き場)を1つ用意し、すべてのAIにそこを読み書きさせる。
- 会話は消えるが、vaultに書いたものは残る
- vaultはgitで同期し、MacBook・デスクトップPC・VPS3拠点の間で同じ内容を共有する
- 新しいセッションを始めるAIは、まずvaultの決められたファイルを読む——そこに前任者の残した記憶がある
Obsidianを選んだ理由も実務的です。中身がただのテキストファイル(Markdown)なので、人間はObsidianの画面で読み書きし、AIはファイルとして直接読み書きできる。同じ1枚のノートが、人間用の画面とAI用のテキストを兼ねます。ファイルの実体はすべて手元のローカルにあり、機体間の同期はgitだけ。知識ベースをどこかのクラウドサービスに預けているわけではないので、何をどこまで書くかを自分で完全に管理できます。特別な連携ツールは使っていません。
14ヶ月回して固まった「3つの型」
仕組みだけなら誰でも思いつきます。差が出るのは何を書くかの型で、これは14ヶ月の運用で淘汰されて残ったものです。
型1: 引き継ぎ書(HANDOVER)——次のAIが最初に読む1枚。セッションの終わりに、そのAIが「次の自分」に宛てて書きます。決まったこと、やり残し、地雷の位置。ポイントは冒頭に「30秒で現在地」を置くことです。AIは長文を読めますが、何百枚もあるノートのどれが最新かは教えないと分かりません。「まずこれを読め」の1枚を常に決めておく。当方のvaultでは、生成AIの検証だけでこの5週間に28本の引き継ぎ書が書かれています。
型2: 状態ファイル(STATE)——日付で分けない、常時更新の現在地。引き継ぎ書が「日々の申し送り」なら、こちらは今の状態だけを書いた1枚です。実験の最新設定、動いている構成、直近の結論。状態が変わったらファイルを書き換える。「経緯」と「現在地」を別のファイルに分けるのがコツで、混ぜると、AIは古い経緯を最新の指示と読み違えます。
型3: ワークログ——日次の作業記録。その日に何をして何が分かったかを、日付付きで淡々と残します。後から「あの結論はいつ、何を根拠に出したか」を掘り返すのはほぼこれです。
この3つに加えて、運用上の恒久ルールは要約せず全文で保存します。要約は必ず何かを落とすからです。「〜は必ずオーナーの承認を経る」という類の取り決めは、一字一句そのまま残して、すべてのAIに毎回読ませる。
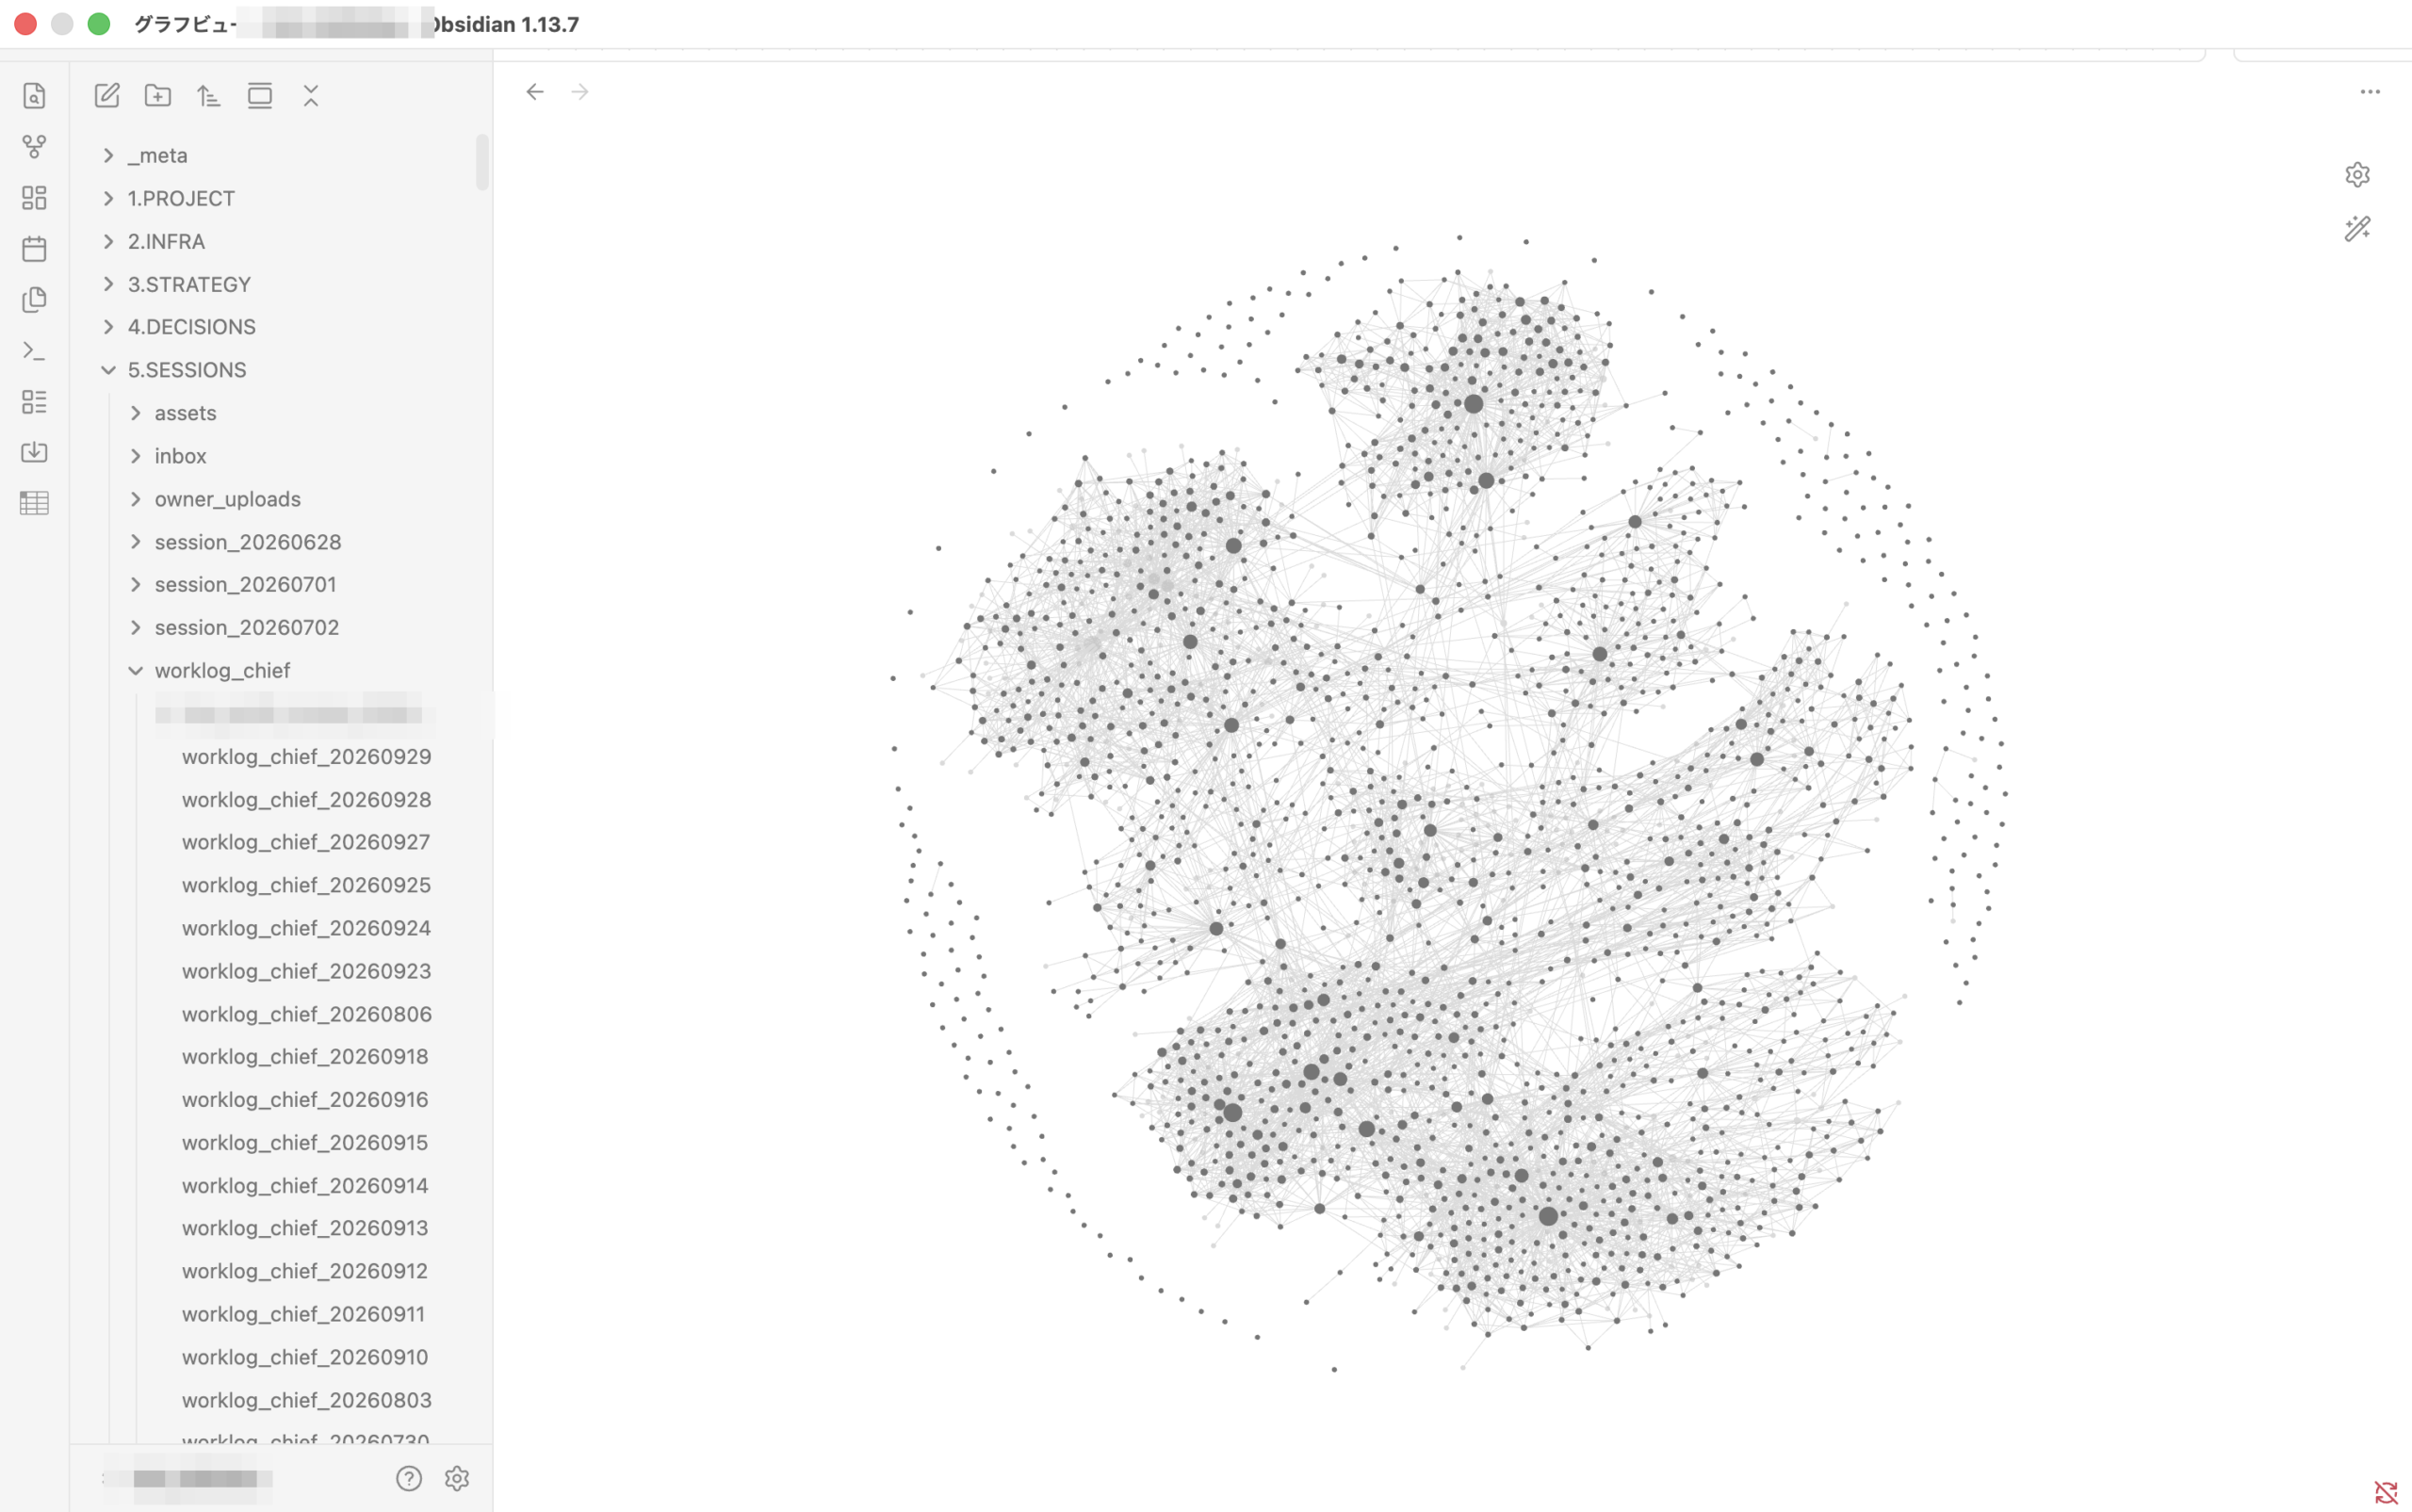
ノート同士は[[リンク]]で相互参照させます。14ヶ月続けた結果が、この網です。
この体制が実際に回しているもの
絵に描いた餅ではない証拠に、この体制が今まさに何を回しているかを書きます。Solana Botの開発と運用検証。M5 Macでの生成AI検証(この連載の生成AI実験室シリーズ)。そしてこのブログ——約1ヶ月で11本の記事を、品質を保ったまま出せているのは、記事の決定事項・公開手順・「出す情報/伏せる情報」の線引きがすべてvaultに引き継がれているからです。
じつはこの記事自体がその実例です。この下書きは、チャットのClaudeがvaultの引き継ぎ書を読んで書いています。前回までの記事で何を書いたか、どんな表現ルールで書くか、何を伏せるか——当方は毎回説明していません。vaultが覚えているからです。
もうひとつ、記憶の設計が効いた具体例を挙げます。先日の15秒動画の記事で、当方は過去記事の結論を2つ訂正しました。あの訂正ができたのは、当時の測定条件・数値・判断の根拠がすべてvaultに残っていて、どこまでが事実でどこからが早計な解釈だったかを、後から切り分けられたからです。記録がなければ、訂正ではなく上書きになっていたはずです。
断っておくと、これも「魔法」ではない
例によって、うまくいかない点も正直に書きます。
第一に、書く手間はゼロにならない。引き継ぎ書はAIに書かせますが、内容の点検は人間の仕事です。AIは自分に都合よく要約することがあるので、重要な取り決めほど全文保存を徹底する必要があります。
第二に、vaultは放っておくと散らかる。当方のvaultにも、勢いで書かれた「無題のファイル」が転がっています。それでも致命傷にならないのは、「まずこれを読め」の1枚(引き継ぎ書と状態ファイル)さえ守られていれば、他が多少散らかっても迷子にならないからです。整理の完璧さより、入口の1枚の規律のほうがずっと重要でした。
第三に、これはAIの記憶機能の代替ではなく、上位互換を狙うものでもない。各AIサービスにも記憶機能はありますが、サービスをまたいで共有されず、中身を人間が直接編集できるとも限りません。「複数のAIに同じ記憶を持たせ、その記憶を人間が管理する」が要件なら、現状こちらの方式に分があります——要件がそこまでなければ、標準の記憶機能で足ります。
まとめ
要点は3つです。第一に、AIはセッションが終わると忘れる。複数のAIを使うなら、記憶の分断は運用の最大の敵になる。第二に、Obsidianのvaultを全AI共通の外部記憶にすると、この問題は仕組みで解決できる。型は3つ——次のAIが最初に読む引き継ぎ書、日付で分けない状態ファイル、日次のワークログ。恒久ルールは要約せず全文で。第三に、AI活用の差は、モデルの賢さよりも記憶の設計で決まる。賢いAIに毎回ゼロから説明する人と、普通のAIに14ヶ月分の記憶を渡す人では、後者が勝つ場面が思いのほか多い。
引き継ぎ書のテンプレートや運用チェックリストの現物は、需要がありそうなら別の形でまとめようと思います。次回はまた生成AI実験室に戻る予定です。
本記事の内容は2026年9月時点の当方環境での実運用に基づきます。Obsidian・Claudeは各社の製品であり、本記事は個人の利用例です。


コメント