この連載はここまでM5 Macの話ばかりでしたが、当方の工房にはもう1台、Windowsのデスクトップ機がいます。今回はそちらの話——GPUをRTX 2080 Ti(11GB)からRTX 5060 Ti(16GB)に換装したら何が起きたか、の実測記録です。
先に今回の要点を言うと、「速くなった」は半分でしかありません。面白かったのはもう半分、GPUを1枚替えただけで、それまでの検証結論が3つ無効になったことのほうです。
換装の結果:同一条件で約2.9倍
換装したのはGPUだけです。マザーボード・CPU・メモリ・ストレージ・OS・ComfyUI・torchのバージョンまで、すべて同一であることを換装後に実測で確認しています(ドライバのバージョンも、計測時点では換装前と同一でした)。ただし正確を期すと、同じバージョンのドライバでも中身は世代ごとの最適化経路を持っており、新しいGPUを挿せばBlackwell(RTX 50シリーズの世代名)向けの実行経路が自動的に使われます。NVIDIAアプリの自動更新で最新ドライバが当たる一般的な環境なら、なおさらです。つまりこの前後の差は、正しくは「GPU1枚+それを活かすドライバの実行経路」の差です。
結果、換装前に基準値を取ってあった生成と完全同条件の比較で約2.88倍速。世代が2つ跳んだ(Turing→Blackwell)ことによる素の性能差に加え、VRAMが11GB→16GBに増えたことで、モデルの載せ替え(後述)の余裕が変わりました。
そして本題の「覆った結論」です。旧GPUで取った検証結果のうち、3つがこの換装で無効化されました。たとえば「この量子化形式は使えない」——旧世代のGPUが対応していなかっただけで、新世代では最速の選択肢になりました。逆に、旧GPUで最適だった設定が新GPUでは足を引っ張るケースもある。
教訓はシンプルで、実測の結論には賞味期限があり、機材が変わったら測り直しだということです。「以前ダメだったから」を機材更新後も引きずると、新しい機材の性能を眠らせることになります。当方のvault(検証記録)では、旧GPUの記録を消さずに「旧機での実測」として残し、現行の結論と分離して管理しています。
同じモデルを動かす、二つの哲学
このデスクトップ機とM5 Macは、同じ動画生成モデル(MiniMax-H3)を動かしています。ところが換装後に両者の構成を並べて驚いたのは、やっていることが正反対だという点でした。
CUDA機(RTX 5060 Ti)の哲学は「圧縮して速く」。61.7GBあるモデル原本は16GBのVRAMには載りません。だから量子化(数値の精度を落としてファイルを圧縮する技術)で本体を22GB、テキストエンコーダを16GB相当まで縮め、さらに足りない分は使う順にVRAMへ入れ替えながら回す。加えて蒸留版(少ないステップ数で済むよう学習し直したモデル)や疎アテンションといった、最新世代のGPUでしか動かない高速化技術をフルに使います。縮めて、詰め込んで、速く走る。
Mac(M5・32GB)の哲学は「縮めずに載せる」。前回書いたSSDストリーミングがそれで、61.7GBの原精度のまま、SSDから流しながら計算する。速さでは敵いませんが、量子化も蒸留もしていない素の計算です。
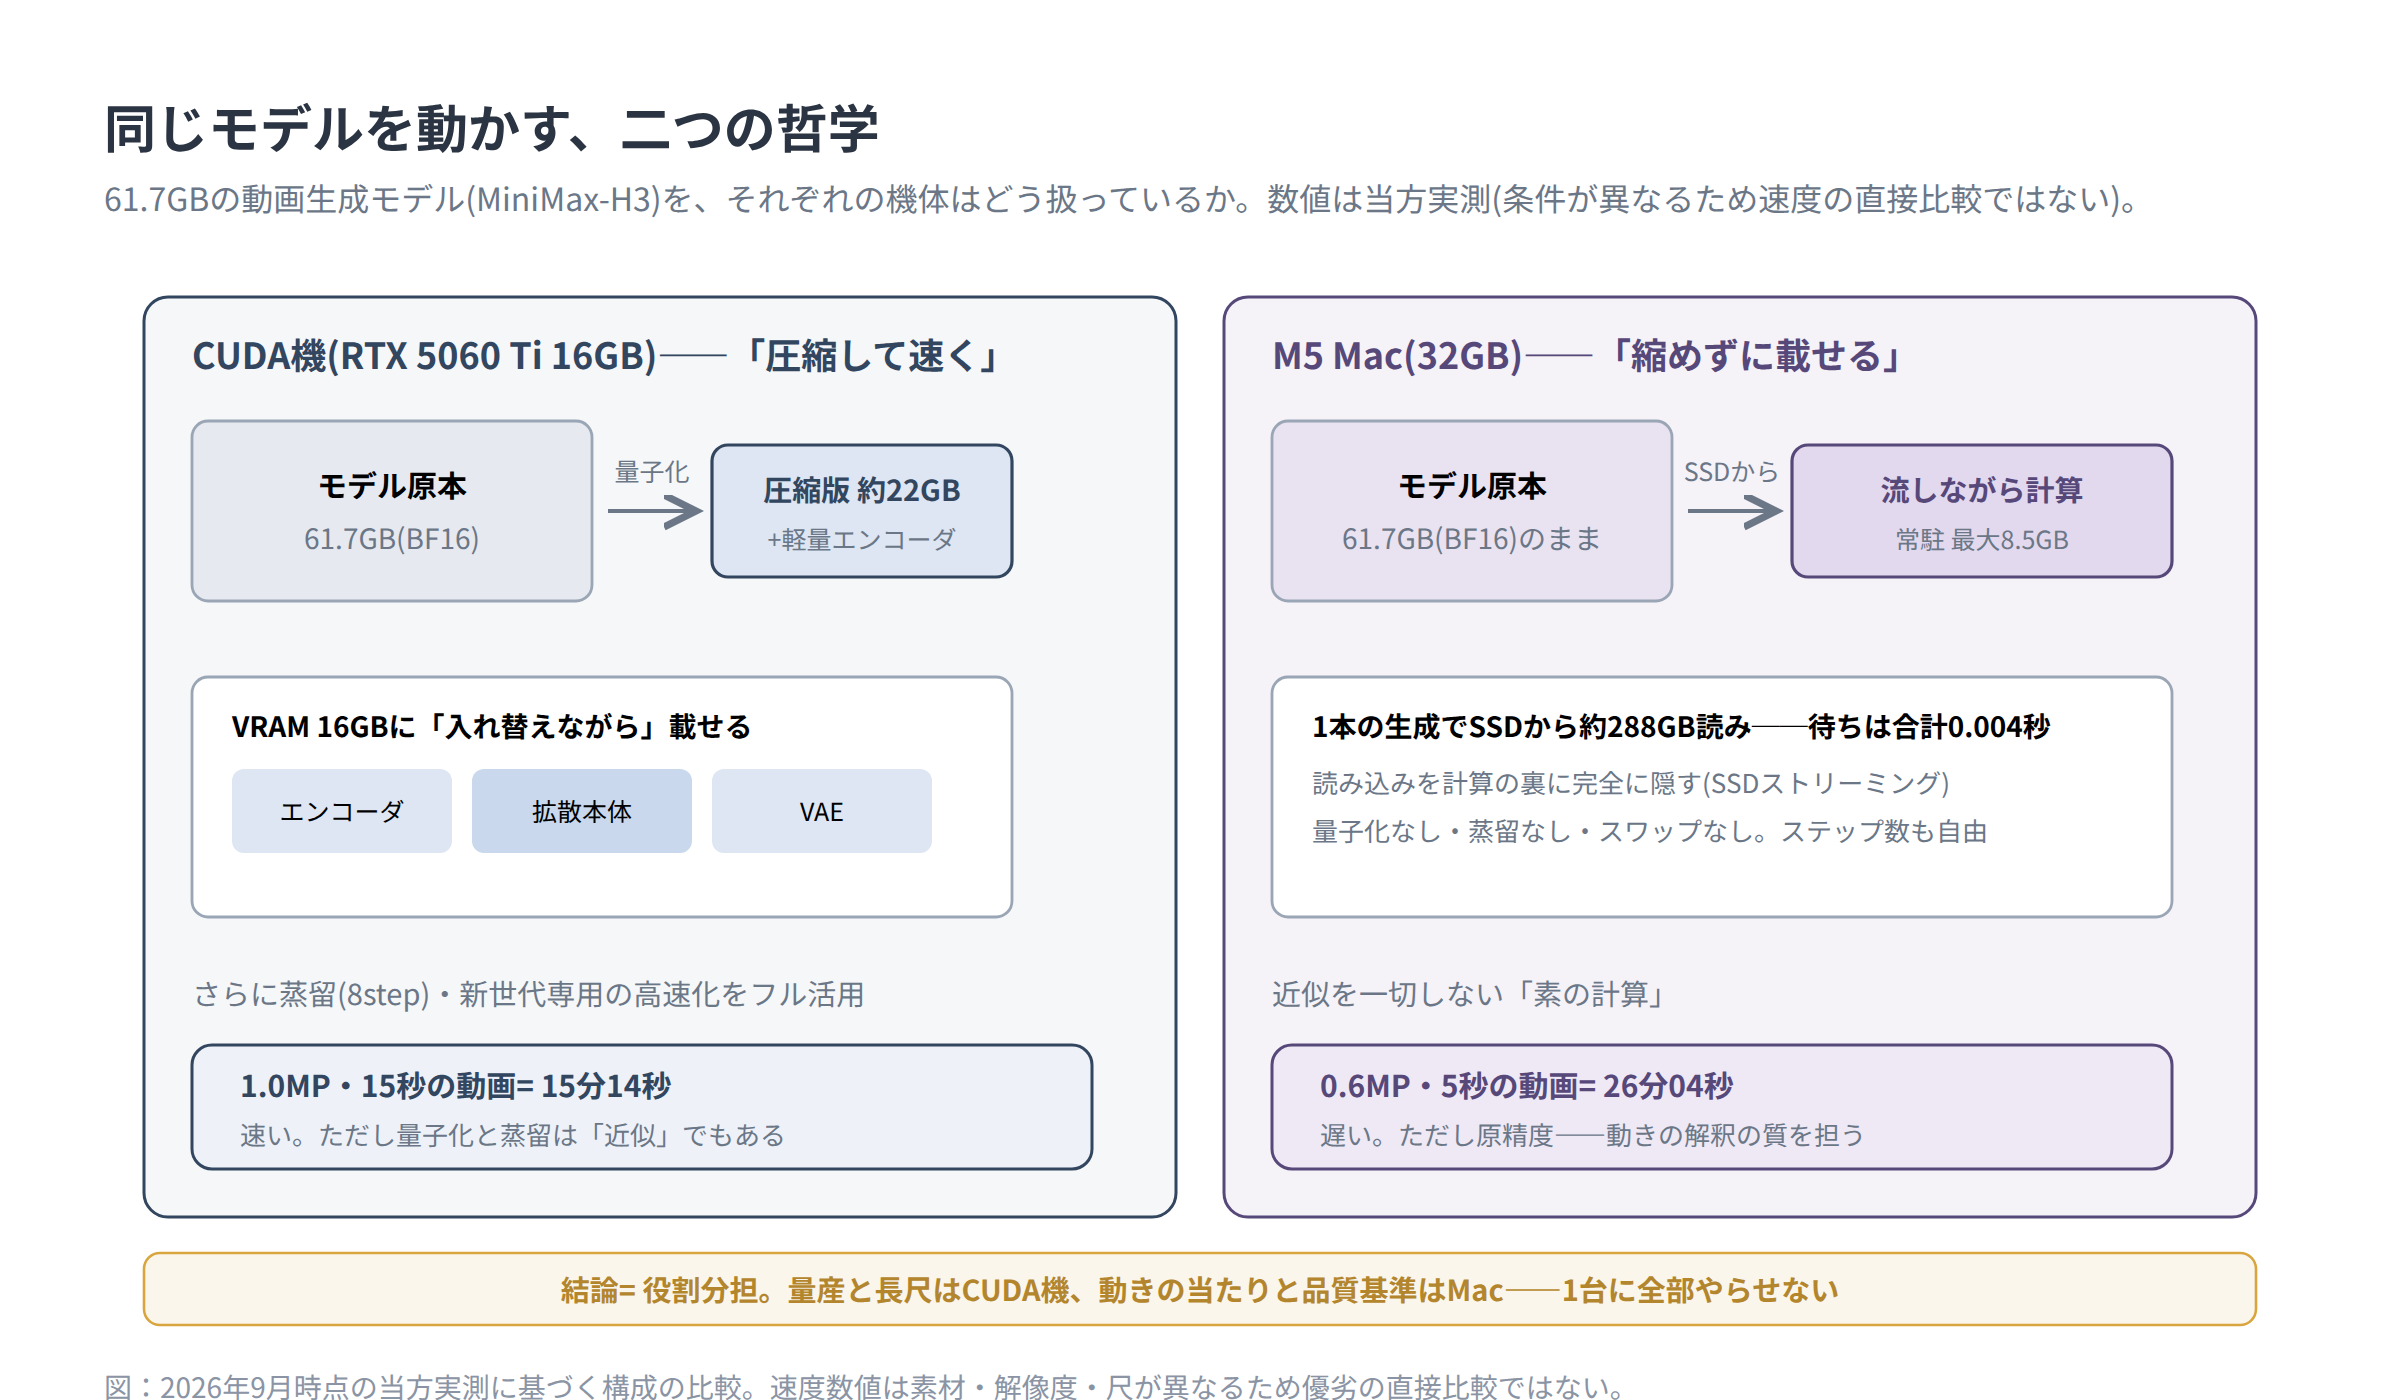
実測を並べるとこうなります(条件が違うため直接比較ではない点にご注意ください——尺が3倍違います)。
- デスクトップ(量子化+蒸留8step): 1.0MP・15秒の動画が15分14秒。0.6MPなら8分21秒
- Mac(原精度・8step): 0.6MP・5秒で26分04秒
1ステップあたりの計算速度は、CUDA機が明確に上です。15秒の動画を実用的な時間で焼けるのは、現状デスクトップ機だけです。
ついでに、換装後の計測で分かった実務的な発見をひとつ。生成時間は解像度より尺(秒数)のほうが高くつくことが実測で出ました(時間の伸び方の指数で、尺1.35に対し解像度1.15)。「長くする」は「大きくする」より贅沢な注文なのです。
ただし、速さには代金がある
では全部CUDA機でいいかというと、そうならないのが今回の学びの核心です。
量子化と蒸留は、どちらも近似です。そして近似には、実測とコミュニティ報告の両方で、絵が変わる事例が出ています。当方の環境でも、蒸留の少ないステップ数で回すとしゃがむ動作で足の動きが破綻する帯があり、ステップを増やすと単調に改善することを確認しました。コミュニティでは、最適化版でプロンプトの被写体が入れ替わるという報告もあります(オープンソース実装のIssueとして記録されています)。
一方でMacは、遅い代わりに近似を一切していません。実際に両方の出力を見比べての当方の体感は、動きの解釈——「この指示ならこう動くはず」の忠実さ——はMacのほうが上質、というものです。ただし正直に書くと、これは同一プロンプト・同一素材での厳密な機体間比較をまだしていない体感であり、定量できていません。この検証は宿題として残します。
ここから出た当方の運用は役割分担です。速さが要る量産と長尺はCUDA機、動きの当たりを丁寧に取りたい場面と品質の基準作りはMac。前回の「前段と後段を分ける」と同じで、1台に全部やらせないのが結論でした。
今回の機材
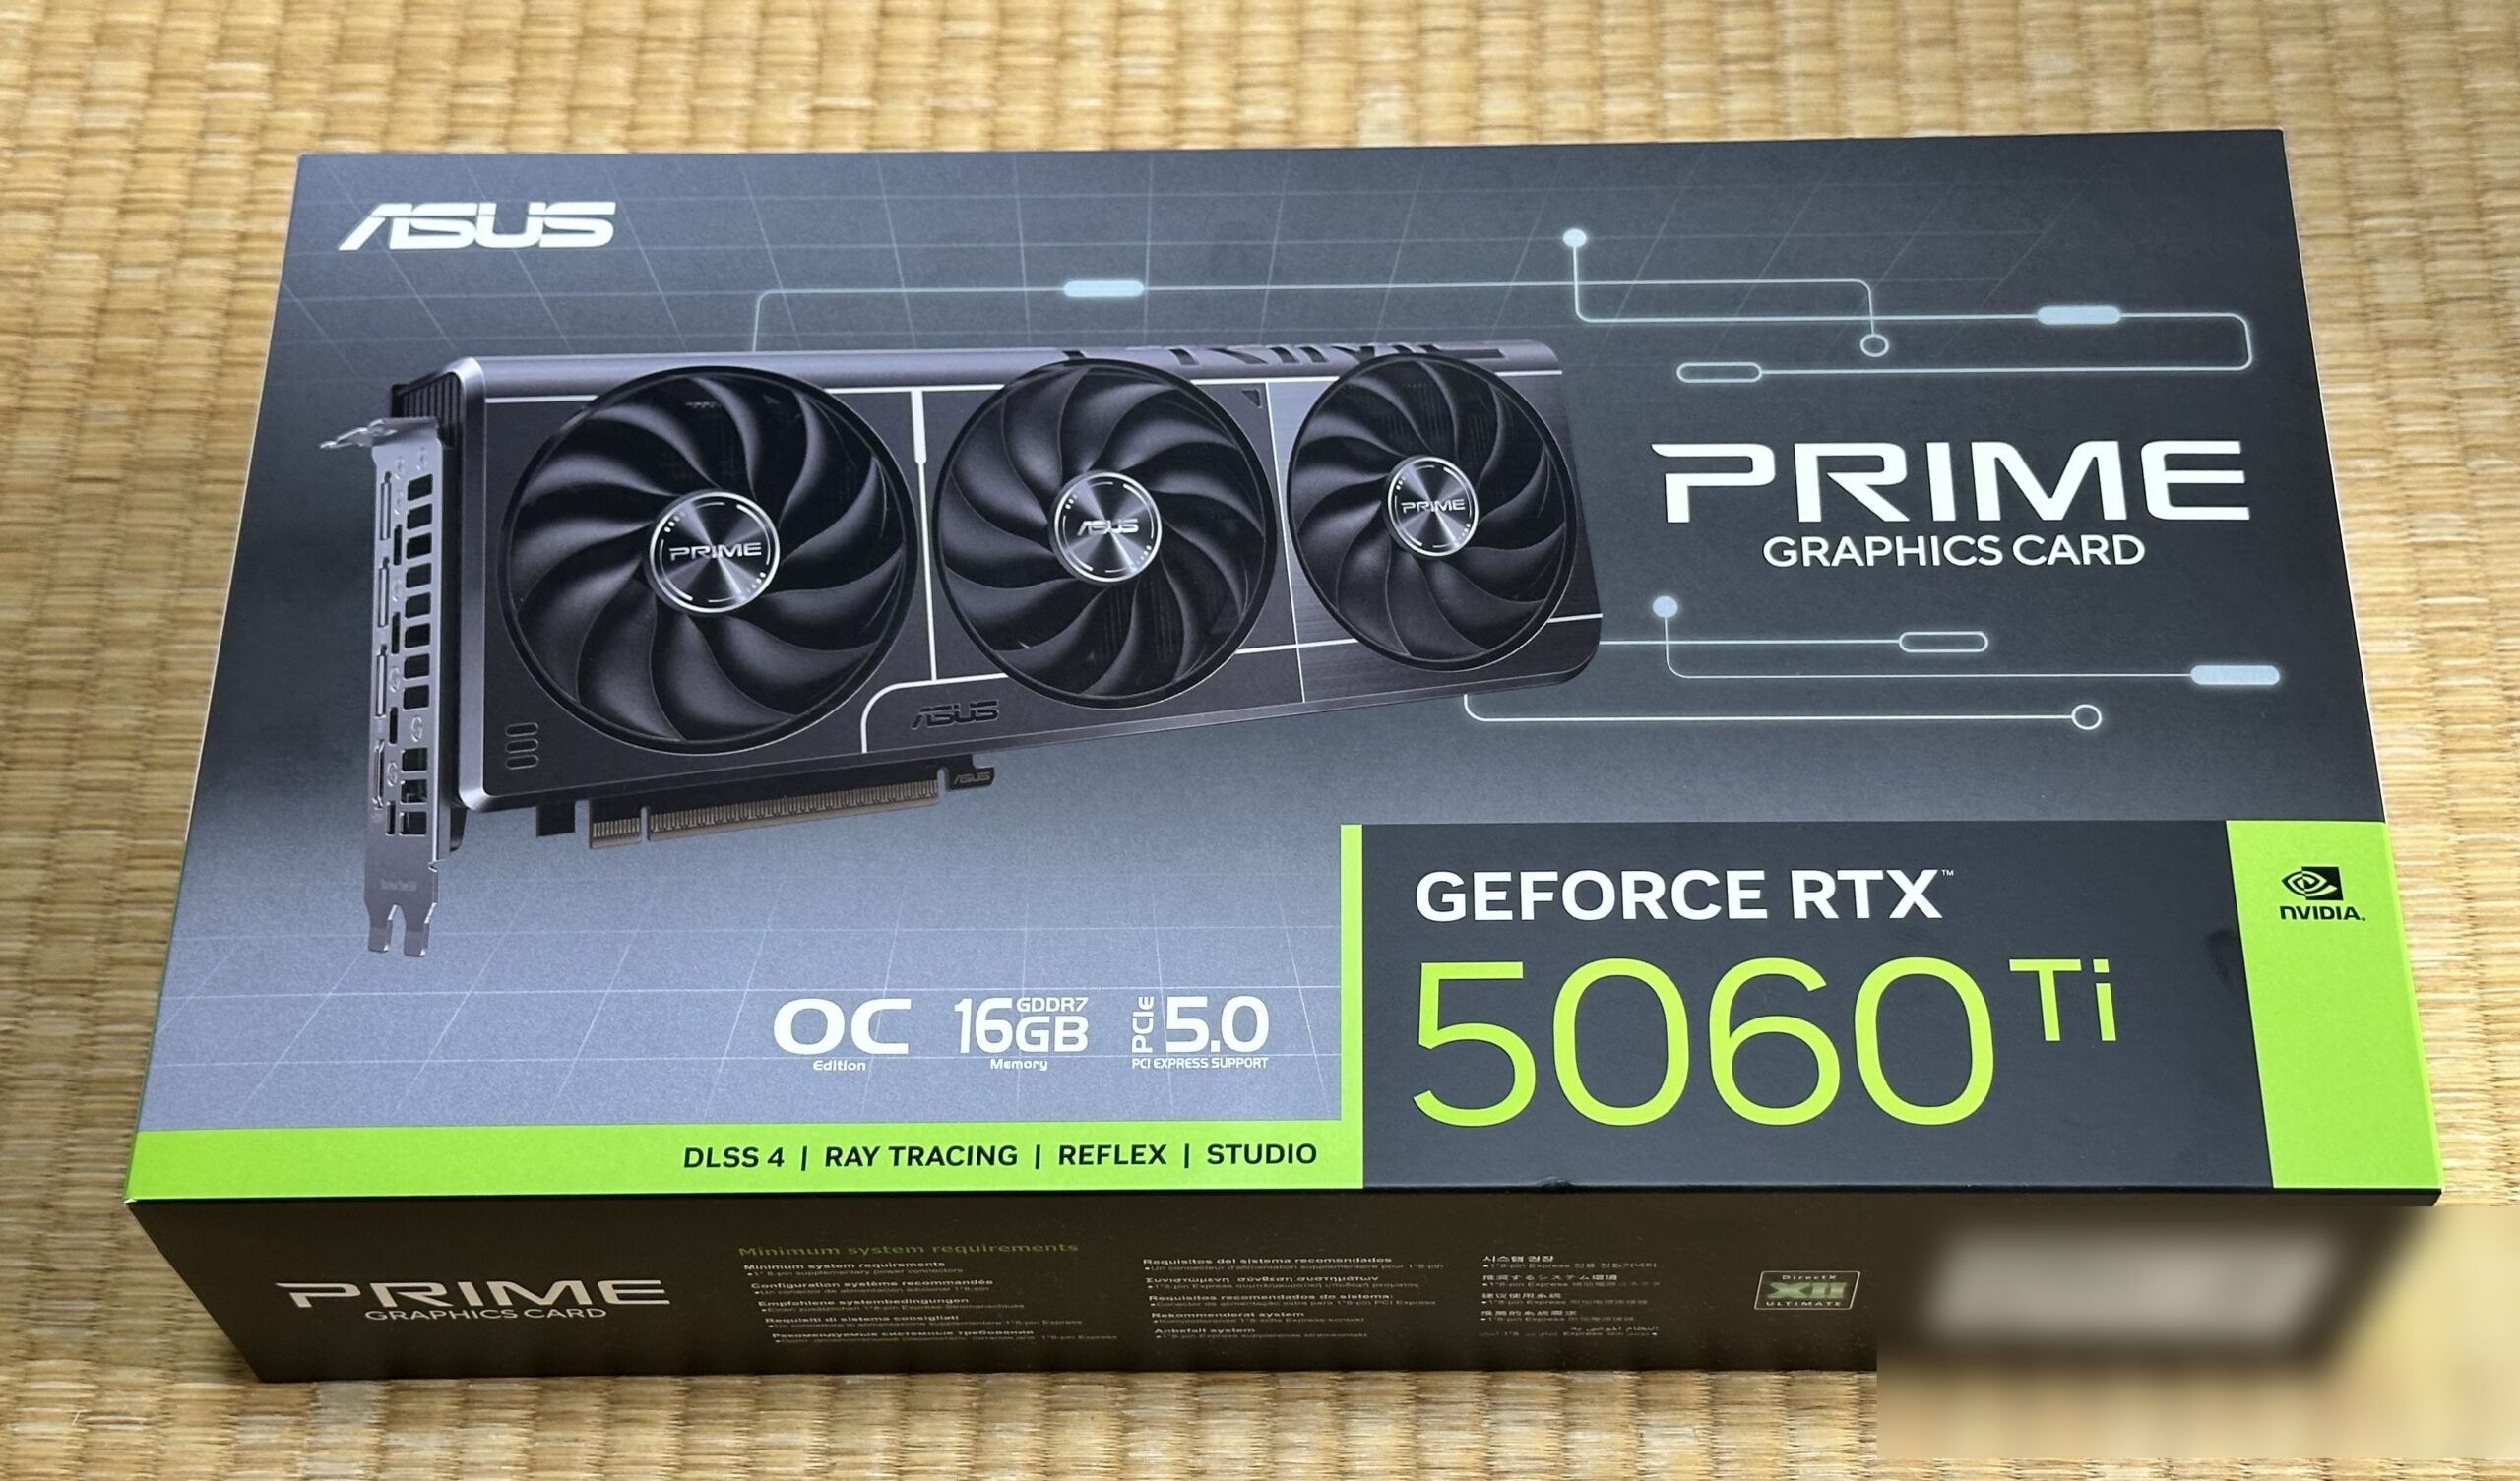
換装したGPUは以下です。約3年ぶりのGPU更新でしたが、動画生成AIという用途に限れば、ミドルクラスでも世代の新しさ(対応する量子化形式・VRAM 16GB)がそのまま実効性能に直結する、というのが換装しての実感です。
※上記は商品リンク(Amazonアソシエイト)です。価格・在庫は変動します。
まとめ
要点は3つです。第一に、実測の結論は機材とセットで賞味期限を持つ。GPUを替えたら、過去の「ダメだった」も測り直す。第二に、同じモデルでも動かし方には哲学がある——圧縮して速く走るCUDAと、縮めずに載せるMac。速度が要るならCUDA、近似を避けたいならMac。第三に、速さには近似という代金がある。何を犠牲にして速くなっているのかを知った上で、用途で使い分ける。
連載の本線もこの体制で進んでいます。彼女を動かす作業は、2台の工房で続行中です。
本記事の数値は2026年9月時点の当方環境での実測に基づきます。ソフトウェア・モデルの仕様は変わり得るため、実施の際は最新の一次情報をご確認ください。本記事にはアフィリエイトリンクが含まれます(詳細は免責事項)。
コメント