(73)(78)でMiniMax H3 Imageを16GBのGeForceで動かしたが、「NVIDIA以外で動くか」は答えがなかった。11月13日に、Tencentの推論フレームワークncnnの作者(nihui)が、H3 Imageをncnnに移植してVulkanで動かす単体の実行ファイルを公開した。PythonもPyTorchもCUDAも要らない。文書を読んだ。当方は動かしていない。
目次
先に要点
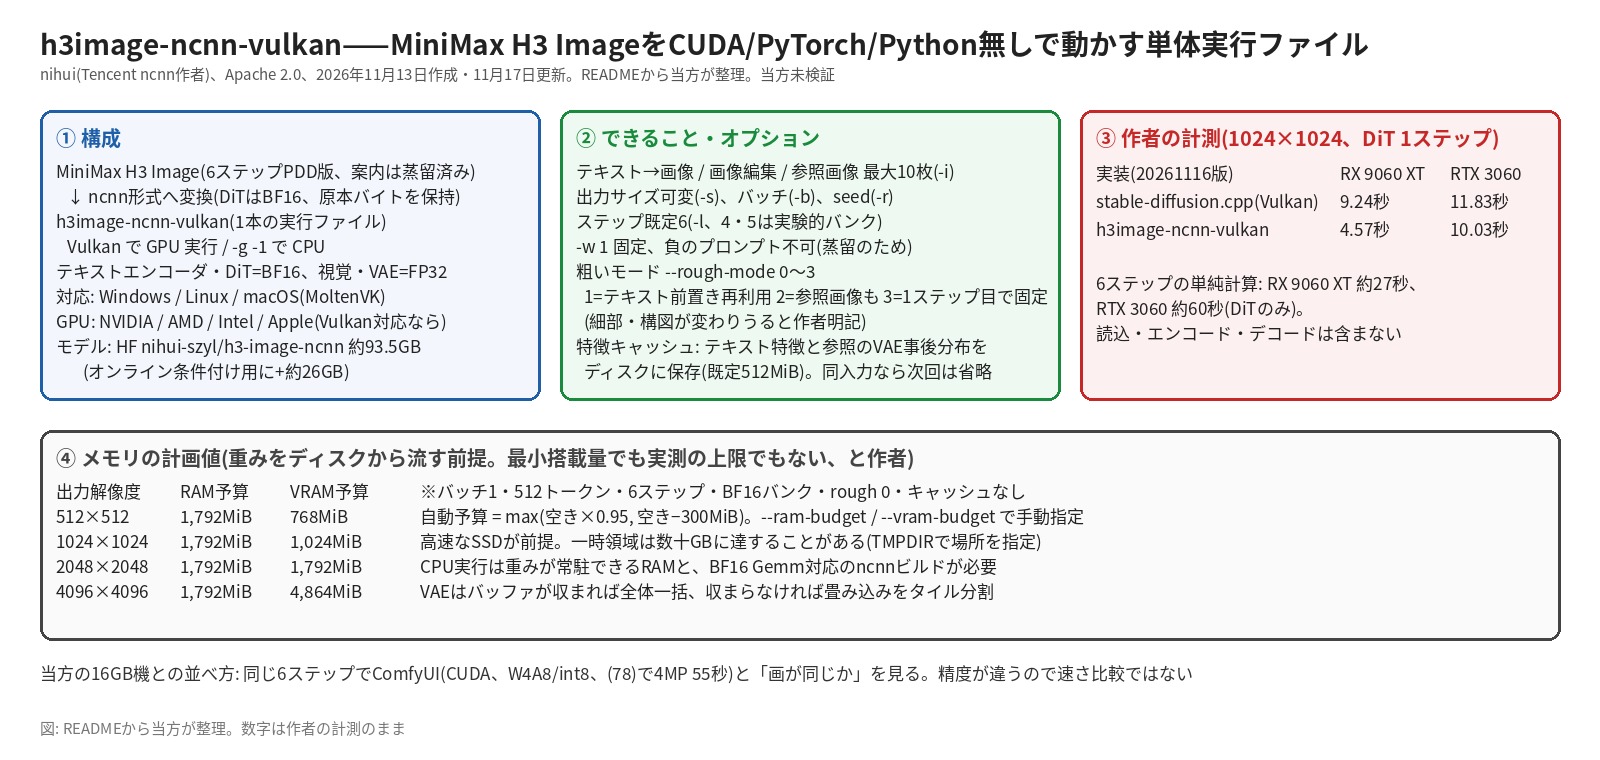
- 1本の実行ファイルで動く。Windows/Linux/macOSのビルドが自動で配布され、Vulkan対応のGPUがあれば動く。GPUがなければ
-g -1でCPU実行(BF16 Gemm対応のncnnビルドが要る)。 - できること: テキストから画像、画像編集、参照画像は最大10枚、バッチ生成、出力解像度は可変。H3 Imageの6ステップPDD版(案内が蒸留済み、
-w 1固定・負のプロンプト不可)を使う。 - 重みはBF16のまま約93.5GB。DiTのテンソルは原本のバイトを保持(量子化していない)。RAMとVRAMの予算から、常駐する重みとディスクから流す重みを自動で決める。1024×1024の計画値はRAM 1,792MiB・VRAM 1,024MiB(4096×4096でVRAM 4,864MiB)。高速なSSDが前提で、一時領域は数十GBに達することがある。
- 作者の計測(1024×1024、DiT 1ステップ): RX 9060 XTで4.57秒(stable-diffusion.cpp Vulkan版は9.24秒)、RTX 3060で10.03秒(同11.83秒)。Radeonで約半分、GeForceでも少し速い。
- 速度と引き換えの「粗い」モードが3段。テキストの前置きだけ再利用(1)、参照画像のトークンも再利用(2)、1ステップ目で前置きを固定(3)。構図や細部が変わりうると作者が明記。
- キャッシュ: テキスト特徴と参照画像のVAE事後分布をディスクに保存(既定512MiB)。同じ入力なら次回はエンコーダの読込と計算を飛ばせる。
何を公開しているか
| 項目 | 中身 |
|---|---|
| リポジトリ | nihui/h3image-ncnn-vulkan(Apache 2.0、2026年11月13日作成、11月17日更新) |
| 作者 | nihui(Tencent ncnnの作者。waifu2x-ncnn-vulkanと同じ系統) |
| 配布 | GitHub Releasesに日付タグ(YYYYMMDD)でWindows/Linux/macOSの単体パッケージ。ソースからのビルドはCMake(Linux=Vulkan SDK、Windows=Visual Studio+Vulkan SDK、macOS=Xcode CLT+MoltenVK) |
| モデル | Hugging Face nihui-szyl/h3-image-ncnn(ModelScopeにも)。processor・text_encoder・vision・transformer(core+固定変調バンク)・vae。約93.46GB。オンラインで条件付けを計算する場合は追加で約26GB |
| 精度 | テキストエンコーダとDiTはBF16、視覚とVAEはFP32 |
| 対応 | Vulkan対応GPU(NVIDIA/AMD/Intel/Apple)、CPU。Windowsの日本語・中国語プロンプトはUTF-8マニフェストで対応 |
| 依存 | ncnnのページド重みアロケータ(PR #7167)が必要。画像コーデックはサブモジュールから同梱 |
主なオプション
| オプション | 意味 |
|---|---|
-p / -o | プロンプト / 出力パス |
-i(最大10回) | 編集・参照の入力画像。<Picture 1>のように番号で指す |
-s 1536,864 | 出力サイズ(既定1024,1024、編集時は入力サイズ) |
-l 6 | ステップ数(既定6。他は実験的、4・5ステップ用の変調バンクは別配布) |
-b 3 | バッチ(エンコードとモデル読込を共有、seedは同じ乱数列から順に) |
--ram-budget / --vram-budget | 計画予算(MiB)。0で自動(空きの95%か空き−300MiBの大きい方) |
--rough-mode 0〜3 | 0=厳密、1=テキスト前置き再利用、2=参照画像も、3=1ステップ目で固定 |
--fixed-modulations 0/1 | 条件付けを事前計算バンクから読む(1、既定)かオンライン計算(0) |
--cache-dir / --cache-size | 特徴キャッシュの場所と上限(0で無効) |
-g | GPU番号(-1=CPU) |
作者の計測
| 実装(2026年11月16日版) | RX 9060 XT | RTX 3060 |
|---|---|---|
| stable-diffusion.cpp(Vulkan) | 9.24秒/step | 11.83秒/step |
| h3image-ncnn-vulkan | 4.57秒/step | 10.03秒/step |
1024×1024、DiTの1ステップあたり。6ステップなら単純計算でRX 9060 XTが約27秒、RTX 3060が約60秒(DiT部分のみ。エンコード・デコード・読込は含まない)。
当方の見方
- 「NVIDIA以外」への道が1本できた。(75)で並べたH3 Imageの量子化版は、Mac向けのMLX版を除けばCUDAのGeForce向けだった。Vulkanなら、Radeon・Intel Arc・古めのGeForce・Macが同じ実行ファイルで動く。
- 94GBの重みとSSDが条件。量子化せずBF16を保つ設計なので、ディスクは大きい。VRAMが小さくても動くのは、重みをディスクから流すから。速さはSSDの速さに左右される。
- 「VRAM 1GB台から」は計画値で、速さの保証ではない。作者も「最小の搭載量でも測った上限でもない」と書いている。
- 当方の16GB機で試す意味: 同じH3 Image・同じ6ステップで、ComfyUI(CUDA、(78)の実測: 4MPで55秒)と並べられる。ただし精度(BF16 vs W4A8/int8)が違うので、速さの比較ではなく「画が同じか」の比較になる。
- 編集の指示文は公式と同じ形。
<Picture 1>で参照を指す書き方は(73)の公式と同じ。
書いていないこと・確かめていないこと
- 当方は動かしていない。数字は作者のREADMEから。
- Macでの速度、Intel Arcでの速度は作者の表にない。
- 4・5ステップのバンクと粗いモードは「実験的」。
- 配布の実行ファイルの署名・ハッシュ確認の手順は、Releasesページで各自確認。
出典
- GitHub: nihui/h3image-ncnn-vulkan(README.md、src/、2026年11月17日時点)
- Hugging Face: nihui-szyl/h3-image-ncnn
- GitHub: MiniMax-AI/MiniMax-H3-Image(showcase、作者が構図の参考にしたと記載)
コメント