MiniMax H3で、1920×1080・24fps・10秒の台詞つき動画を16GBのGPUで3分台で出した、という公開記録が本日(11月16日)GitHubに上がった。当方は(93)で高速化LoRAの比較、(95)で日本語台詞の作り方を扱ってきたので、両方に関わる話として中身を読んだ。作者の実測値をそのまま並べ、当方で確かめていない点は最後に分ける。
目次
先に要点
- 出力は1920×1080・24fps・240フレーム(10秒)、音声つき。1920×1088のモデル格子でそのまま生成し、上下4pxを切る。アップスケールではない。
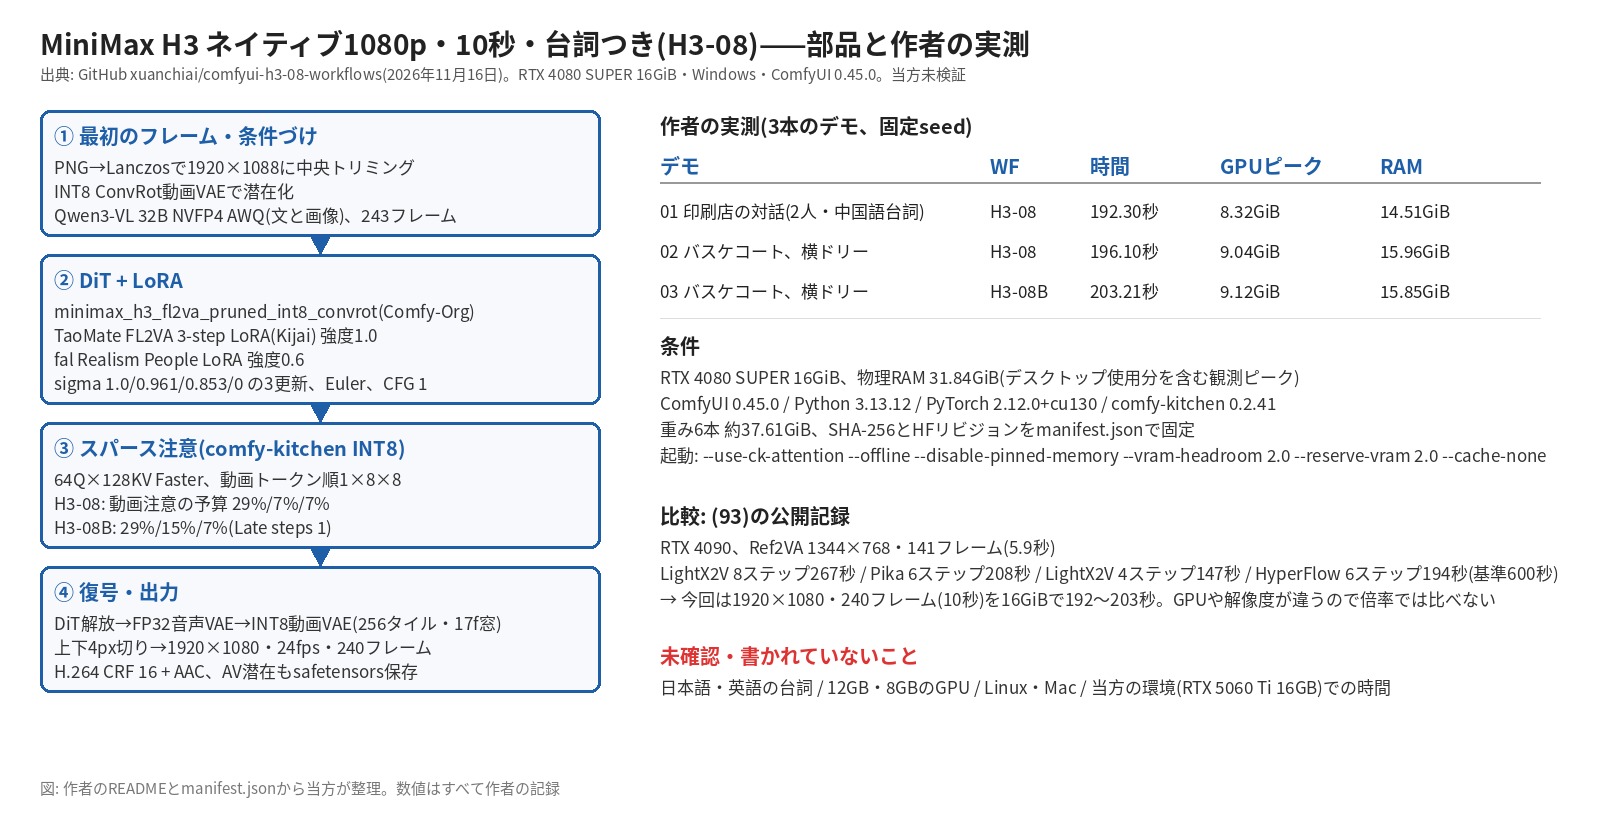
- 作者の実測はRTX 4080 SUPER(16GiB)で192.30〜203.21秒。GPU全体のピークは8.32〜9.12GiB、システムRAMは14.5〜16.0GiB(デスクトップ使用分を含む観測値)。
- 速さの正体は3段がさね。Comfy-Org配布のINT8 ConvRot pruned版DiT、TaoMate FL2VA 3-step LoRA(3更新)、comfy-kitchenのINT8スパース注意(動画トークンの注意量を7%または15%に絞る)。
- 台詞は中国語の2人芝居。印刷店の男女、バスケコートの男女(女「明天还来吗?」男「来。球我带。」)。英語・日本語の実測は書かれていない。
- 再現用の材料が全部ある。重み6本のSHA-256とHugging Faceのリビジョン、固定seed、入力画像2枚、プロンプト全文、使ったComfyUI/PyTorch/comfy-kitchenの版がmanifest.jsonに入っている。
- 当方未検証。16GB・Windows・ComfyUI 0.45.0の1台での記録で、作者自身が「8GiB GPUと16GiB RAMでの再現は未確認」と書いている。
何を公開しているか
| 項目 | 中身 |
|---|---|
| リポジトリ | xuanchiai/comfyui-h3-08-workflows(GPLv3、2026年11月16日作成) |
| ワークフロー | H3-08(動画注意の予算 29%/7%/7%)、H3-08B(29%/15%/7%)。i2v、最初のフレームとプロンプトを差し替え可 |
| 入れ方 | ComfyUI v0.45.0 Windows portableに、付属のinstall_h3.pyで2つのキャンバスとノード源を入れる。--download-modelsで重み6本(約37.61GiB)を元のHugging Faceリポジトリから取得。ハッシュ照合あり |
| 同梱ノード | ComfyUI-H3-Native1080(1080格子の条件づけ)、H3-StageRelease(段階ごとのモデル解放)、H3-WorkflowTools |
| 外部プラグイン | Zironic/H3-Optimizations(コミット固定でzip取得) |
| 起動フラグ | --use-ck-attention --offline --disable-pinned-memory --vram-headroom 2.0 --reserve-vram 2.0 --cache-none --disable-fast-disk |
部品(重み6本)
| 役割 | ファイル | 配布元 |
|---|---|---|
| DiT | minimax_h3_fl2va_pruned_int8_convrot.safetensors | Comfy-Org/MiniMax-H3 |
| テキスト・画像エンコーダ | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | Comfy-Org/MiniMax-H3 |
| 動画VAE | minimax_h3_video_vae_int8_convrot.safetensors | Comfy-Org/MiniMax-H3 |
| 音声VAE | minimax_h3_audio_vae_fp32.safetensors | Comfy-Org/MiniMax-H3 |
| 高速化LoRA | minimax_h3_taomate_fl2va_3step_avg_rank_19_bf16.safetensors(強度1.0) | Kijai/MiniMax-H3-experimental |
| 写実LoRA | h3-realism-people-t2v-i2v-r2v.safetensors(強度0.6) | fal/MiniMax-H3-Realism-People-LoRA |
(93)で比べたLightX2V・Pika・HyperFlowとは別系統のTaoMate 3-stepで、sigmaは1.0 / 0.961165 / 0.853333 / 0.0の3更新、Euler、CFG 1。
主な設定
| ノード | 設定 |
|---|---|
| 最初のフレーム | PNGをLanczosで1920×1088に中央トリミング |
| 条件づけ | INT8 ConvRot動画VAEで最初のフレームを潜在化。Qwen3-VL 32B NVFP4 AWQ、vision幅1280、モデル長243フレーム、0秒に最初のフレーム条件 |
| 時間のずらし | video shift 12、audio shift 3 |
| メモリ | activation chunk rows 4096、Fused QKV・MLP最適化・精度・QKVストリーミングはAuto、Vメモリは「Lower VRAM(遅い)」 |
| スパース注意 | Kitchen INT8 64Q×128KV Faster、動画トークン順1×8×8、Early steps 1、Early KV 0.29。H3-08は動画注意予算0.07、H3-08BはLate steps 1・Late KV 0.07・予算0.15 |
| 出力 | 音声・動画の潜在をsafetensorsで保存→DiTを解放→FP32音声VAEで復号→INT8動画VAEで256タイル・17フレーム窓(5重なり)で復号。H.264 CRF 16、AAC |
作者の実測(3本のデモ)
| デモ | ワークフロー | 時間 | GPU全体のピーク | システムRAM |
|---|---|---|---|---|
| 01 印刷店の対話 | H3-08 | 192.30秒 | 8.32GiB | 14.51GiB |
| 02 バスケコート、横ドリー | H3-08 | 196.10秒 | 9.04GiB | 15.96GiB |
| 03 バスケコート、横ドリー | H3-08B | 203.21秒 | 9.12GiB | 15.85GiB |
条件: Windows x64、RTX 4080 SUPER 16GiB、物理RAM 31.84GiB、ComfyUI 0.45.0、Python 3.13.12、PyTorch 2.12.0+cu130、comfy-kitchen 0.2.41。固定seed 411064。作者の観察では、02と03で背景のバックボードが4.50秒までに862px/878px動き、揺れる髪と細い背景線が短く柔らかくなった。顔と背景の主要構造は検査したフレームで連続。H3-08BはH3-08より7.12秒長く、この場面では細部に小さな差。
当方の見方
- (93)との関係: (93)はRTX 4090で1344×768・141フレーム(5.9秒)の公開記録(LightX2V 8ステップ267秒ほか)だった。今回は1920×1080・240フレーム(10秒)で、しかも16GB。部品の組み合わせ(pruned INT8+3-step LoRA+スパース注意)が、16GBで1080pを通す道筋として一つの答えになっている。
- (95)との関係: 台詞は中国語で、英語・日本語の実測はない。(95)で整理したとおり、日本語台詞は外で作って口を合わせる方針は変わらない。ただ、1080pで2人の顔を保ったまま台詞を出せるなら、口合わせの土台としては使える。
- 当方で試すなら: RTX 5060 Ti 16GBはメモリ容量は同じだが帯域と演算は4080 SUPERより下なので、時間はそのままでは当てはまらない。重み37.61GiBの取得とWindows portable前提の導入手順が先。
書いていないこと・確かめていないこと
- 当方は動かしていない。数値はすべて作者の記録。
- 日本語台詞の品質、他のGPU(12GB、8GB)での動作、Linux・Macでの導入は書かれていない。
- 作者はGitHubアカウントがこのリポジトリ1本のみで、他の発信は確認できていない。
- H3で生成した動画の配布範囲はH3コミュニティライセンスの地域条項による、とREADMEにある。
出典
- GitHub: xuanchiai/comfyui-h3-08-workflows(README、manifest.json、prompts/、2026年11月16日)
- Hugging Face: Comfy-Org/MiniMax-H3、Kijai/MiniMax-H3-experimental、fal/MiniMax-H3-Realism-People-LoRA(manifestに記載のリビジョン)
コメント