(95)で「H3の日本語台詞は外で作る」と整理し、その本命にIrodori-TTSを挙げた。次に出てきた問いは「誰かの声を参照して一貫性を出すのではなく、声そのものを文や数値で作って、固定できないか」。Irodori-TTS v4.1-Smallには、その両方の入口がある。文で声を指定する Voice Design と、声を小さな埋め込みファイルに固定する Speaker Inversion。Windows機(RTX 5060 Ti 16GB)で試した。
先に要点
- 参照音声なしで、文だけから日本語台詞の声が出る。
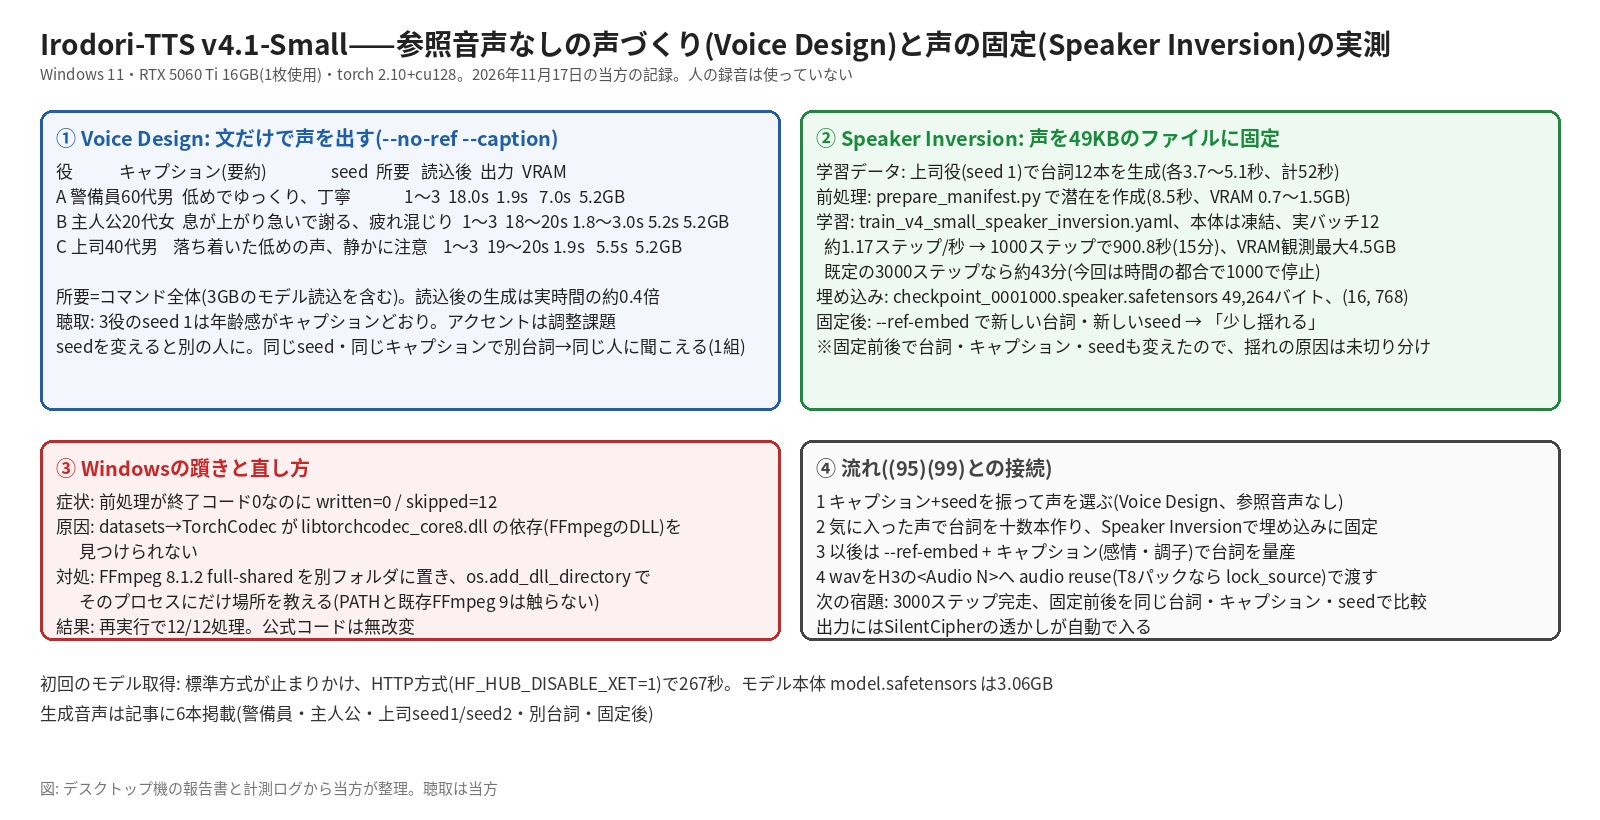
--no-refと--caption "60代の男性。低めでゆっくり、丁寧な話し方…"で生成。60代男性・20代女性・40代男性の3役は、年齢感がキャプションどおりに出た(当方の聴取)。アクセントは調整課題。 - 速い。1本あたり約18〜21秒のうち、3GBのモデル読込が大半。読込後の生成は4〜7秒の音声に1.7〜2.0秒(実時間の約0.4倍)。VRAMの観測最大は約5.2GB。
- 同じseed・同じキャプションなら、台詞を変えても同じ人に聞こえた(上司役seed 1で1組)。seedを変えると別の人になる。
- 声を49KBのファイルに固定できた。気に入った上司役(seed 1)で台詞12本を作り、それを学習データにSpeaker Inversionで話者埋め込み(16×768)を学習。1000ステップで15分、VRAM約4.5GB。以後は
--ref-embedで参照音声なしに同じ声を呼べる。 - 固定後の声は「少し揺れる」。既定の3000ステップのうち1000で止めたこと、固定前後で台詞・キャプション・seedも変えたことが重なっているので、揺れの原因は切り分けていない。
- Windowsの躓きは1つ。学習の前処理でdatasetsがTorchCodec経由で音声を読む際、FFmpegのDLLが見つからず12本すべてスキップ。FFmpeg 8のfull-shared版を別フォルダに置き、そのプロセスにだけDLLの場所を教えて直した。
生成した声(いずれも参照音声なし、人の録音は使っていない)
警備員役(60代男性)。キャプション「60代の男性。低めでゆっくり、丁寧な話し方。職場の通用口で顔なじみの社員に声をかけている」、seed 1。
主人公役(20代女性)。キャプション「20代の女性。少し息が上がっていて、急いで謝っている。明るいが疲れが混じる」、seed 1。
上司役(40代男性)。キャプション「40代の男性。落ち着いた低めの声で、部下に静かに注意している」。seed 1と2で別の人になる。
同じseed 1・同じキャプションで台詞を変えると、同じ人に聞こえる。
Speaker Inversionで固定した埋め込み(1000ステップ)から、新しい台詞・新しいseedで生成。
環境と手順
| 項目 | 内容 |
|---|---|
| 機材 | Windows 11 Pro、RTX 5060 Ti 16GB×2のうち1枚だけ使用(CUDA_VISIBLE_DEVICES=0)、RAM 64GB、ドライバ610.88 |
| ソフト | Irodori-TTS(GitHub Aratako/Irodori-TTS、2026年11月9日時点)、uv sync --extra cu128、Python 3.10、torch 2.10.0+cu128 |
| モデル | Aratako/Irodori-TTS-v4.1-Small(MIT)。model.safetensors は3.06GB。初回取得は標準方式で止まりかけ、HTTP方式(HF_HUB_DISABLE_XET=1)に切り替えて267秒 |
| 生成 | infer.py --hf-checkpoint Aratako/Irodori-TTS-v4.1-Small --text … --caption … --no-ref --seed N |
| 固定(学習) | 同じキャプション・seed 1で台詞12本を生成 → prepare_manifest.py で潜在を作成 → train.py --config configs/train_v4_small_speaker_inversion.yaml |
| 固定後の生成 | infer.py --checkpoint model.safetensors --ref-embed checkpoint_0001000.speaker.safetensors --text … --caption … |
実測
| 項目 | 値 |
|---|---|
| 1本の所要(コマンド全体、モデル読込込み) | 17.96〜21.24秒(10本の中央値18.5秒) |
| 読込後の生成 | 1.71〜1.99秒(4.0〜7.0秒の音声) |
| VRAM観測最大(生成) | 4,762〜5,242MiB |
| 出力 | 48kHz・モノラルWAV、クリッピング0 |
| 固定学習(Speaker Inversion) | 12本(各3.7〜5.1秒)、実バッチ12、約1.17ステップ/秒。1000ステップで900.8秒、VRAM観測最大4,536MiB。既定の3000ステップなら約43分 |
| 埋め込みファイル | 49,264バイト、shape (16, 768) |
当方の聴取
| 確認 | 結果 |
|---|---|
| 3役のseed 1 | 「アクセントの付け方等はのちにチューニングできる前提で、各キャラの年齢感等は再現されていると思います」 |
| 同じseed・同じキャプションで別台詞(上司役) | 「同じ人に聞こえる」 |
| 固定した埋め込みからの生成 | 「少し揺れる」。途中でもそこそこ声質は似ていた |
seed 2・3は未評価。
躓きと直し方(Windows)
学習の前処理(prepare_manifest.py)は、datasetsライブラリがTorchCodecで音声を読む。Windowsでは libtorchcodec_core8.dll の依存(FFmpegのDLL)が見つからず、終了コードは0なのに12本すべてスキップ(written=0)になった。対処は、FFmpeg 8.1.2のfull-shared版(gyan.devの配布、SHA-256を配布元の掲載値と照合)を別フォルダに置き、Pythonの os.add_dll_directory でそのプロセスにだけ場所を教えること。システムのPATHや既存のFFmpeg 9は触らない。再実行で12/12が処理された。公式コードは無改変。
当方の見方
- 「声を参照せずに作る」は、この1本で成立する。文で声を選び(Voice Design)、気に入った声を自分の生成音声から埋め込みに固定する(Speaker Inversion)。学習データに人の録音を使わないので、声の権利の問題が最初から起きない。
- 固定の精度は次の宿題。今回は時間の都合で1000ステップで止めた。切り分けるには、固定前後で同じ台詞・同じキャプション・同じseedを比べる。3000ステップの完走と合わせて続報にする。
- H3との接続: できたwavをH3の
<Audio N>にaudio reuse((99)のT8パックならlock_source)で渡す。(95)(99)の整理のとおり、H3には口だけ合わせてもらう。 - 出力にはSilentCipherの透かしが自動で入る((95)で記載)。公開する音声にも入っている。
書いていないこと・確かめていないこと
- アクセントの修正方法(ひらがな指定・絵文字・キャプションの書き方)は今回試していない。
- Mac(MPS)での生成は試していない。READMEでは
uv sync --extra cpuで対応。 - 埋め込み(16×768の数値)を混ぜて新しい声を作れるかは、READMEに記載がなく未検証。
出典
- GitHub: Aratako/Irodori-TTS(README「VoiceDesign」「Speaker Inversion」の節、2026年11月9日時点)
- Hugging Face: Aratako/Irodori-TTS-v4.1-Small
- 当方の実測記録(2026年11月17日、Windows 11・RTX 5060 Ti 16GB)
コメント