(95)で「H3の日本語台詞は外で作って、H3には口だけ合わせてもらう」と整理した。その裏づけになる一次情報を、H3用のComfyUIノードパックの中に見つけたので続報にする。対象は GitHub の T8mars/comfyui-minimax-h3-audio-T8。11月17日 04:54(日本時間)に v1.106.0 が出た。
目次
先に要点
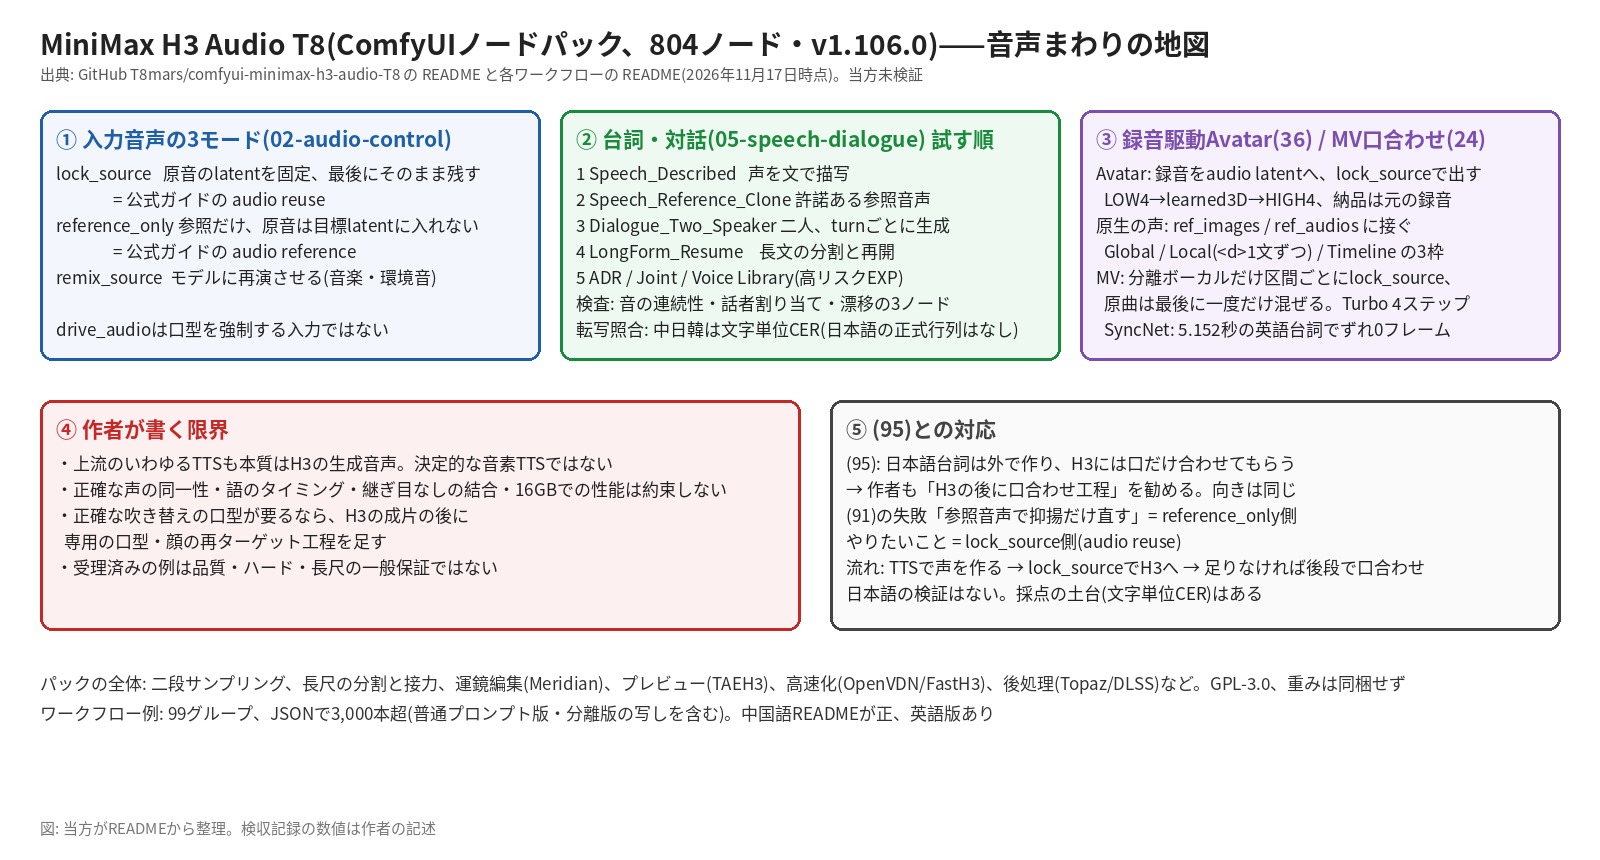
- H3の音声・口型・二段サンプリング・長尺・運鏡編集まで入った大型パック。ノード数は作者の数えで804(v1.106.0で16追加)。ワークフロー例は99グループ・JSONで3,000本超(普通プロンプト版や分離版の写しを含む)。GPL-3.0、重みは同梱せず。
- 入力音声の扱いは3モード。
lock_source(原音をできるだけ保つ)、reference_only(参照だけで、原音を目標のlatentに入れない)、remix_source(モデルに再演させる)。(95)で見たH3公式ガイドの audio reuse / audio reference と同じ分け方。 - 台詞は「描写した声→参照した声→二人の順番対話→長文の分割と再開」の順に試す構成で、転写の照合(中日韓は文字単位のCER)、話者の割り当て検査、音声の連続性検査のノードがある。
- 録音で駆動するAvatar(録音をaudio latentに入れ、
lock_sourceで出す)と、分離ボーカルで口を合わせるMV用の経路がある。5.152秒の英語台詞で、SyncNetのずれ0フレーム(画面を0.4秒遅らせた対照は10フレーム)という検収記録。 - 作者自身の限界の記述が明確。「上流のいわゆるTTSも本質はH3の生成音声で、決定的な音素TTSではない」「正確な声の同一性・語のタイミング・継ぎ目なしの結合・16GBでの性能は約束しない」「正確な吹き替えの口型が要るなら、H3の成片の後に専用の口型・顔の再ターゲット工程を足す」。
- 当方未検証。日本語の検証は見当たらない(正式な多言語行列は中英)。
何を公開しているか
| 項目 | 中身 |
|---|---|
| リポジトリ | T8mars/comfyui-minimax-h3-audio-T8(GPL-3.0-or-later、2026年8月5日作成、★1,277) |
| 最新版 | v1.106.0(2026年11月17日 04:54 JST)。2D潜在アップスケール、LoRAの区間指定、音声の接続、二段サンプリングの修正 |
| 入れ方 | custom_nodes に clone、再起動。ComfyUI Manager でも「MiniMax H3 Audio T8」で検索可(Registryの反映はGitHubと別) |
| 前提 | ComfyUI本体のH3ネイティブ対応 |
| 付随の重み(別配布) | TAEH3(一段目のプレビュー用)、Meridian(運鏡編集)、Semantic Bridge、OpenVDN、H3-World action LoRA。いずれもHugging Faceのt8star |
| 文書 | 中国語READMEが正、英語版READMEあり |
音声の3モード((95)との対応)
| モード | 何をする | H3公式ガイドの用語 | (95)の整理 |
|---|---|---|---|
lock_source | 入力音声のlatentを固定し、最後の mux_audio で入力の音をそのまま残す | audio reuse(信号そのまま) | やりたいのはこちら |
reference_only | 音声を参照にだけ使い、原音を目標のlatentに入れない | audio reference(音色・リズムの参照) | 当方の失敗((91))はこちら側 |
remix_source | モデルに入力の音を混ぜ直させ、再演させる | — | 音楽・環境音の作り直し向き |
作者の注意書き: drive_audio は口型を強制する入力ではない。lock_source で音は残っても、H3は画面を共同生成で予測するので、口が音素ごとに追従するとは限らない。add_source_as_reference を併用し、プロンプトで正しい <Audio N> を参照し、台詞が分かっているなら <d>逐字の台詞</d> を添える。正確な吹き替えの口型が要るなら、H3の成片の後に専用の口型・顔の再ターゲット工程を足す。
台詞・対話のワークフロー群(05-speech-dialogue)
| 順 | ワークフロー | 中身 |
|---|---|---|
| 1 | Speech_Described | 一人。声を文で描写して出す |
| 2 | Speech_Reference_Clone | 許諾のある参照音声を接ぎ、転写と声の類似を確かめる |
| 3 | Speech_Dialogue_Two_Speaker | 二人。順番(turn)ごとに生成して混ぜる |
| 4 | Speech_LongForm_Resume | 長文を分割、受理済みの区間を残して再開 |
| 5 | ADR / Joint Dialogue / Voice Library / 背景床 | より高リスクの実験(EXP) |
| 検査 | Audio_Integrity_Audit | 標本数・A/V境界・冒頭の急変・DC・クリップ・末尾の巻き戻しを検査 |
| 検査 | Speaker_Routing_Audit | 複数人の生成前に、人物→参照音声の対応が一意かを検査 |
| 検査 | Audio_Perceptual_Drift_Audit | 受理した一段目の音と、同内容・同時間線の候補の漂移を比較 |
転写の照合は Unicode NFKC + casefold。中日韓は文字単位のCER、ラテン系はWER。正式な多言語の検証行列は中国語・英語の各10発話×(描写/参照)×固定seed3つ=120件。日本語の行列は見当たらない。
録音で駆動するAvatarと、MVの口合わせ
| 経路 | 中身 | 作者の検収記録 |
|---|---|---|
| Avatar(36-avatar-voice) | 録音をaudio latentに符号化し、二段ともmask=0、納品は元の録音をそのまま使う。LOW4→learned3D→HIGH4 | 指定の見本は利用者の最終検収済み。「声紋100%や正確な語は保証しない」 |
| 原生の声(同) | 参照画像・参照音声を ref_images / ref_audios に接ぎ、drive_audio は使わない。Global(人物・音色・場面)/Local(台詞1文ずつ <d>)/Timeline の3枠 | 8秒2段、0〜2秒・2〜4秒に1文ずつ、4秒以降は無言の動作(うなずき・手振り)を明示 |
| MV口合わせ(24-mv-lipsync) | 分離したボーカルだけを区間ごとに lock_source でH3へ、原曲は最後に一度だけ混ぜる。Ref2V Turbo 4ステップ、1024×768、shift 12/3 | 5.152秒の英語台詞(736×416×124)でSyncNet 0フレーム。32秒・5カットの本編で各カット 0/−1/0/−1/0 フレーム |
作者が書く限界(READMEの「Important limits」から)
- Advanced / EXP は対応するワークフローで使う。受理済みの例は、品質・ハード・長尺の一般保証ではない。
- 正確な声の同一性、語のタイミング、継ぎ目なしの結合、16GBでの一般的な性能は約束しない。継ぎ目の色の微変化は既知の制限。
- Topaz・DLSS は別ランタイムの後処理で、H3の重みだけでは動かない。
当方の見方
- (95)の結論「日本語台詞は外で作る」は、このパックの作者の記述と同じ向きにある。作者は「H3は決定的な音素TTSではない」と書き、正確な吹き替えにはH3の後に口合わせ工程を足すことを勧めている。(95)で候補に挙げたTTSで声を作り、
lock_sourceでH3に入れ、足りなければ専用の口合わせを後段に置く、という流れになる。 - 当方が(91)で失敗した「参照音声で抑揚だけ直す」は、このパックの分類では
reference_only側。やりたかったのはlock_source側で、(95)の整理と一致する。 - 日本語の検証はない。中日韓の転写照合が文字単位のCERで入っているので、日本語で試すときの採点の土台はある。
- 804ノードは当方の環境(RTX 5060 Ti 16GB)にそのまま入れる規模ではない。試すなら
02-audio-controlの3モードと36-avatar-voiceの録音駆動から。
書いていないこと・確かめていないこと
- 当方は動かしていない。数値・検収記録はすべて作者の文書から。
- 日本語台詞の品質、16GBでの動作、Macでの導入は書かれていない。
- 作者の配布物のうち、Meridianの重みはH3コミュニティライセンス、OmegaはFAIRの非商用研究ライセンス。利用条件は各自で確認。
出典
- GitHub: T8mars/comfyui-minimax-h3-audio-T8(README.md / README_EN.md、docs/RELEASE_1.106.0.md、examples/workflows/02-audio-control・05-speech-dialogue・24-mv-lipsync・36-avatar-voice の各README、2026年11月17日時点)
- Hugging Face: t8star(TAEH3・Meridian・Semantic Bridge・OpenVDN・H3-World)
コメント