走る女性シリーズの(91)で、警備員の「おつかれさま、おそくまでごくろうさまです」を自然にするのに9版かかった。MiniMax H3は映像と口の動きは良いが、日本語の台詞の抑揚は弱い。当方の録音した声を「抑揚の参照」として足すと、参照画像4枚のうえに音声が乗ってメモリ不足で止まるか、通っても録音の声そのものが出る。
そこで割り切る。台詞は、台詞に強い音声合成で先に作る。役柄に合う声質と正しいアクセントをそこで決めて、H3には音声を渡して口を合わせてもらう。H3のリップシンクは当方の経験では安定している。この記事は、その「外で作る」ための道具を集めたもの。当方はまだ試していない。H3でこの壁に当たっている人は多いはずなので、先行情報として出す。
先に要点
- H3への渡し方は2種類ある。公式のプロンプトガイドで、
<Audio N>の関係は audio reuse(同じ音声信号をそのまま全部または一部使う)と audio reference(信号はコピーせず、音色・台詞の内容・リズムなどを参照する)に分かれている。当方が(91)で試して「録音の声が出た」のはreference側。今回やりたい「外で作った台詞をそのまま使い、口だけ合わせる」はreuse側で、ガイド上は正規の使い方。 - 本命はIrodori-TTS v4.1-Small。日本語専用、コードも重みもMIT。参照音声(30秒以上推奨、短いクリップを連結できる)とキャプション(文章で「余裕のある大人の男性、くだけた雰囲気で呆れながらも楽しそうに」のように声と調子を指定)の両方で声を作れる。作者は「声質は参照音声、感情や調子はキャプションに分担せよ」と明記している。Mac(MPS)でも動く。
- アクセントを手で決めたいならVOICEVOX。老年男性・中年男性などの既存キャラの声で、GUIでモーラ単位のアクセントと長さを直せる。声はキャラ固定でクローンはできず、公開物にクレジット表記が要る。
- 声質を固定したいならGPT-SoVITS。1分の音声で学習できる。H3が出した警備員の声を1分集めて学習させれば、同じ声で何本でも台詞が作れる。環境構築は重め。
- 多言語系はライセンスで選ぶ。Qwen3-TTS・VoxCPM2・CosyVoice 3はApache-2.0で商用可。Fish Speech S2 Proは聴感が最も自然という評がある一方、非商用ライセンスで、生成が極端に遅い。
- 対象外: Fish Audio Drama 3(会話劇向けだが35B MoEで16GBでは動かない)、IndexTTS2(日本語を入れたら中国語で出た報告)、Chatterbox・Kokoro・Voxtral(日本語が弱いかない)。
なぜ「参照」でなく「再利用」なのか
H3のプロンプトガイド(VIDEO_PROMPT_WRITING_GUIDE_ref_en.md)は、参照素材ごとにラベルを付け、素材と出力の関係を宣言する書き方を求める。音声については次の2つが別の関係として定義されている。
| 関係 | 意味 |
|---|---|
| audio reuse | 同じ音声信号を、全部または一部そのまま使う |
| audio reference | 音声信号は直接コピーしない。音楽のスタイル、音色、台詞や歌詞の内容、効果音の質感、拍、連続性だけを参照する |
話者との対応は <Audio 1> is the voice-timbre reference for <Subject 1> (S1). のように、全体の話者番号で結ぶ。
当方が(91)でやったのは「警備員の声質は保ち、録音から抑揚だけ参照する」で、referenceの範囲で音色と抑揚を分離することを求めていた。ガイドには「音色の参照」と「台詞内容の参照」は書いてあるが、「抑揚だけ」を分離して参照できるとは書いていない。結果として録音の声が出た。これはモデルの欠陥というより、ガイドにない分離を求めたということだと今は読んでいる。
reuseなら、音声はそのまま使われる。声質も抑揚も外で決めてある前提なので、H3に求めるのは口の動きと場面だけになる。参照音声でH3に「演技」を求めるのをやめ、H3には「口」だけ任せる、という割り切り。
候補8本
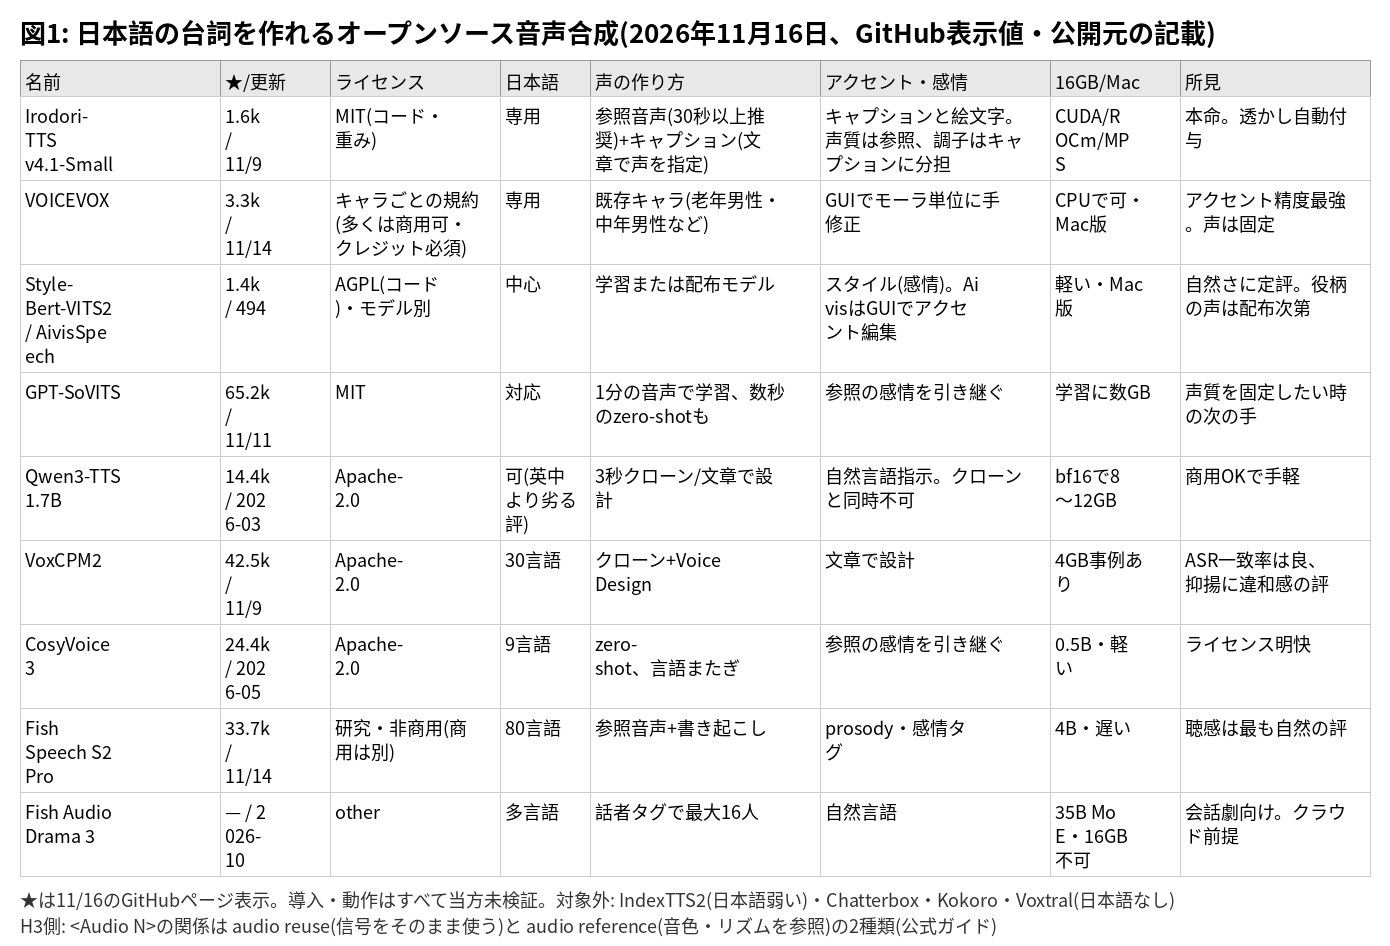
★は2026年11月16日のGitHubページの表示値。機能の説明は公開元のREADMEとモデルカードの範囲で、当方は導入していない。
1. Irodori-TTS v4.1-Small(Aratako)——本命
- 日本語専用のFlow Matching型TTS。コードMIT、重み(Hugging Face)もMIT。1.6k★、11月9日更新。
- 声の作り方が3通り: ①参照音声だけ ②キャプション(文章)だけ ③両方。参照は30秒以上を推奨し、同じ話者の短いクリップを複数連結できる(最大120秒)。キャプションの例が「余裕のある大人の男性。親しい相手に対して、くだけた雰囲気で呆れながらも楽しそうに話している。」で、絵文字で笑いや溜息などの非言語表現も入れられる。
- モデルカードの注意: 参照音声とキャプションが矛盾すると不安定になる。声質は参照音声に合わせ、キャプションは感情・スタイル・環境の指定に使う。日本語以外は入力できない。
- CUDA 12.8、ROCm、Intel XPU、macOSのCPU/MPSに対応。6ステップの高速設定あり。第三者の比較(後述)では速度と品質のバランスが最良と評されている。
- 注意: 生成音声にSilentCipherの透かしが自動で入る(依存関係が揃っている場合)。H3を通した後に残るかは未確認。
- 当方の使い方の想定: (91)の00099と00102から警備員の発話を切り出して参照にし、キャプションで「60代、低め、ゆっくり、丁寧」を足す。台詞はひらがな混じりで。
2. VOICEVOX——アクセントを手で直す
- 日本語の音声合成ソフト(費用なしで使える)。エディタ3.3k★、エンジン1.8k★、11月14日更新。Mac版あり、CPUで動く。
- 既存のキャラクターから選ぶ。老年男性、中年男性の声がある。GUIでモーラ単位にアクセント・音高・長さを手で修正できるのが最大の強み。スタイル(ノーマル・喜びなど)もキャラによってある。
- 声はキャラ固定で、H3が出した声には寄せられない。音声の利用規約はキャラごとで、多くは商用可だが「VOICEVOX:キャラ名」のクレジット表記が必要。動画の説明と記事に入れる。
3. Style-Bert-VITS2 / AivisSpeech
- 日本語中心の学習型TTS。Style-Bert-VITS2(litagin02、1.4k★)はスタイル(感情)ベクトルで調子を変える。AivisSpeech(494★)はこれを土台に、VOICEVOX互換のGUIでアクセント編集ができる形にしたもの。
- 役柄の声は、配布されているモデルから選ぶか、許諾のある音声で自分で学習する。コードはAGPL、モデルのライセンスは配布元ごと。
4. GPT-SoVITS(RVC-Boss)——声質を固定する
- 65.2k★、MIT、11月11日更新。1分の音声で学習して声を固定できる。数秒の参照でのzero-shotもある。日本語はv2以降で対応。
- 参照音声の感情を引き継ぐ型で、アクセントは読み(かな)で調整する。学習に数GBのVRAM、推論は軽い。Windowsの一体版が主流で、環境構築は8本の中では重い。
5〜8. 多言語系
| 名前 | ライセンス | 日本語 | 特徴 |
|---|---|---|---|
| Qwen3-TTS 1.7B(Alibaba) | Apache-2.0 | 可。英語・中国語より劣るという評 | 3秒の参照でクローン。文章で声を設計する版もある。クローンと感情指示は同時に使えない。bf16で8〜12GB |
| VoxCPM2(OpenBMB) | Apache-2.0 | 30言語の1つ | クローン+文章による声の設計。4GB GPUの事例あり。第三者比較で文字の一致率は最良、抑揚に違和感の評 |
| CosyVoice 3(Alibaba) | Apache-2.0 | 9言語の1つ | zero-shot、言語をまたぐクローン。参照の感情を引き継ぐ。0.5Bで軽い |
| Fish Speech S2 Pro(Fish Audio) | 研究・非商用(商用は別契約) | 80言語の1つ | 参照音声+その書き起こしが要る。prosodyや感情タグ。聴感は最も自然という評だが、4Bで生成が極端に遅い |
同じFish Audioの Drama 3(10月公開)は話者タグで最大16人の会話を1本で作れる会話劇向けだが、35BのMoEで、ローカルの16GBでは動かない。クラウド前提なので今回は対象外。
第三者の比較から読めること
- zennの比較記事(2026年6月、RTX 5060 Ti 16GB、筆者1名の声で音響分析): Irodori 500M/600M VoiceDesign・Qwen3-TTS 1.7B・Fish Speech S2 Pro・CosyVoice2・VoxCPM2の6本。総合はVoxCPM2・Irodori VoiceDesign・Fishがほぼ同点。抑揚はIrodori VoiceDesignが最良。Fishは最も自然だが生成が120倍以上遅い。Qwen3-TTSは数字や専門語で崩れやすい。「Irodoriで原稿と参照を詰め、仕上げを少数Fishで」という運用提案。
- neosophieの比較(2026年4月): 商用かつ日本語重視ならQwen3-TTS、ライセンスの明快さならCosyVoice 3、非商用の最有力がFish、IndexTTS2は日本語が弱い。
- どちらも1名の声・短い文での評価で、一般化はできない。当方が選ぶなら、日本語専用で参照とキャプションを両方持つIrodoriを最初に試す。
当方の手順(案・未実施)
- H3が出した警備員の声(00099・00102)から発話部分を切り出し、計30秒を目標に連結して参照にする。
- Irodori-TTSに台詞(ひらがな混じり)、参照音声、キャプション(年齢・調子)を渡してwavを作る。アクセントが気になる箇所は読みを変えて再生成。どうしても決まらなければVOICEVOXで作り直し、クレジットを付ける。
- H3のプロンプトで
<Audio 1>を定義し、関係を audio reuse にして、話者(Sx)と結ぶ。参照画像は女性・バッグ・背景・警備員の4枚のまま。 - 0.5MPで1本通し、メモリと口の同期を確認。0.6MPは通ってから。
書いていないこと
- 8本とも当方は未導入。数字と機能は公開元とモデルカード、第三者記事の転記。
- H3のaudio reuseで、参照画像4枚+台詞音声を載せたときのメモリ(未確認)。
- Irodoriの透かしがH3の音声パスを通った後に残るか(未確認)。
- 各ツールの商用利用の可否は、ここに書いた範囲でなく、使う前にライセンス原文を読む。
出典
- MiniMax H3 公式: docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md(Hugging Face MiniMaxAI/MiniMax-H3)
- GitHub: Aratako/Irodori-TTS、VOICEVOX/voicevox、litagin02/Style-Bert-VITS2、Aivis-Project/AivisSpeech、RVC-Boss/GPT-SoVITS、QwenLM/Qwen3-TTS、OpenBMB/VoxCPM、FunAudioLLM/CosyVoice、fishaudio/fish-speech(2026年11月16日閲覧)
- Hugging Face: Aratako/Irodori-TTS-v4.1-Small、fishaudio/drama-3、fishaudio/s2-pro
- 第三者比較: zenn「日本語ボイスクローン6モデル比較」(2026年6月18日)、neosophie「日本語オープンソースTTS比較」(2026年4月)
コメント