(76)で「MuseからTailscaleで自宅PCを使う」報告をまとめたら、1日でリンクが664回クリックされた。読みに来た人の多くはMuseを使っていて、次に何を繋げばいいかを探している。GitHubには、Museに動画を作らせるための部品が出そろい始めている。①企画をプロンプトに変えるスキル ②生成をどこでやるか ③H3側の部品、の3段で整理する。星の数は11月12日 18:10取得。
先に結論
- 「スキル」は、SKILL.mdを置いたフォルダ。 Agent Skillsという共通の形式で、Museに限らずClaude CodeやCodexでも同じものが読める。Museに「このスキルを使えるようにして」と渡すだけで、企画から指示文まで手順どおりに動く。
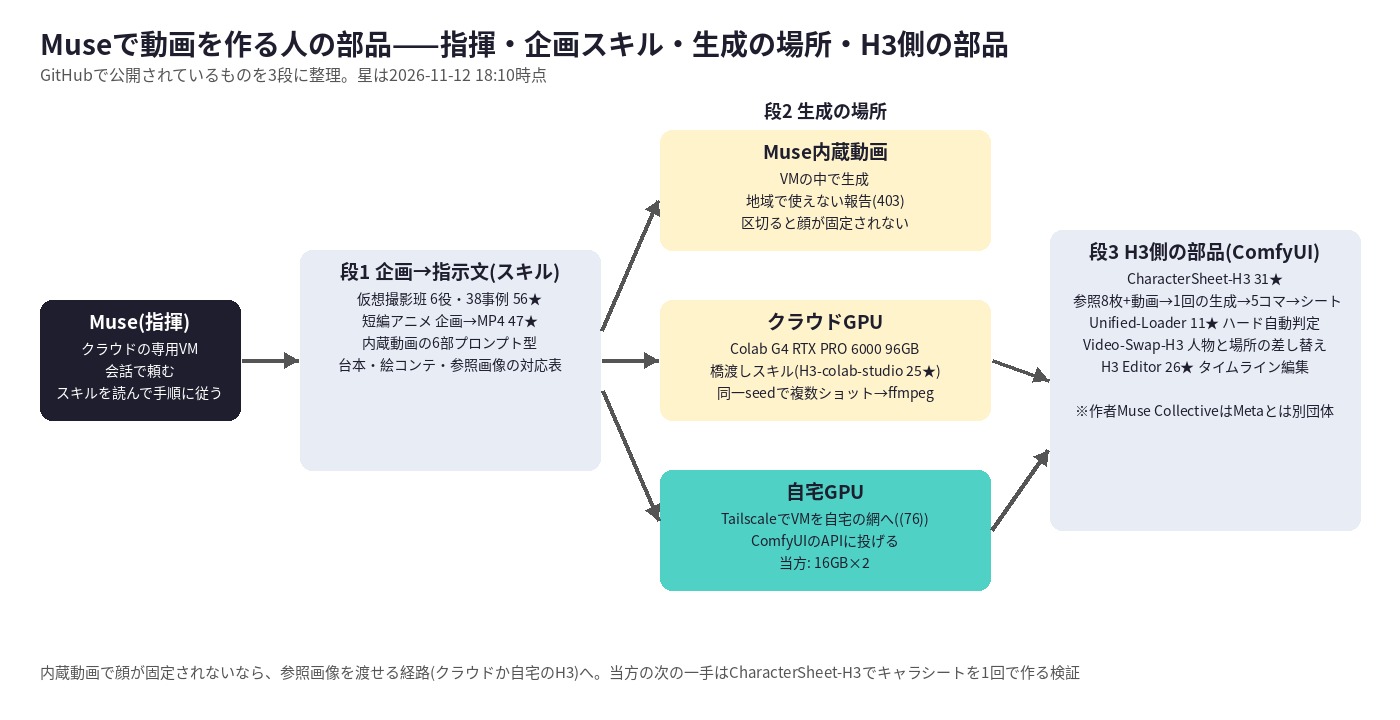
- 企画側のスキルは3つの型。 仮想撮影班(監督・脚本・撮影・美術・特効・音の6役で台本と絵コンテを作り、動画モデル向けの指示文に編む、56★)、短編アニメ(企画→キャラ→キーフレーム→動画→MP4、47★)、内蔵動画のプロンプト型(6部構成の指示文→生成→つなぎ→コマ検証)。
- 生成の場所は3択。 Museの内蔵動画(VMの中で完結、ただし地域によって使えない)、クラウドGPU(Colab G4のRTX PRO 6000 96GBにComfyUIを立ててMuseから橋渡し、25★)、自宅GPU((76)のTailscale経由)。
- 内蔵動画には「顔が固定されない」報告。 30秒を3区切りで作ると、区切りごとに別人になった、という否定例がスキルの資料に残っている。長い動画で同じ人物を保つなら、参照画像を渡せる経路(クラウドか自宅のH3)が要る。
- H3側の部品で一番面白いのは、キャラシートを1回の生成で作るノード。 参照8枚(+動画1本)から、H3の参照モードでターンアラウンド動画を1本作り、顔アップ・正面・左右・背面の5コマを抜いて1枚のシートに組む(31★)。当方が(55)でP-H3-Imageを12回回して作ったものを、動画版H3の1回で出す発想。
- 名前の注意。 そのノード群の作者「Muse Collective」はMetaのMuseとは別の団体で、名前が同じだけ。Metaの個人用エージェント「Muse」と、動画スキルの「Muse Video」(スキル名)と、ComfyUIノードの「Muse Collective」が混在しているので、読むときに切り分ける。
- 当方の次の一手は5と(77)型3の検証。 (77)で「キャラ維持は動画版H3が強い」という比較を紹介した。このノードはその型を道具にしたもので、走る女性のキャラシート更新に直接使える。
スキルとは何か
Agent Skillsは、エージェントに手順を教えるための共通の書式。1つのフォルダに SKILL.md(いつ使うか・何をするか)と参考資料を置く。Museに渡すときは「このスキルを使えるようにしてから、サンプルを作って」と言うだけで、Museが読んで手順に従う。同じフォルダがClaude CodeやCodexでも読めるので、企画の手順を1回書けば、指揮役を変えても使い回せる。
段1: 企画をプロンプトに変えるスキル
| 名前 | 星 | 何をするか | 出力の行き先 |
|---|---|---|---|
| muse-video-skill(仮想撮影班) | 56 | 監督・脚本・撮影・美術・特効・音の6役が順に台本・6/9コマの絵コンテ・美術方針を作り、38本の有名事例の技法(“Apple 1984風”のような指定)を引いて、動画モデル向けの6段構成の指示文と参照画像の対応表に編む。各段階で監督役が2回まで差し戻す | Seedance向けに調整済み。他モデルにも流用可 |
| Muse-animated-short-film | 47 | 短編アニメを企画→キャラ→台本→キーフレーム→大きな指示文→動画→MP4まで通す | Muse内蔵動画 |
| muse-video-prompt-skill | 5 | Muse内蔵動画のための6部構成の指示文、生成、区切りのつなぎ、コマを抜いての検証。事例集つき | Muse内蔵動画 |
| awesome-muse-video-prompts-and-skills | 8 | 指示文と実際の出力クリップの対応集、時間的な一貫性の試験、カメラの型 | 参照用 |
共通するのは「Museに作らせる前に、台本と絵コンテを先に固める」こと。当方が(14)でBlenderのプリビズを先に作ったのと同じ考え方で、違いは道具が文章になった点。
段2: 生成をどこでやるか
| 場所 | 仕組み | 強み | 弱み |
|---|---|---|---|
| Muse内蔵動画 | MuseのVMの中で生成 | 設定不要 | 地域によって使えない(403 video_not_available、11月5日時点で継続中の報告)。区切って作ると顔が固定されない |
| クラウドGPU(H3-colab-studio) | Colab G4(RTX PRO 6000・約96GB)にComfyUIを立て、Museやエージェントから橋渡しスキルで投入。複数ショットを同じnoise_seedで出してffmpegでつなぐ | 1本の生成で切れ目のない長回し、透かしなし、96GB | Colabの枠と時間。ComfyUI側に2つの修正が要る(READMEに記載) |
| 自宅GPU((76)) | TailscaleでMuseのVMを自宅の網に入れ、ComfyUIのAPIに投げる | 定額なし、参照画像・LoRAが自由、当方の16GB実測がそのまま使える | 常時起動、Museが自宅に入る側になる設定の手当て |
内蔵動画の「顔が固定されない」は、長い動画を区切って作る以上避けにくい。参照画像を渡せる経路は、クラウドか自宅のH3になる。
段3: H3側の部品
| 名前 | 星 | 何をするか |
|---|---|---|
| Muse-CharacterSheet-H3 | 31 | 参照8枚(+場所1枚、+参照動画1本)を渡し、CHUNK/CUT形式の短い指示でターンアラウンドを書くと、H3の参照モードで1回の生成に編み、多方向の動画を1本出す。別ノードで顔アップ・正面・左プロフィール・右プロフィール・背面の5コマを抜いて1枚のシートに組む(アスペクト比指定で自動配置)。Enhanced版はRef2V Turbo LoRAの8ステップ+Qwen Imageで仕上げ+DLSS拡大 |
| Muse-MiniMax-H3-Unified-Loader | 11 | モデル・CLIP・VAE・LoRA・attentionをハード構成に合わせて1つのノードで読む |
| Muse-Video-Swap-H3 | 1 | 短いクリップの人物と場所を差し替え、カメラと動きは保つ |
| H3 Editor(igorls) | 26 | ComfyUIの中でショットを書いてタイムラインで切る((77)で紹介) |
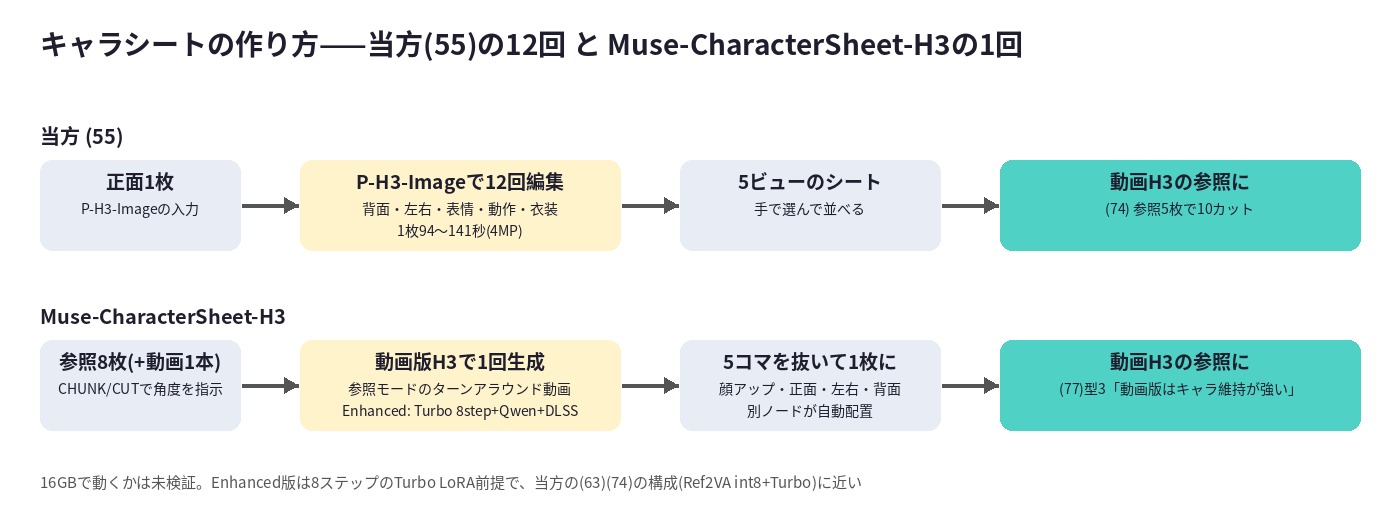
キャラシートのノードは、当方の工程に直接響く。(55)では正面1枚からP-H3-Imageで背面・左右・表情を12回に分けて出し、(74)ではそのシートを参照に動画を作った。このノードは「動画版H3に多方向を1回で演じさせ、コマを抜く」ので、(77)で紹介された「キャラ造形と絵柄の維持は動画版が圧倒的」という比較を道具にした形になる。16GBで動くかは、Enhanced版が8ステップのTurbo LoRA前提なので、(63)(74)で回しているRef2VA int8+Turboの構成と近い。
当方の次の一手
| 工程 | 今 | 試すこと |
|---|---|---|
| キャラシート | P-H3-Imageで12回 | Muse-CharacterSheet-H3で1回。5コマの顔・髪・服の一貫性を(55)と並べる |
| 指揮 | 当方が指示文を書く | 仮想撮影班スキルで台本→指示文を作らせ、走る女性の次の3カットに使えるか |
| 生成の場所 | 自宅16GB×2 | 変えない。MuseからTailscale経由で呼ぶ経路は(76)の注意を満たしてから |
読むときの注意
- 「Muse」が3つ混ざる。Metaの個人用エージェントのMuse、スキル名としてのMuse Video、ComfyUIノードの作者Muse Collective。段3の部品はMetaとは無関係
- GitHubには、Museの実行環境の内部ファイルを転載したと称するリポジトリも出回っている。出所が確認できないので、ここでは扱わない
- 招待コードつきのリポジトリが多い。スキルの中身と招待は別の話として読む
コメント