前回(11)に登場した、装備を着せられていた女性——実は彼女、この記事の主役である新しい生成エンジンから生まれています。今回はその経緯の話です。舞台は前回と同じWindowsのデスクトップ機(RTX 5060 Ti 16GB・ComfyUI)。話題は動画ではなく、すべての上流にある静止画の生成エンジン選びです。
発端——プロンプトを何度直しても、人物に満足できない
動画生成のパイプラインは、元をたどれば1枚の静止画から始まります。人物の元画像を作り、キャラクターシートに起こし、動画の参照に渡す。つまり最初の1枚の質が、その後の全部の上限になります。
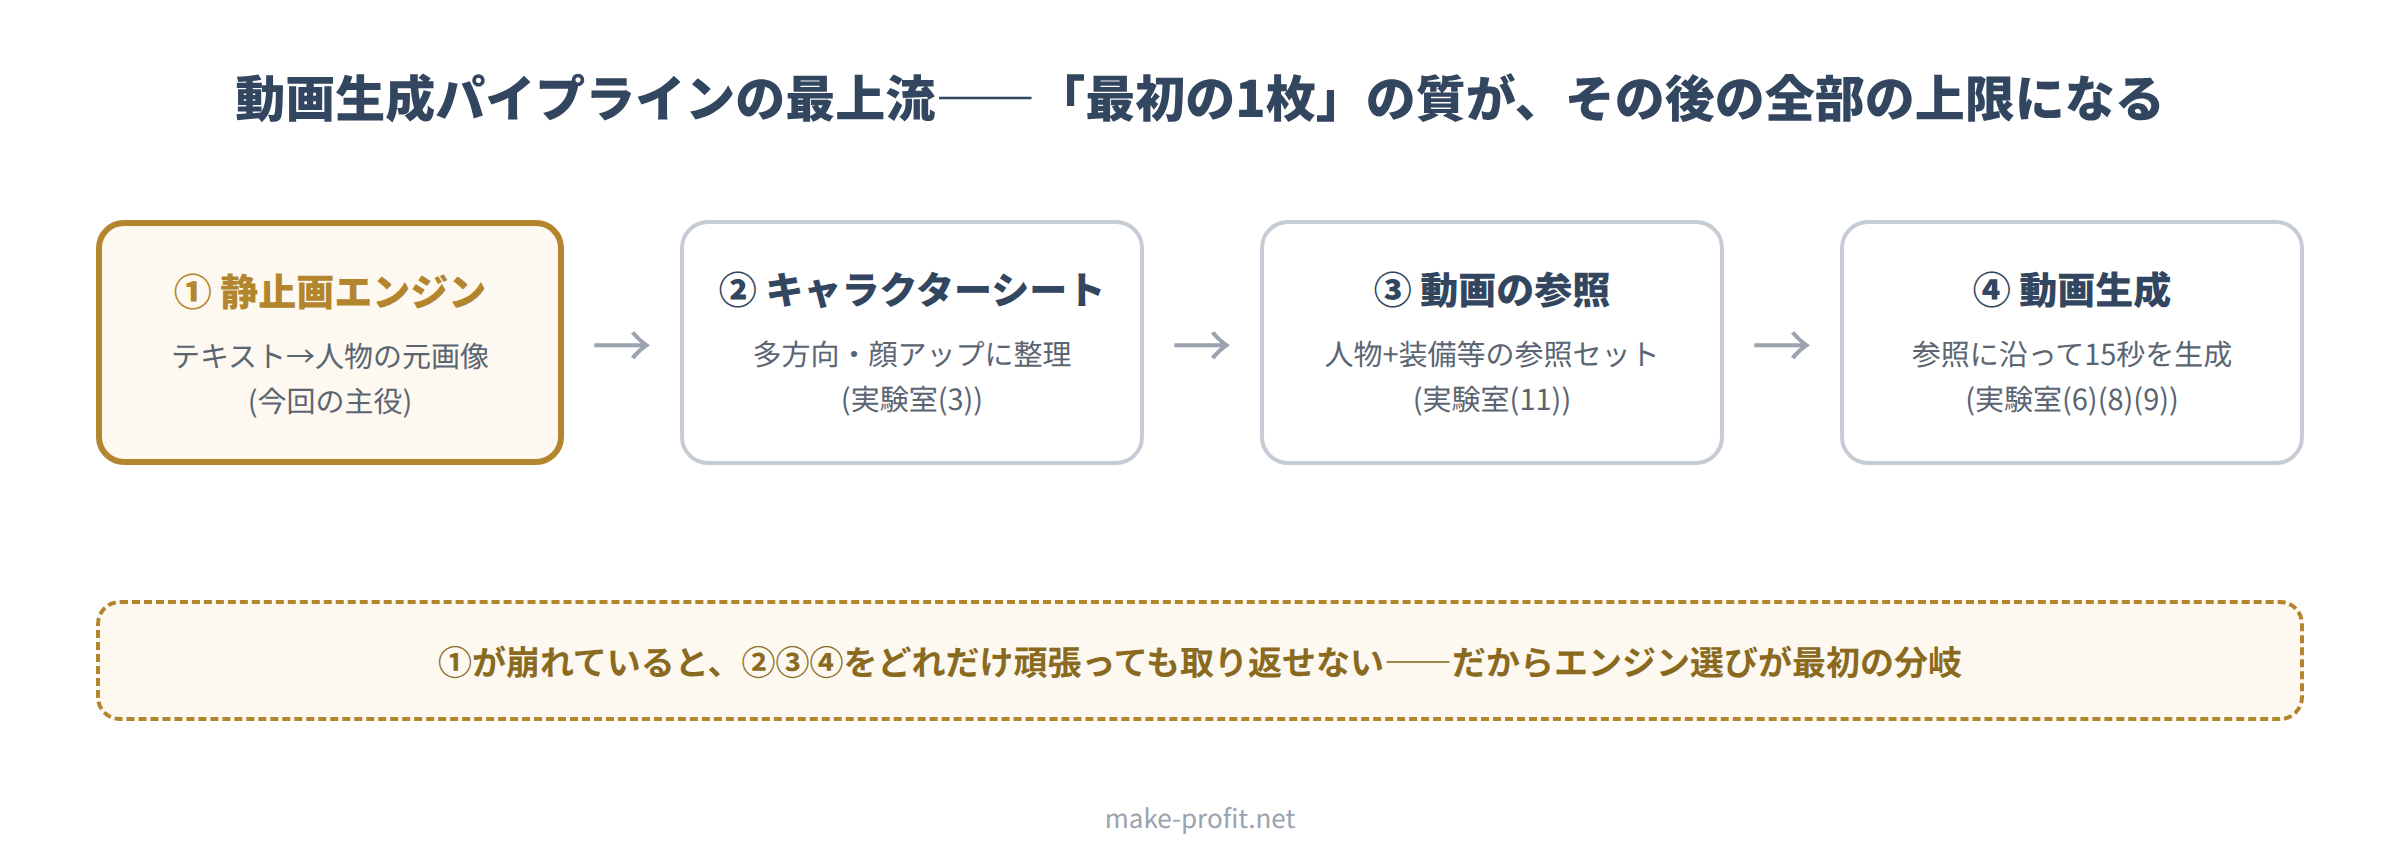
当方のデスクトップ機でテキストから静止画を作れるモデルは、長らくSDXLのbaseモデル(2023年公開の素の重み)だけでした。そして率直に言って、人物に満足できていませんでした。プロンプトを直しても直しても、どこか惜しい。この「プロンプトをいじり続ける」状態、前回の装備破綻のときと同じ袋小路です(比喩はここで使い切ります——原因は言葉ではなく、土台の方にありました)。
回り道——「動画用の高解像度化モデル」では静止画は作れない
先に、やらかした話をひとつ。手元には動画の高解像度化に使っているモデル(SeedVR2)があり、「これで静止画も綺麗に作れないか」とローダーを差し替えて実行したところ、こういうエラーで止まりました。
SeedVR2 requires conditioning latents from the SeedVR2Conditioning node.
これは接続ミスではありません。SeedVR2は「元になる映像」を入力に取って復元・高解像度化するモデルで、テキストから何かを生み出すモデルではないのです。生成AIのモデルには「ゼロから作る生成モデル」と「入力を磨く復元モデル」があり、名前や見た目のワークフローが似ていても役割がまったく違う——分かってしまえば当たり前ですが、モデルが増えてくると実際に混同します。同じ勘違いをする人は多いはずなので、エラー文ごと残しておきます。
導入——Z-Image Turbo(公式配布の軽量版)
そこで、テキストから静止画を作る専用の新エンジンとしてZ-Image Turboを導入しました。ComfyUI公式配布の構成(int8量子化版)をそのまま使っています。
| 構成要素 | ファイル | サイズ |
|---|---|---|
| 生成本体 | z_image_turbo_int8_convrot | 6.20 GB |
| テキスト理解 | qwen_3_4b_fp8_mixed | 5.63 GB |
| VAE | ae | 0.34 GB |
ポイントは2つ。8ステップ・CFG 1で回す高速設計(ネガティブプロンプトは使わない)であること、そして合計12GB程度なので16GBのVRAMに収まること。ミドル級GPUの静止画エンジンとして現実的なサイズです。
比較——同一プロンプト・各4枚
条件をそろえて比べました。プロンプトは同一(ベージュのビジネススーツの20代日本人女性・正面・全身・カメラ目線)、各モデルの推奨設定で4枚ずつ生成です。
| 項目 | SDXL base | Z-Image Turbo |
|---|---|---|
| 設定 | 25 steps / CFG 7 | 8 steps / CFG 1 |
| 解像度(3:4・1.0MP) | 888×1184 | 896×1152 |
| 4枚の生成時間 | 47.5秒 | 26.7秒 |
| 全身指定の再現 | 4枚中3枚が膝上で切れる | 4枚とも全身 |
| 服装指定の再現 | 指定にないネクタイが出現 | ジャケット・スカート・パンプスまで指示通り |
| 顔 | 1枚ごとに顔立ち・年齢感がばらつく | 整っていて安定 |
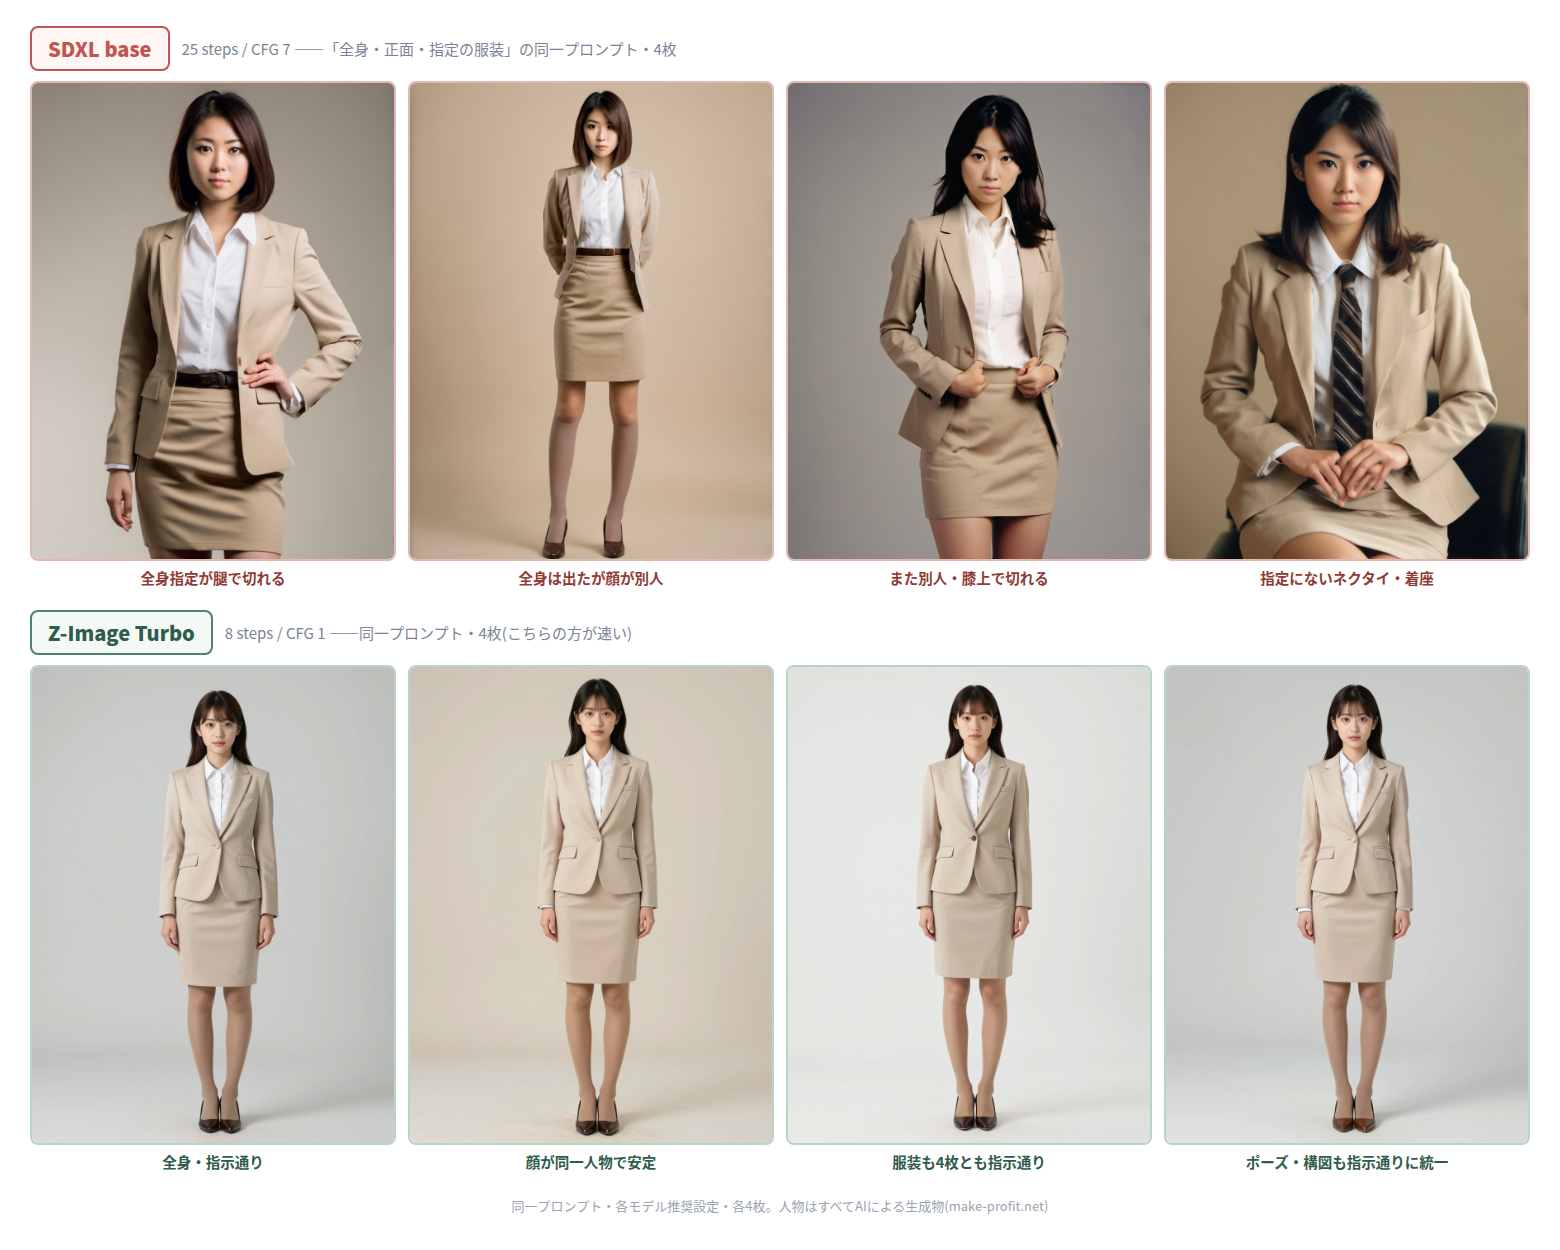
結果は見ての通りです。速い方が、きれいで、指示に従う。 運営者の評価をそのまま書けば「Z-Image Turboなら美人が出る。SDXL baseでは出ない」(主観です。ただし全身・服装の再現性は上の表の通り客観でも差が出ています)。
なお、Z-Imageの4枚は構図・ポーズまでほぼ同一ですが、これは「立ち姿の全身・正面・カメラ目線」という指示に4枚とも忠実だからです。ばらつかないことは欠点ではなく、キャラクターシートの元画像づくりのように再現性が要る用途では、そのまま長所になります。構図を変えたいときは乱数任せにせず、プロンプトで指定すればいい——指示が効くエンジンだからこそ成り立つ使い方です。
正直な注意書き——この比較が言えること、言えないこと
この比較から言えるのは「2023年の素のSDXL baseと、公式配布のZ-Image Turboを、それぞれの推奨設定で使うと、人物はZ-Imageが圧倒的」ということまでです。言えないことも書いておきます。第一に、SDXLには実写系にファインチューンされた派生モデルが無数にあり、それらとは比べていません。「SDXL系全般より上」ではない。第二に、step数・CFG・乱数・解像度はモデルごとの推奨に合わせたので、厳密な同条件比較ではありません。第三に、1プロンプト・各4枚の観察です。
それでも当方がZ-Imageを採用した理由は単純で、「プロンプトのせいかもしれない」という疑いを一つ消せたからです。土台を替えただけで結果が別物になった以上、これまでプロンプトに向けていた労力の何割かは、土台に向けるべきだった。前回の「プロンプトを疑う前に、配線を疑え」に続けるなら、今回は「プロンプトを疑う前に、エンジンを疑え」です。
まとめ
要点は3つです。第一に、静止画の品質問題は、プロンプトより先にエンジンを疑う。同一プロンプトでモデルだけ替える比較は30分でできて、数日分のプロンプト調整より多くを教えてくれます。第二に、モデルには「生成」と「復元」の別がある。動画の高解像度化モデルでは静止画は作れない——エラーで学びました。第三に、指示に忠実なエンジンは、ばらつきを乱数に頼らない。4枚が揃うのは指示通りの証であり、構図を変えたければプロンプトで指定すればいい。再現性が要る用途では、この従順さがそのまま資産になります。
パイプラインの上流がこれで固まりました。次はこのエンジンで作った人物を、二台体制(試行はこのデスクトップ、清書はMac)でどう動画まで運ぶか——使い分けの実績が貯まったら、それも書きます。
本記事の内容は2026年10月の当方検証(RTX 5060 Ti 16GB・ComfyUI 0.36.0)に基づきます。登場する人物の画像はすべてAIによる生成物であり、実在の人物とは関係ありません。
コメント