11月15日に出た4件を、当方の16GB運用に関係する順にまとめる。いずれも当方は未検証で、一次情報(公開リポジトリとコミット)を読んだ範囲。
先に要点
- 高速化LoRAの比較記録(GitHub grawwww-studio/comfyui-minimax-h3-speedups): RTX 4090、Ref2VA 1344×768・141フレーム(5.9秒)で、基準の20ステップ600秒に対し、LightX2V 8ステップ267秒(2.2倍)、Pika H3 Flex 6ステップ208秒(2.9倍)、LightX2V 4ステップ147秒(4.1倍)、HyperFlow H3 Flash 6ステップ194秒(約3倍)。
- 速いほど顔が崩れるわけではないが、4ステップとPikaは引きの構図で不合格。8ステップとHyperFlowは引き・寄りの両方で合格。寄りの構図では4通りすべて合格。
- 判定規則を測る前に凍結している。顔の類似度(AuraFace)で、基準の3seed平均−0.028を合格線、各構図3seedのうち2つ以上で合格。基準自身のseed差が合格線の幅と同程度なので、1seedの差で優劣を言わない、と自分で縛っている。当方が実測記事で守ってきた「規則を先に決めて測る」型と同じ。
- ComfyUI本体に Video Deflicker ノード(#17754、11月15日、kijai氏)。RAFTのオプティカルフローを使ったちらつき抑制で、RAFTの実装も速くなった。同日に PAN2 という画像モデルの対応(#17755)も入り、タグは v0.45.4。
- H3 GGUFの一式(HF yasutoshi-lab/MiniMax-H3-GGUF): TE・DiT(fl2va と ref2va)・動画VAE・音声VAEまで量子化。DiT IQ3_XXS 15.2GB+TE IQ3_XXS 10.2GB+動画VAE Q4_0 1.7GB=合計27.4GB、IQ2_XS なら 23.3GB。SHA256と公式のプロンプトガイドを同梱。
- H3-Image用のTAE(HF Kijai/MiniMax-H3-TAE に taeh3_image.safetensors、11月15日): 生成途中のプレビュー用の軽量デコーダ。
高速化LoRAの比較記録を読む
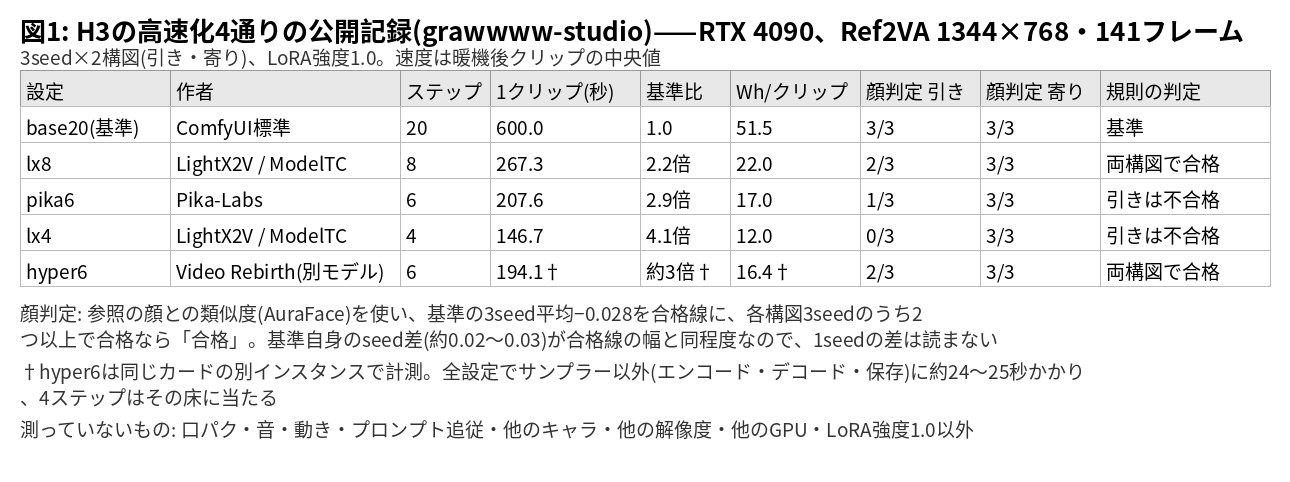
読み方で当方が良いと思った点は3つ。
- 合格線を先に凍結している。RULE.md を測る前に固定し、後から変えた箇所は別ファイルに書いている。
- 基準のばらつきと合格線の幅を並べている。基準の3seedの平均が0.558〜0.586で、合格線の余裕0.028と同程度。だから「1seedが線を下回った」を性能差と読まない、と明記している。
- 測っていないものを列挙している。口パク、音、動き、プロンプト追従、他のキャラ、他の解像度、他のGPU、LoRA強度1.0以外。
数字の方は、サンプラー以外(テキストと参照のエンコード、デコード、保存)が全設定で約24〜25秒かかるので、4ステップはその床に当たって「4.1倍」で止まる、という指摘が実務的。基準はint8のRef2VA本体とNVFP4のテキストエンコーダで、GPU全体のピークVRAMは約23GB。当方の16GB機にそのまま持ち込める構成ではない。当方が試すなら、GGUFの本体に各LoRAを当てた時の速度と顔の判定の下がり方を、同じ規則で測ることになる。
HyperFlow H3 Flash はLoRAではなく別の軽量モデルで、専用のローダーが要る。MiniMaxの公式ではない、とリポジトリも明記している。
ComfyUI本体: Video Deflicker
11月15日のコミット #17754 で comfy_extras/nodes_video_deflicker.py が入った。RAFTでフレーム間のオプティカルフローを取り、隣接フレームを位置合わせしてから明るさの揺れを抑える仕組み(ソースの範囲で読んだ限り。多重格子のポアソン方程式で解いている)。RAFTの入力は768×768までに制限され、「それ以上は時間がかかるだけで結果は良くならなかった」とコメントにある。
当方の走る女性シリーズは22カットをつないでいて、カットの境界やH3の出力そのものに明るさの揺れがある。デスクトップの ComfyUI は 0.45.0 なので、更新してから全体動画に当ててみる候補。
同日の #17755 は PAN2 という画像モデルの対応で、テキストエンコーダはHunyuan系を流用している。モデルの素性はコードからは分からないので、ここでは名前だけ。
H3 GGUFの一式と、H3-ImageのTAE
yasutoshi-labのGGUFは、これまで当方が使ってきた「DiTとTEだけ量子化、VAEはfp16」に対して、動画VAE(10.4GB→Q4_0で1.7GB)と音声VAE(0.6GB→F16で0.3GB)まで削っている。合計で23〜27GBまで減るが、16GBのVRAMに全部は載らないので、オフロードの前提は変わらない。VAEの量子化が出力に与える影響は、当方で比べていない。
Kijai氏のTAEは、H3-Imageの生成途中を軽く復号してプレビューするためのもの。16GB機でH3-Imageを回すとき、本VAEの復号を待たずに途中経過を見られる。
書いていないこと
- 4件とも当方は未検証。速度・顔判定・容量の数字はすべて公開元の記載の転記。
- 高速化LoRAの比較は1枚のRTX 4090・1キャラ・2構図・3seedの記録で、他の環境に一般化しない(公開元もそう書いている)。
出典
- GitHub grawwww-studio/comfyui-minimax-h3-speedups(2026年11月15日公開、MIT)。README、RULE.md、results.json
- GitHub comfyanonymous/ComfyUI: #17754(Video Deflicker node and Faster RAFT)、#17755(Support PAN2)、タグ v0.45.4
- Hugging Face yasutoshi-lab/MiniMax-H3-GGUF(2026年11月15日作成)、Kijai/MiniMax-H3-TAE(taeh3_image.safetensors 11月15日追加)
コメント