第12回で、同じプロンプトでエンジンだけ替えたら人物が別物になった、と書きました。あれから使い分けの実感が貯まったので、続報です。
結論から。景色でも、Z-Image Turboの方が「写真」を守ります。 そして人物は、一度SDXLに戻してみて、やはりZ-Imageに決めました。
発端: 久しぶりにSDXLで描いたら、別人が出た
デスクトップ機で、第7回のキャラクターシートの元になった女性を、当時のプロンプトのまま久しぶりに描かせました。出てきたのは、同じ服・同じ構図の、美しくない別人でした。
原因はプロンプトではなく、エンジンでした。元画像はMacでStable Diffusionで描いたつもりでいたのですが、記録をたどるとZ-Imageで描いていた。デスクトップ機をZ-Imageに切り替えたら、元画像に近い顔が戻ってきました。第12回で「プロンプトを疑う前に、エンジンを疑え」と書いた本人が、同じ罠にもう一度はまった形です。
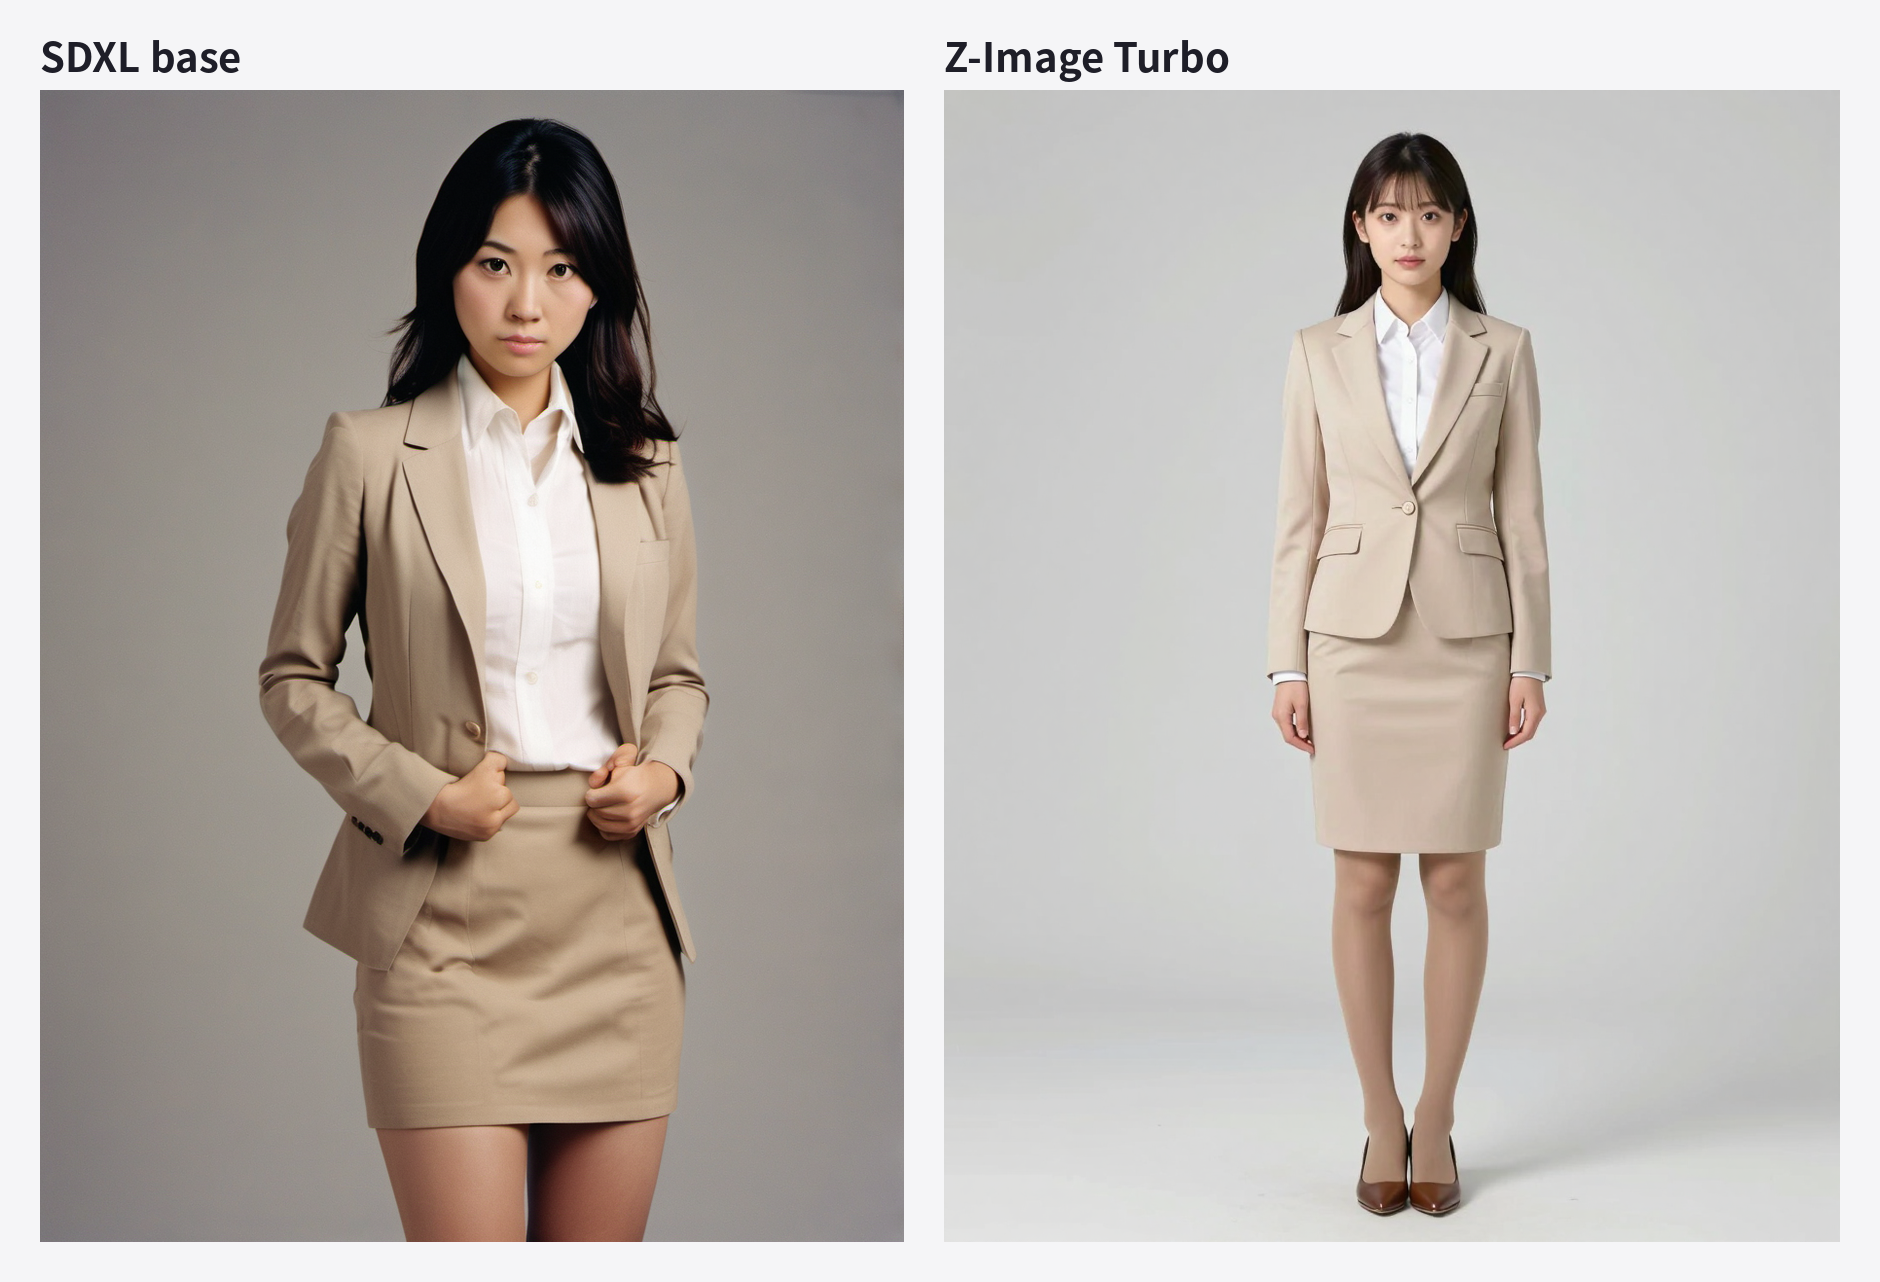
同じプロンプト(第12回と同じ、ベージュのビジネススーツの20代の女性・正面・全身)。左がSDXL base(25ステップ・CFG 7)、右がZ-Image Turbo(8ステップ・CFG 1)。左はこの回も「全身」が膝で切れ、表情が硬い。
プロンプトは第12回と同じで、英語原文はこれです。
A young Japanese woman in her twenties facing forward and looking directly into the lens. She is dressed in a beige business suit—comprising a blazer and a tight skirt—worn with a white shirt, beige stockings, and brown pumps. Full-body shot.
ここで一つ、仮説が浮かびました。人物はZ-Image、景色はStable Diffusion、と得意分野で使い分けたらどうか。 背景(街・部屋・風景)はSD系、キャラクターはZ-Imageで出して、動画の参照に渡すときに合わせる。これを確かめるために、景色でも同じ比較をしました。
景色: 同じプロンプトで、戦後の街並み
プロンプトは1本に固定しました(英語原文)。
A realistic photograph. An old European townscape, with some areas left in ruins—as if in the aftermath of war. A straight, cobblestone street stretches out ahead, with piles of rubble scattered here and there. Further along, a roof lies partially damaged. Lining both sides of the street are tall, stone-built structures, three to four stories high, weathered by the elements.
設定は各モデルの推奨どおりで、プロンプトと解像度だけを揃えています。
| Z-Image Turbo | SDXL base | |
|---|---|---|
| 解像度 | 1360×768 | 1368×768 |
| ステップ / CFG | 8 / 1.0 | 25 / 7.0 |
| サンプラー | res_multistep / simple | dpmpp_2m / karras |
| ネガティブ | 使わない(非対応) | 空 |
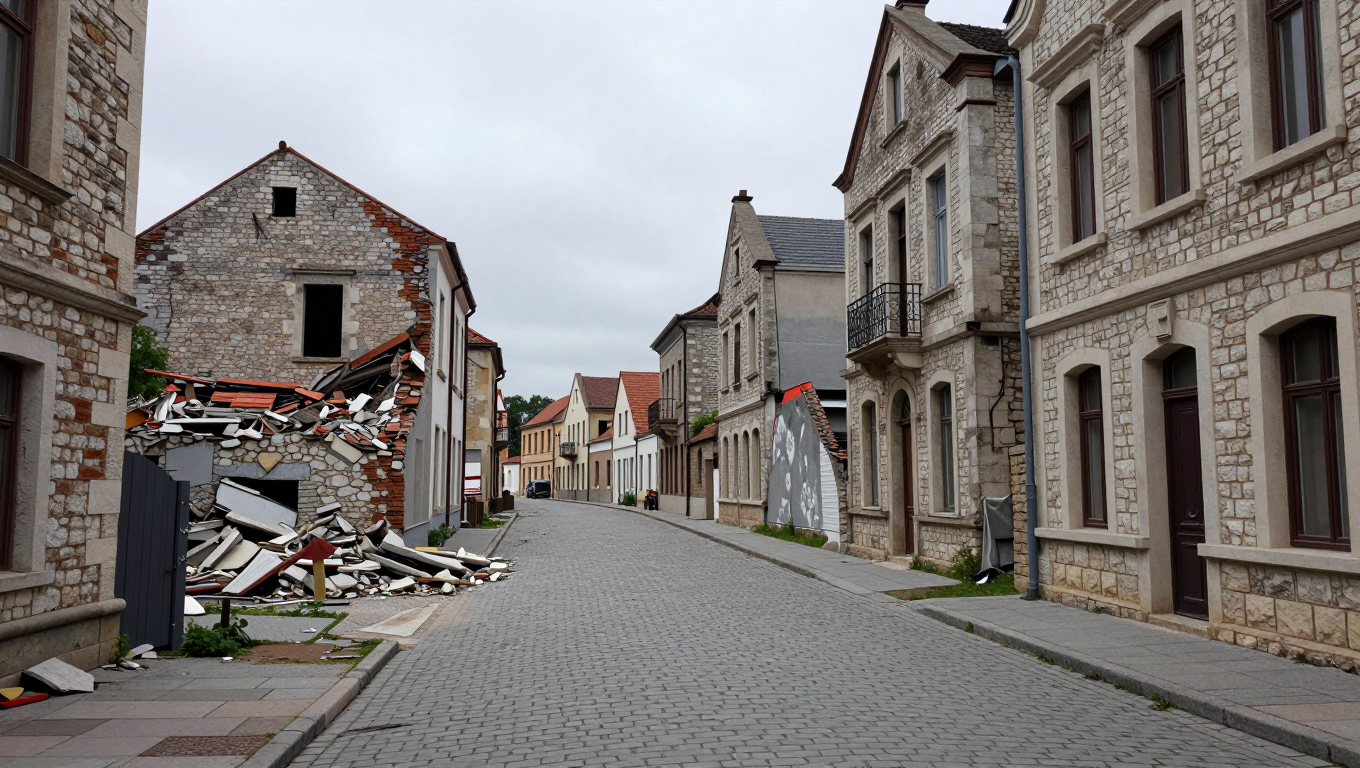
Z-Image Turbo。
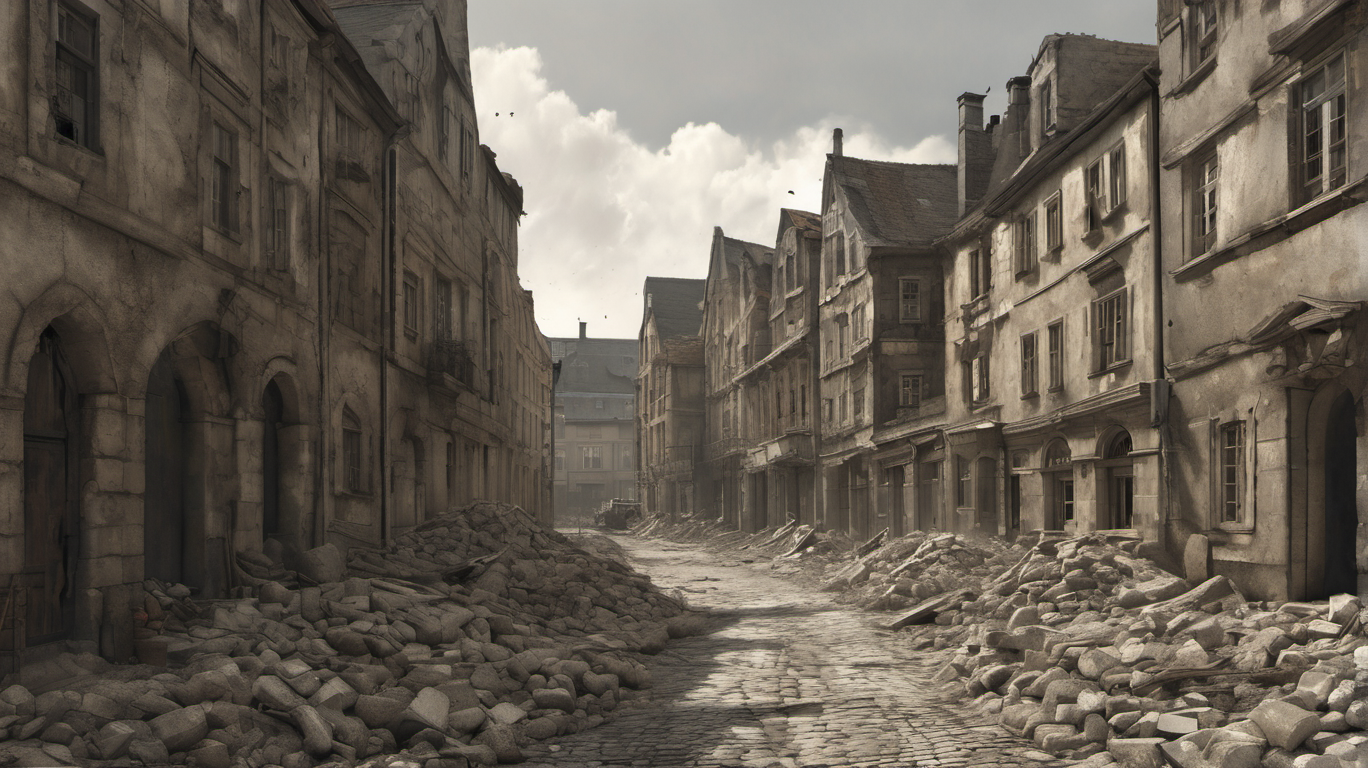
SDXL base。
Z-Imageは、補修前の実在の街の写真に見えます。石畳の目地、石壁の積み方、窓枠の彫り。崩れは左の1棟に集中していて、瓦礫は建材の山。右側の建物は無傷なので、「戦後」というより「解体工事中」に見えるのが惜しいところですが、「realistic photograph」という指示は守っています。
SDXL baseは、セピア調のコンセプトアートです。瓦礫が通り全体に広がり、「戦後の街」の空気はむしろこちらの方が強い。ただし写真ではない。窓とアーチは歪み、近景の石は丸い塗りになっています。
景色でも、プロンプトを守るのはZ-Imageでした。 「景色はSD」の仮説は、この2枚では支持できません。ただしこれは2023年の素のSDXL baseの話で、実写系にファインチューンされた派生モデル(Juggernaut系など)やrefinerを足せば、まだ逆転の余地はあります。そこは次の宿題です。
ネットでは、どう言われているか
当方の実感が偏っていないか、公開されている比較を当たりました。
- 「人物・肌はZ-Imageが強い」は多数派です。 公式は写実品質と美的品質の両立を掲げ、比較記事ではブラインド比較でZ-ImageのポートレートがFLUXより高評価、理由は肌の質感・照明の安定・手の破綻の少なさ。Flux 2との比較では、アジア系の顔で差が最大という結果もあります。
- 反対意見もあります。 「近くで見るとSDXLの方が肌と照明が上」「ポートレートはFlux 2が上でZ-Imageは下書き向き」とする記事もある。満場一致ではない。
- Z-Imageの弱点として挙がるもの。 公式の表で、Turbo版は画質「Very High」だが多様性「Low」。第12回で当方が見た「4枚とも同じ構図」はこれです。ほかにLoRAの蓄積がSDXLより少ない、長い文字列が苦手、ネガティブプロンプト非対応。
- 「景色はSDが得意」と明言する記事は見つかりませんでした。 SDXLの強みとして挙がるのは、LoRA・ControlNet・IPAdapterの蓄積、つまり構図を狙って作る道具立ての成熟です。当方が「SDは景色」と感じていたのは、たぶんこちらの効果でした。
人物を写実に出すコツとして複数の記事が挙げていたのが、「85mm portrait lens, shallow depth of field」のような撮影用語を入れること。抽象的な美辞より効くそうです。次に人物を描くときに試します。
当方の使い分け(今の結論)
- 人物(キャラクターシートの元画像)は、Z-Image。 デスクトップ機でもMacでも。
- 景色も、今のところZ-Image。 SD系に戻すなら、素のbaseではなく実写系の派生モデルで試してから。
- SD系が要るのは、構図を縛るとき。 ControlNet(深度・線画・姿勢)で位置関係を渡す仕事は、道具が揃っているSDXLに分がある。これは次の実験で確かめます。
まとめ
- 同じプロンプトでも、景色でZ-Imageは「写真」、SDXL baseは「コンセプトアート」になった。プロンプト遵守はZ-Image。
- 人物は一度SDXLに戻して別人が出たので、Z-Imageに決めた。元画像のエンジンは記録しておくこと。
- 「人物はZ-Image」はネットでも多数派だが反対意見もある。「景色はSD」の裏付けは見つからなかった。
- Z-Imageの弱点は多様性の低さ。SDXLの強みは道具立て(LoRA・ControlNet)の蓄積。
本記事の画像は2026年10月17〜18日の当方環境(Windows 11・RTX 5060 Ti 16GB×2・ComfyUI)で生成したものです。人物はAI生成です。
コメント