(108)で「基盤の重みは8月5日から変わっていない。増えているのは周辺」と書いた。その翌日の11月19日に、基盤そのものを削って小さくするプロジェクトが公開された。GitHubのREADMEとHugging Faceの配布から整理する。当方未検証。
目次
先に要点
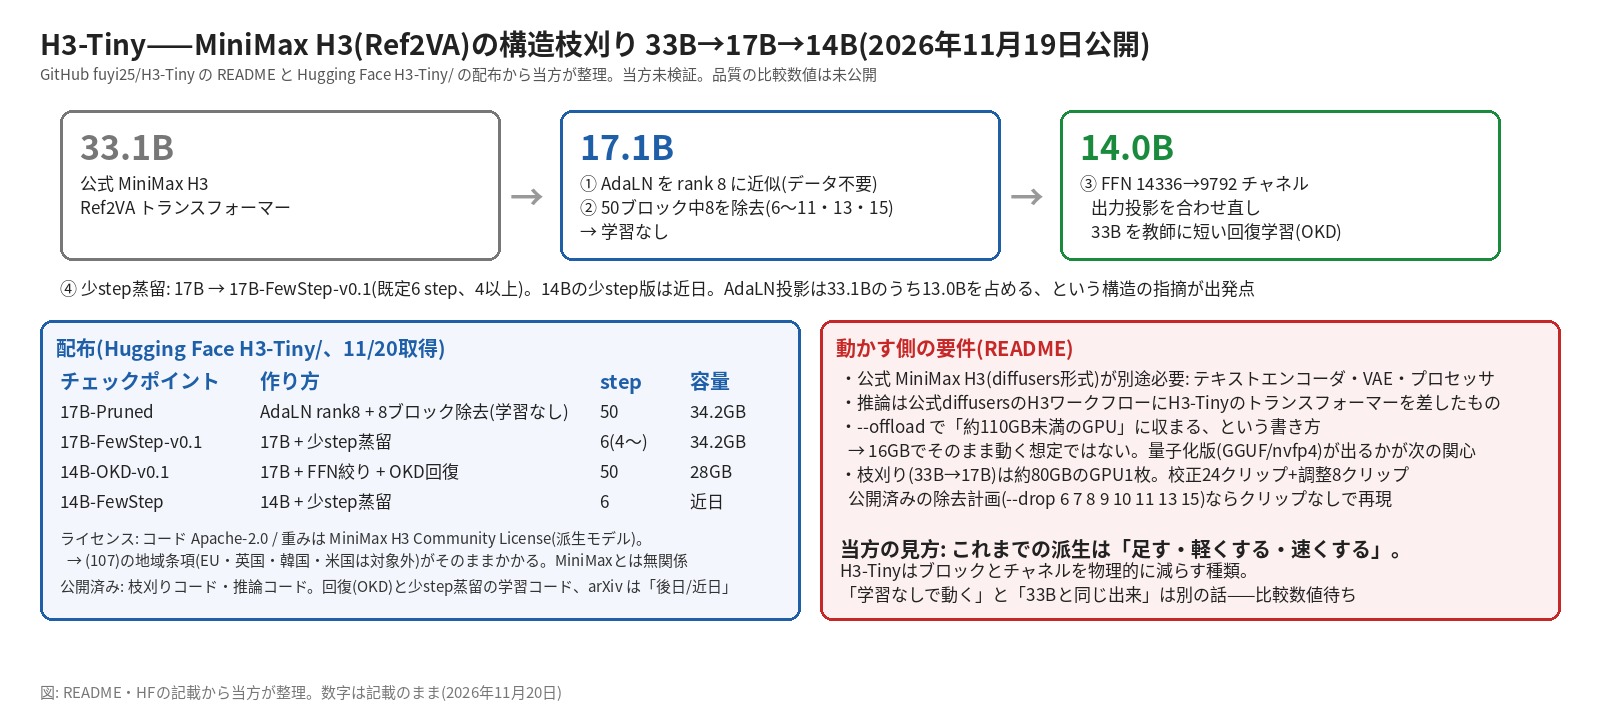
- 何をしたか: MiniMax H3のRef2VA(参照画像→動画+音声)側のトランスフォーマー33.1Bを、構造枝刈りで17.1Bと14.0Bに。作者はfuyi25、コードはApache-2.0、重みはMiniMax H3 Community License(派生モデル扱い。地域条項も引き継ぐ、(107)参照)。MiniMaxとは無関係の独立プロジェクトと明記。
- 17Bは「学習なし」で動く(README)。手順は2つ。①各ブロックのAdaLN投影(33.1Bのうち13.0Bを占める)は入力が時刻の固定関数なので、データなしでrank 8に近似。②各ブロックが動画・音声トークンをどれだけ変えるかを測り、音声が頼るブロックを守って50ブロック中8(6〜11・13・15)を除去。
- 14Bは絞って蒸留で回復。FFNを14336→9792チャネルに絞り、出力投影を合わせ直し、33Bを教師にした短い回復学習(OKD)。
- 少step版: 17Bに少step蒸留をかけた
17B-FewStep-v0.1(既定6step、4以上)。14Bの少step版は「近日」。 - 配布と要件: Hugging Face
H3-Tiny/に3本(17B-Pruned 34.2GB、17B-FewStep 34.2GB、14B-OKD 28GB)。推論には公式H3のエンコーダ・VAE・プロセッサが別途必要。--offloadで「約110GB未満のGPU」に入る、という書き方なので、16GBでそのまま動く想定ではない。枝刈り(33B→17B)は約80GBのGPU1枚、校正24クリップ+調整8クリップ。 - 公開されているもの: 枝刈りコードと推論コード。回復(OKD)と少step蒸留の学習コードは「後日」。arXivも「近日」。
手順(READMEの「Method」から)
| 段階 | 何をするか | 結果 |
|---|---|---|
| ① AdaLN低ランク | 各ブロックのAdaLN投影(33.1B中13.0B)の入力は時刻の固定関数。その入力に対してrank 8の近似を直接当てる。データ不要 | パラメータの大半を削る |
| ② ブロック除去 | 各ブロックが動画・音声トークンをどれだけ変えるかを測る。音声が最も依存するブロックは守る。50ブロック中8(6〜11、13、15)を除去 | 17.1B(学習なし) |
| ③ FFN絞り込み | 各FFNを14336→9792チャネルに。出力投影を合わせ直し、33Bを教師に短い回復学習(OKD) | 14.0B |
| ④ 少step蒸留 | 17Bに適用。既定6step(4以上) | 17B-FewStep-v0.1 |
READMEの図は「ブロックごとの動画・音声トークンへの影響」を示し、除去した8ブロックに印がある。音声側の依存が大きいブロックを残す判断は、H3が動画と音声を1つのトランスフォーマーで同時に出す構造((108)参照)だから必要になる。
配布(Hugging Face、11月20日取得)
| チェックポイント | パラメータ | 作り方 | サンプリング | 容量 |
|---|---|---|---|---|
| H3-Tiny-17B-Pruned | 17.1B | AdaLN rank 8 + 8ブロック除去、学習なし | 50 step | 34.2GB |
| H3-Tiny-17B-FewStep-v0.1 | 17.1B | 17B + 少step蒸留 | 6 step既定(4以上) | 34.2GB |
| H3-Tiny-14B-OKD-v0.1 | 14.0B | 17B + FFN絞り + OKD回復 | 50 step | 28GB |
| H3-Tiny-14B-FewStep | 14.0B | 14B + 少step蒸留 | 6 step既定 | 近日 |
いずれも11月19日公開、ダウンロード数はまだほぼ0。
動かす側の要件(READMEから)
pip install -e .(torch≥2.6、diffusers≥0.42 ほか)。公式MiniMax H3のdiffusers形式のチェックポイントがテキストエンコーダ・VAE・プロセッサのために必要(自分で枝刈りするなら33Bのトランスフォーマーも)。- 推論スクリプトは公式diffusersのH3ワークフローにH3-Tinyのトランスフォーマーとstepスケジュールを差したもの。
--offloadで「約110GB未満のGPUに収まる」。FlashAttention-3はHopper、ほかはSDPA。 - 枝刈り: 校正クリップ(音声つきの正解動画が要る)を公式ref2vaワークフローで符号化し、ノイズ除去ループを「トランスフォーマー入力と正解の潜在を保存する」工程に置き換える。33B→17Bは約80GBのGPU1枚。公開済みの除去計画(
--drop 6 7 8 9 10 11 13 15)を使えばクリップなしで再現できる。
当方の見方
- (108)の「周辺」に、基盤を削る種類が加わった。これまでの派生は「LoRAを足す」「量子化で軽くする」「少stepで速くする」だったが、H3-Tinyはブロックとチャネルを物理的に減らす。17Bが学習なしで動くという主張は、AdaLNが13.0Bも占めていたという構造の指摘と合わせて読むと筋が通る。
- 16GBの当方にはまだ遠い。17Bのbf16で34.2GB、推論の記述は「110GB未満はoffload」。(108)の量子化勢(GGUF・nvfp4)がH3-Tinyに乗ると、16GBで「H3の半分」が動く可能性がある。ここが次の関心。
- 品質は見ていない。READMEのサンプルは作者の提示。33Bとの比較数値もまだない(arXiv近日)。「学習なしで動く」と「33Bと同じ出来」は別の話。
- ライセンスは本家と同じ。重みはH3のCommunity Licenseの派生モデルで、(107)で書いた地域条項(EU・英国・韓国・米国は対象外)がそのままかかる。READMEもそう書いている。
書いていないこと・確かめていないこと
- 当方では動かしていない。生成物も見ていない。
- 33Bとの品質比較の数値は公開されていない(11月20日時点)。
- 16GB級での動作は、量子化版が出るまで不明。
出典
- GitHub: fuyi25/H3-Tiny(README「News」「Checkpoints」「Method」「Inference」「Pruning」「License」、2026年11月19日公開)
- Hugging Face: H3-Tiny/H3-Tiny-17B-Pruned、H3-Tiny-17B-FewStep-v0.1、H3-Tiny-14B-OKD-v0.1(容量はAPIのファイルサイズ合計、11月20日取得)
- 当方の取得(2026年11月20日 04:30 JST)
コメント