前回の記事のあと、Xに彼女が歩く動画を載せました。キャラクターシートから動画へ——工程はつながりました。ところが、ここで別の問題が待っていました。1本焼くのに87分かかるのです。
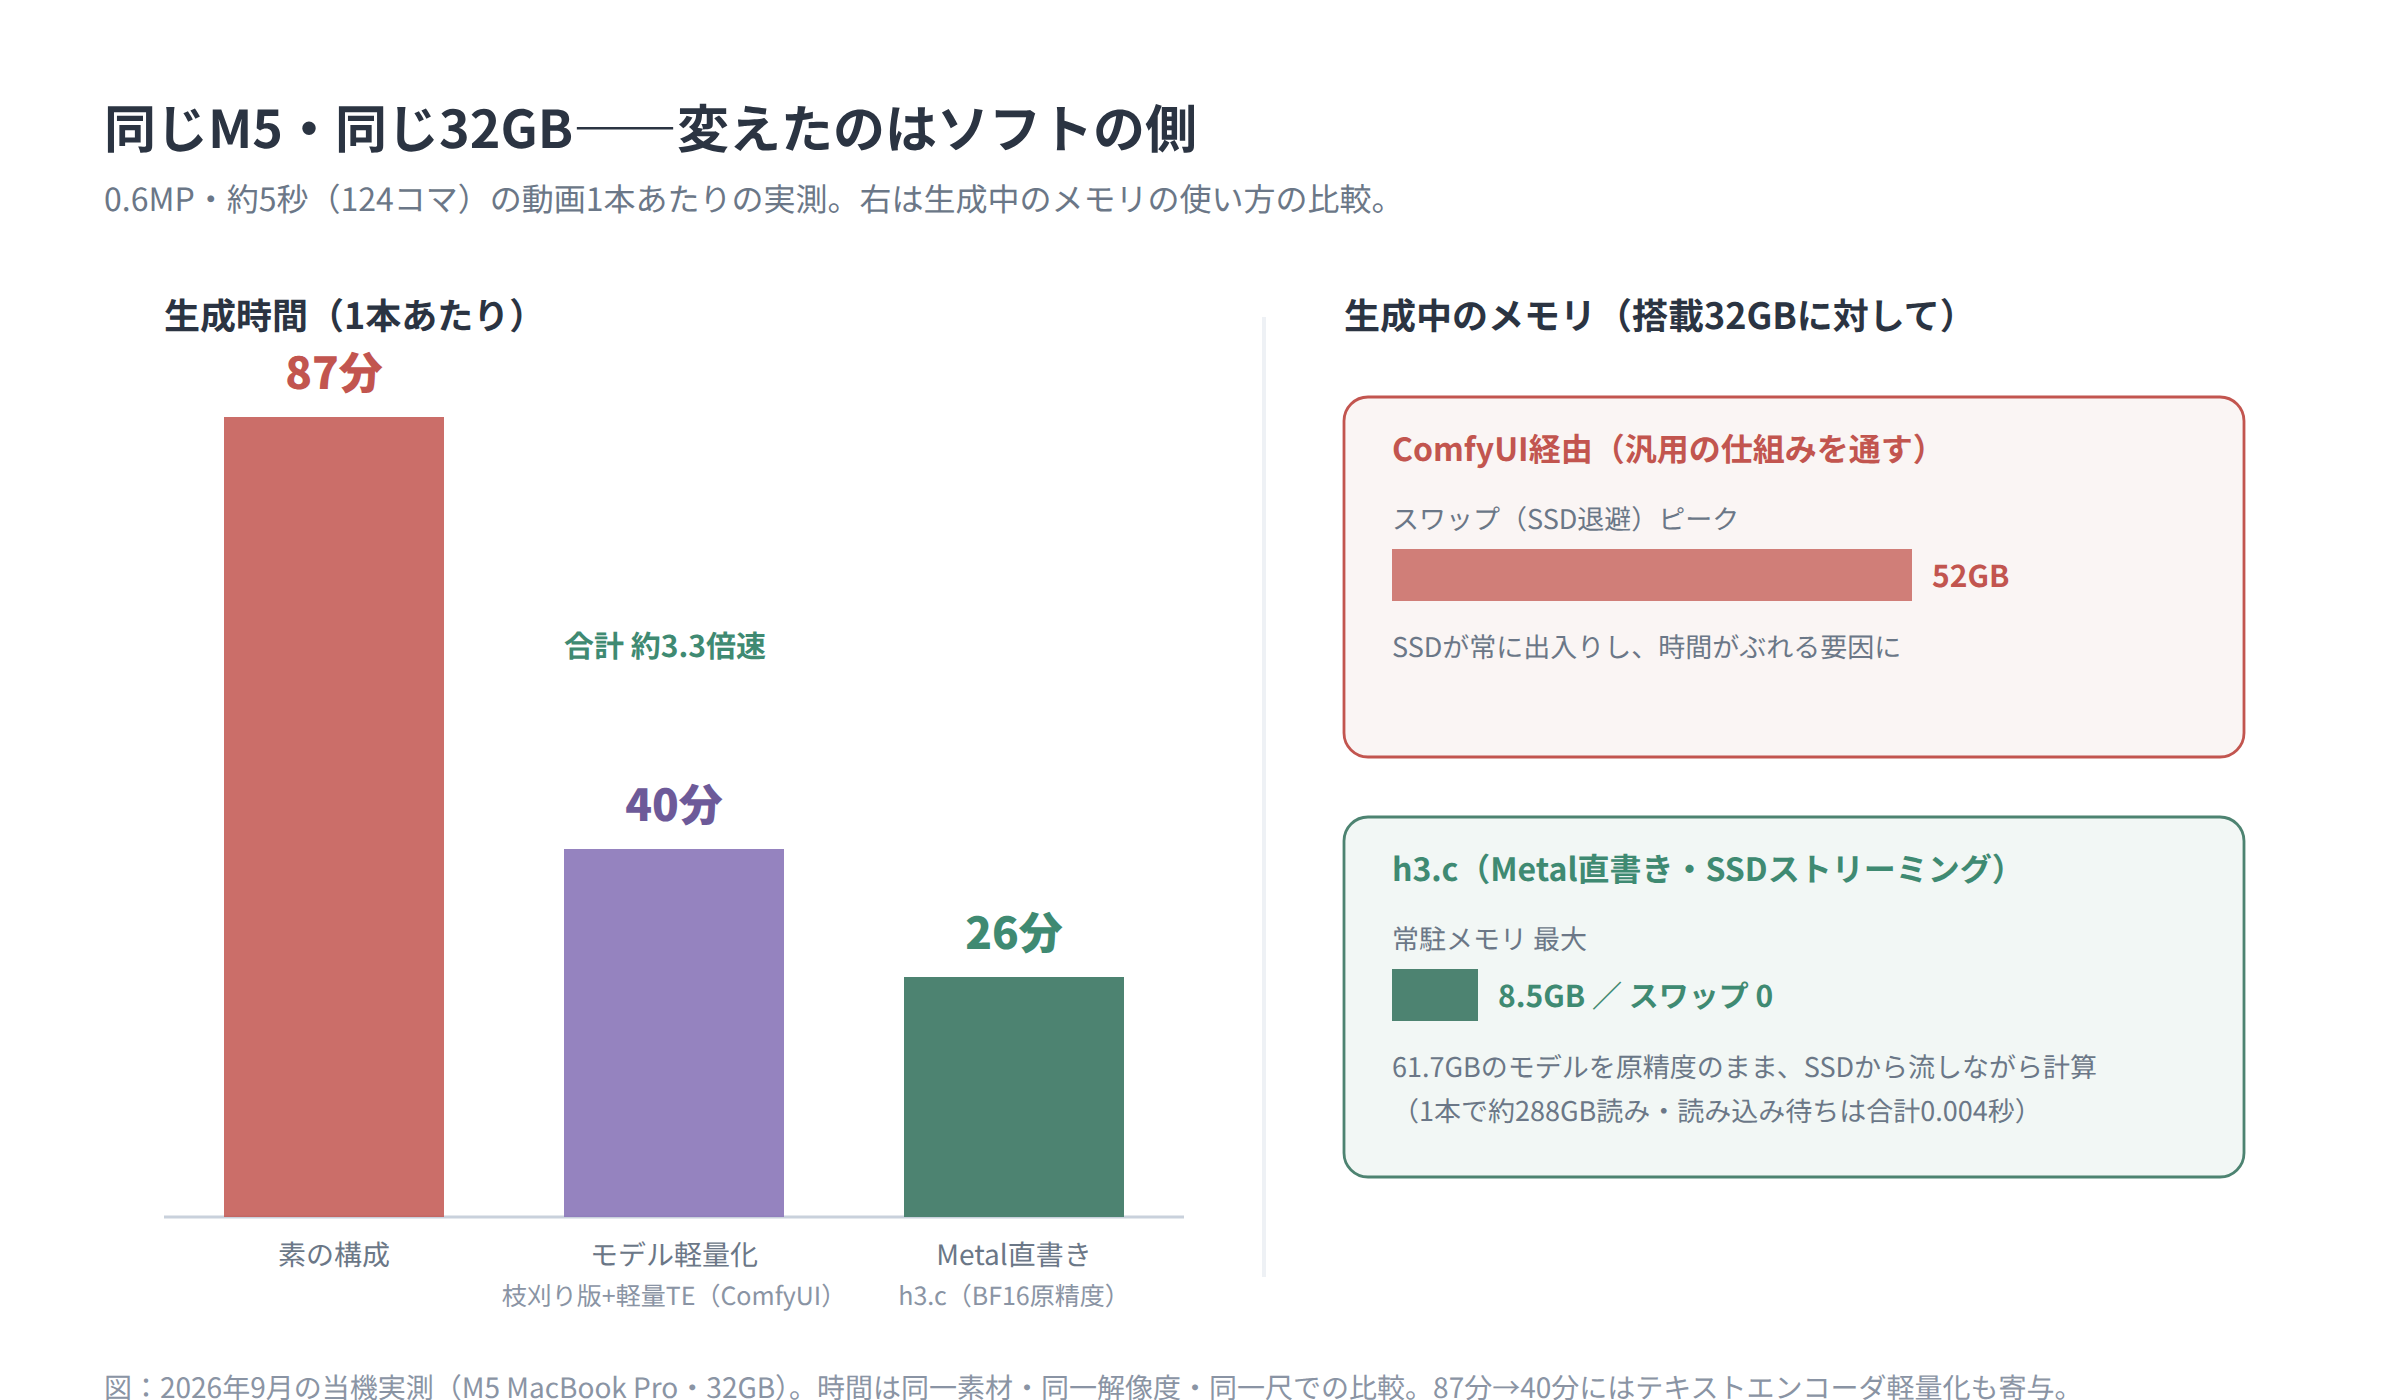
87分というのは、試行錯誤が成立しない時間です。静止画の連載で「$0だから数を打てる」と書きましたが、動画は1回の試行が1時間半では、数を打つ以前の話になる。彼女に本格的に動いてもらう前に、工房の改造が必要でした。今回はその記録です。結論の数字を先に書くと、87分→40分→26分。2つの改造でおよそ3.3倍速になりました。
改造①:モデルを「枝刈り」版に替える——ただし検証してから
最初の改造はモデルの差し替えです。使っている動画モデル(MiniMax-H3)には、コミュニティが公開している枝刈り(Pruned)版があります。学習済みモデルから寄与の小さい部分を削ってファイルを小さくしたもので、当方の量子化版で18.5GBだった拡散本体が10.8GBまで縮みます。
ただし「軽い」は「劣化している」と隣り合わせです。そこでこのサイトの流儀どおり、採用前にA/B検証をしました。設計は厳密にしています。2つの生成の差分が「モデルファイル1点だけ」になるよう機械照合で担保し、seedを固定して同一条件で焼き比べる。
結果は意外なほど良好でした。同一フレームの画素差は平均0.45/255、差が出た画素は0.23%で、しかも差の出た位置は人物の描き直し範囲に限定(背景は不変)。目視では識別不能です。その上で、生成の中核(サンプラー)が31%速くなり、常駐メモリが8.1GB減った。先行して導入していたテキストエンコーダの軽量版と合わせて、総所要は87分から40分へ。
教訓をひとつ。「枝刈り=劣化」という先入観は、この件に関しては外れでした。ただしそれは測ったから言えることで、測らずに採用していたら、後で画質問題が出たときにどの変更が犯人か分からなくなっていたはずです。
改造②:ComfyUIの外に出る
40分でもまだ長い。次の改造は、より思い切ったものでした。ComfyUIから出るのです。
この連載でComfyUIを「作業台」として使ってきましたが、Macにおける弱点も見えていました。ComfyUIの計算はPyTorchという汎用の仕組みを通ってGPUに届くため、Apple Silicon(Metal)向けの最適化には限界がある。実際、40分の生成の裏ではスワップ(メモリからあふれた分のSSD退避)が52GBまで膨らんでいました。
そこで導入したのが、Metal直書きのオープンソース推論エンジン「h3.c」です。依存はmacOS標準のフレームワークだけ。pipもbrewも要らず、ソースからのビルドは数秒で終わる。Apple Siliconのためだけに書かれた実装です。
驚くのはメモリの扱いでした。このエンジンは量子化に頼りません。モデルを原精度(BF16)のまま、SSDから流しながら計算します。生成1本の間にSSDから読んだ量は約288GB——それだけ読んでいながら、読み込み待ちは合計0.004秒。計算の裏に読み込みを完全に隠しているのです。結果、61.7GBのモデルが32GBのMacで動き、常駐メモリは最大8.5GB・スワップはゼロ。ComfyUI経由の「スワップ52GB」と同じマシンとは思えない数字です。
所要時間は、同一素材・同一解像度・同一尺の比較で26分04秒(ComfyUI経由は40分03秒)。連載第1回で「32GBのMacに40GBが載ってスワップが暴れる」と書いたことを思い出すと、同じハードでも、ソフトの書き方ひとつでここまで変わるというのが今回いちばんの発見でした。
改造③:外に出た道具を、作業台に戻す
ComfyUIの外に出たと書きましたが、出っぱなしでは困ります。コマンドラインの道具は、ワークフローとして残せないからです。
そこで、h3.cを呼び出すComfyUI用の自作ノード(182行)を書きました。これでComfyUIの画面から、h3.cでの生成→フレーム補間→拡大までを1つのグラフとして流せます。速さはネイティブ実装から、再現性と組み合わせの自由はComfyUIから。両取りです。
副産物として、試行の回転も上がりました。「当たり取り」——構図やプロンプトの方向性だけ確かめる低解像度・短尺の試し焼き——なら1本約100秒。87分時代には不可能だった「まず10本焼いて方向を選ぶ」が現実的になりました。
設計思想:前段は速く、後段で仕上げる
改造を通じて、運用の型もひとつ定まりました。二段構えです。
前段(生成)は軽く・速く回して当たりを取る。仕上げの品質は後段——フレーム補間と拡大——で作る。この分業には実測の裏づけがあります。生成時間はステップ数にほぼ厳密に比例する一方、メモリはステップ数に依存しない。つまり前段を軽くすることに副作用がない。そして動画のカクつきの主因を調べたところ、生成AIが内部で時間方向を圧縮していることに由来する周期的なもので、前段のステップを増やしても緩和止まりと分かりました。ならば前段で無理をせず、後段の補間で均すのが合理的です。
正直な現状——速くなったが、完成ではない
事後検証の連載として、残っている問題も書いておきます。2つあります。ひとつは、長めの生成の終盤に背景へ紙吹雪のようなノイズが出ることがある(処理をタイル分割していることに由来する疑い。コミュニティでも既知の現象です)。もうひとつは、動きがまだ少しぎこちないこと(ステップ数由来の疑い)。どちらも原因の仮説と検証の計画までは立っており、続きはこの連載で報告します。
まとめ——道具は揃った
要点は3つです。第一に、モデルの軽量化は「測ってから」採用する。枝刈り版は今回、画質の劣化が検出できないまま31%の高速化をくれたが、それは検証したから安心して使える。第二に、汎用ツールが遅いとき、ハードのせいにする前に専用実装という選択肢がある。同じM5・同じ32GBで、スワップ52GBが8.5GBになった。第三に、速くした前段と仕上げの後段を分ける。品質を1か所で全部作ろうとしない。
87分が26分になり、試し焼きは100秒になりました。彼女に無茶をしてもらう準備が、ようやく整いました。次回、本番です。
本記事の数値は2026年9月時点の当方環境(MacBook Pro M5・ユニファイドメモリ32GB)での実測に基づきます。h3.cはオープンソースの実験的プロジェクトであり、仕様は変わり得ます。実施の際は最新の一次情報を確認してください。
コメント