前回の記事の末尾で、X(旧Twitter)に1人のキャラクターを載せました。白いチャイナドレスの彼女です。「近々、かなり無茶なことをしてもらう」と書きました。今回はその準備の話——彼女に「同じ顔のまま」動いてもらうための土台づくりです。
壁:動画AIは、同じ人物を保てない
動画生成AIで人物を動かすと、すぐにひとつの壁に当たります。尺が伸びるほど、カットが変わるほど、同じ人物ではなくなっていくのです。
これは印象論ではありません。当方の実測で、同じ設定・同じステップ数のまま生成時間だけ伸ばしたところ、先頭のコマからの乖離が、5秒動画→10秒動画で8倍になりました。生成ステップを増やしても改善しない。つまり計算量の問題ではなく、長くなるほど「最初に決めた人物」を維持できなくなるという、モデルの性質です。
カットをまたぐ場合はさらに顕著です。プロンプトで「同じ女性」と書いても、生成のたびに顔は変わります。文章というのは人物を特定するには曖昧すぎる記述形式で、「20代の日本人女性、黒髪」に該当する顔は無限にあるからです。
解:キャラクターシート——文章ではなく「絵」で人物を固定する
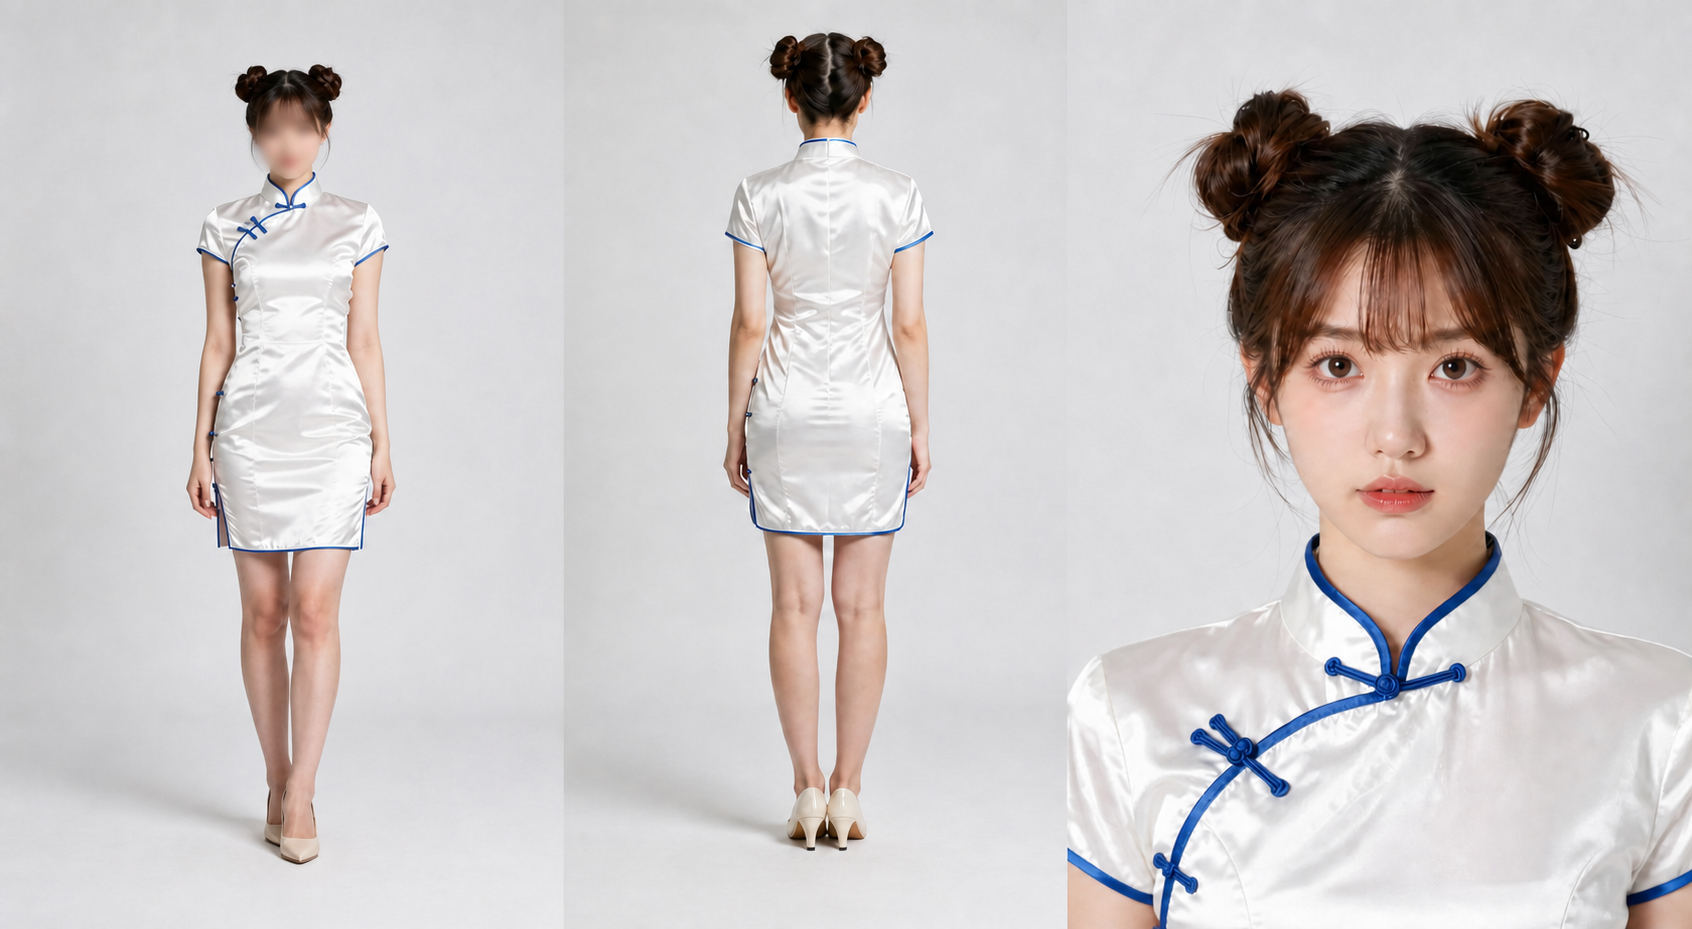
この壁への実務的な足場がキャラクターシートです。アニメ制作の設定画と同じ発想で、同一人物を役割別に固めた参照画像のセットを先に作っておき、以後の生成はすべてこのシートを基準にします。
構成は3面。正面の全身(体型と衣装の情報)、背面の全身(後ろ姿の情報——動画では人物は振り向くので、背面の情報がないとそこで破綻します)、そして顔のアップ(同一性の本体)。正面パネルの顔をあえてぼかしてあるのは、顔の情報は顔パネルに一本化するためです。それぞれのパネルに「その役割の情報だけを濃く」持たせる。
作り方は、前回作った$0の作業台がそのまま使えます。ローカルのStable Diffusionで人物を出し、気に入った1枚が出たらseedを固定して確定する。正面が決まったら、同じ人物の背面と顔アップを詰めていく。課金がないので、納得するまで何十枚でも回せます——前回書いた「数を打って選抜する」働かせ方が、ここで最も効きます。
ひとつ実務的な補足を。3枚の画像を1枚のシートにレイアウトする作業は、画像生成ではなく編集の仕事です。当方はここで道具を替え、3枚をChatGPTに渡してシートに組んでもらいました。生成はSD、組版は対話AI。それぞれ得意な工程だけをやらせる分業です。1枚に組んでおく利点は管理にあります。人物の全情報が1ファイルに収まり、バージョン管理も受け渡しも「この1枚」で済む。
失敗:シートを丸ごと渡したら、別人が出た
ここからが今回の本題の失敗談です。
キャラシートができたので、これを参照画像として生成AIに渡せば同じ人物が出るはず——と考えて、シートを丸ごと1枚渡しました。結果は別人でした。彼女に似てはいるが、彼女ではない誰かが出てくる。
原因を調べると、仕組みの問題でした。画像を参照する系のAIは、渡された画像を「1枚の絵」として符号化します。3面図を丸ごと渡すと、AIが受け取るのは「白い背景に人物が3体並んだ図版」という絵です。このとき、同一性の本体であるはずの顔は、画像全体のうち数十ピクセルしか占めていない。顔の情報が符号化の段階で痩せてしまい、「誰であるか」が伝わらないのです。
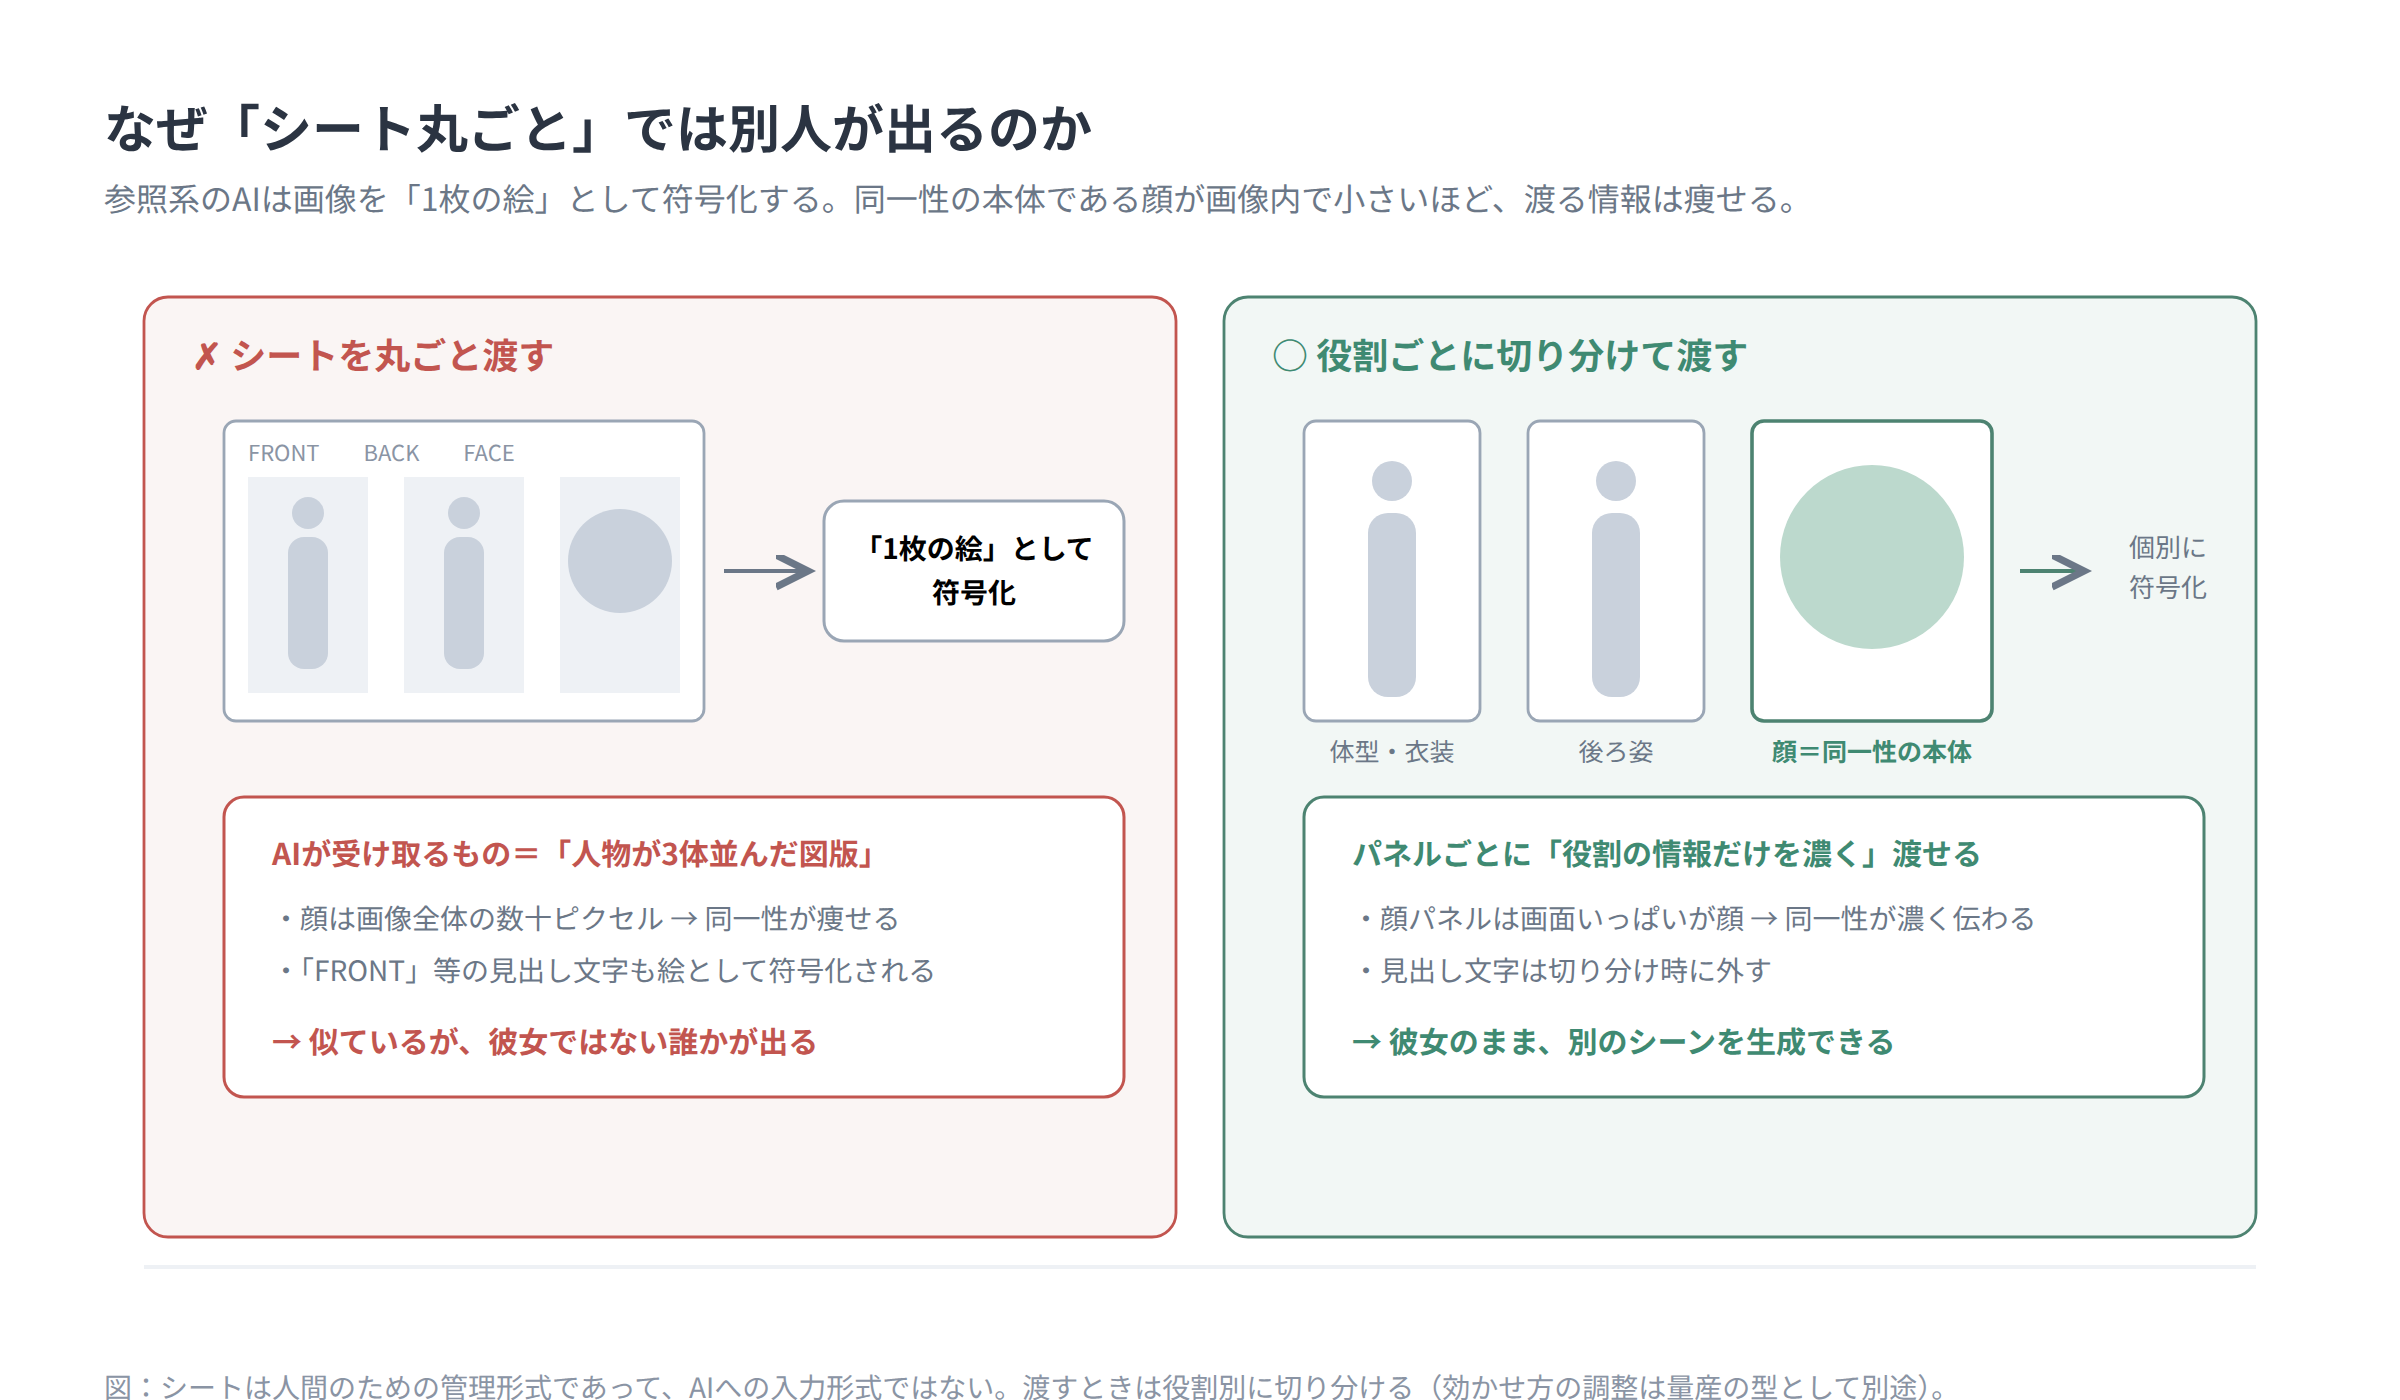
さらに、効きを強めて解決しようとすると別の事故が起きます。参照を強くしすぎると、シートに入れていた見出しの文字まで「絵の一部」として転写される。「FRONT」という文字が背景に浮かぶ生成画像は、なかなか味わい深いものでした。
教訓はシンプルです。シートは人間のための管理形式であって、AIに渡す入力形式ではない。AIに渡すときは、役割ごとのパネルに切り分けて、必要な情報だけを濃い状態で渡す必要があります。どのパネルをどんな強さで効かせるか——ここには「参照の効き」を調整するダイヤルがあり、その調整を誤ると「同じ絵しか出ない」か「別人が出る」かの両極に振れます。この調整の実際は、量産の型として別途まとめる予定です。
動画への渡し口は2つある
シートから切り出した画像を動画生成AI(当方はMiniMax-H3)に渡すとき、入口は2つあります。
first_frameは「この画から動き出せ」という指定です。渡した画像がそのまま動画の1コマ目になるので、構図・照明・衣装まで完全に固定されます。reference_imageは「この見た目を踏襲しろ」という指定で、構図は自由なまま、人物の見た目だけを寄せます。1カット目はfirst_frameで確実に立ち上げ、以降のカットはreference_imageで展開する——という使い分けが基本形になります。
ここで前回までの話が全部つながります。静止画側($0)でキャラシートを作り、シートからキーフレームを詰め、課金される動画側は、確度が高い状態で1回だけ回す。無料の工程で不確実性を潰しきってから、有料の工程に入る。この連載で作ってきた環境は、すべてこの一手のためにありました。
まとめ——次回、彼女が動きます
要点は3つです。第一に、動画AIの一貫性は、プロンプト(文章)では守れない。人物の固定は絵で行う——それがキャラクターシート。第二に、シートは正面・背面・顔の役割別に作り、顔の情報は顔パネルに集中させる。作る過程はseed固定と数打ちで、$0の環境が最も活きる工程。第三に、シートは管理のための形式であって入力形式ではない。丸ごと渡すと顔情報が痩せて別人が出る。
土台はできました。次回、彼女に動いてもらいます。冒頭で予告した「かなり無茶なこと」の中身も、そこで明かします。
本記事は2026年8〜9月時点の当方環境(MacBook Pro M5・32GB / ローカルStable Diffusion+ComfyUI / MiniMax-H3)での検証記録に基づきます。本記事中の人物画像はすべてAIによる生成物です。
コメント